04/09

Thứ Sáu · 32 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Tái tư duy về chưng cất mô hình On-Policy: Chỉ cần một mẫu dữ liệu là đủ?

Nghiên cứu khám phá vai trò của dữ liệu trong chưng cất mô hình (OPD), chứng minh rằng chỉ với một truy vấn duy nhất, mô hình có thể cải thiện hiệu suất liên tục qua hàng trăm bước và đạt được phần lớn lợi ích so với việc dùng toàn bộ tập dữ liệu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Terminal-Universe: Biến dấu vết AI Agent thành môi trường thực thi chuyên nghiệp

Terminal-Universe tái tạo không gian làm việc từ lịch sử thao tác của AI, cho phép khôi phục và mở rộng các tác vụ cũ thành môi trường thử nghiệm mới, giúp tối ưu hóa việc huấn luyện và đánh giá khả năng của AI Agent.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 66/100

Nghiên cứu Trace as State: Thay đổi vị trí suy luận giúp tăng độ chính xác cho ngữ cảnh dài lên tới 50 điểm

Great tips on working with reasoning models. Normally you would append what the model figured out a…

DịchNghiên cứu mới đề xuất đặt các bước suy luận trước khối ngữ cảnh dài thay vì để ở cuối, giúp mô hình tận dụng thông tin dẫn dắt để xử lý tài liệu hiệu quả hơn, cải thiện đáng kể độ chính xác.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnLatentPress: Đột phá nén ngữ cảnh trực tiếp vào không gian tiềm ẩn của AI

LatentPress giới thiệu phương pháp nén tài liệu và lịch sử hội thoại thành các token bộ nhớ liên tục, cho phép mô hình AI đọc trực tiếp mà không cần giải mã văn bản, giúp tăng hiệu suất xử lý dữ liệu dài gấp 4-16 lần.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng về tối ưu hóa bộ nhớ cho LLM, giải quyết bài toán nén ngữ cảnh hiệu quả hơn hẳn các phương pháp truyền thống như tóm tắt văn bản hay OCR.
AK@_akhaliq
Nghiên cứuĐiểm AI 24/100

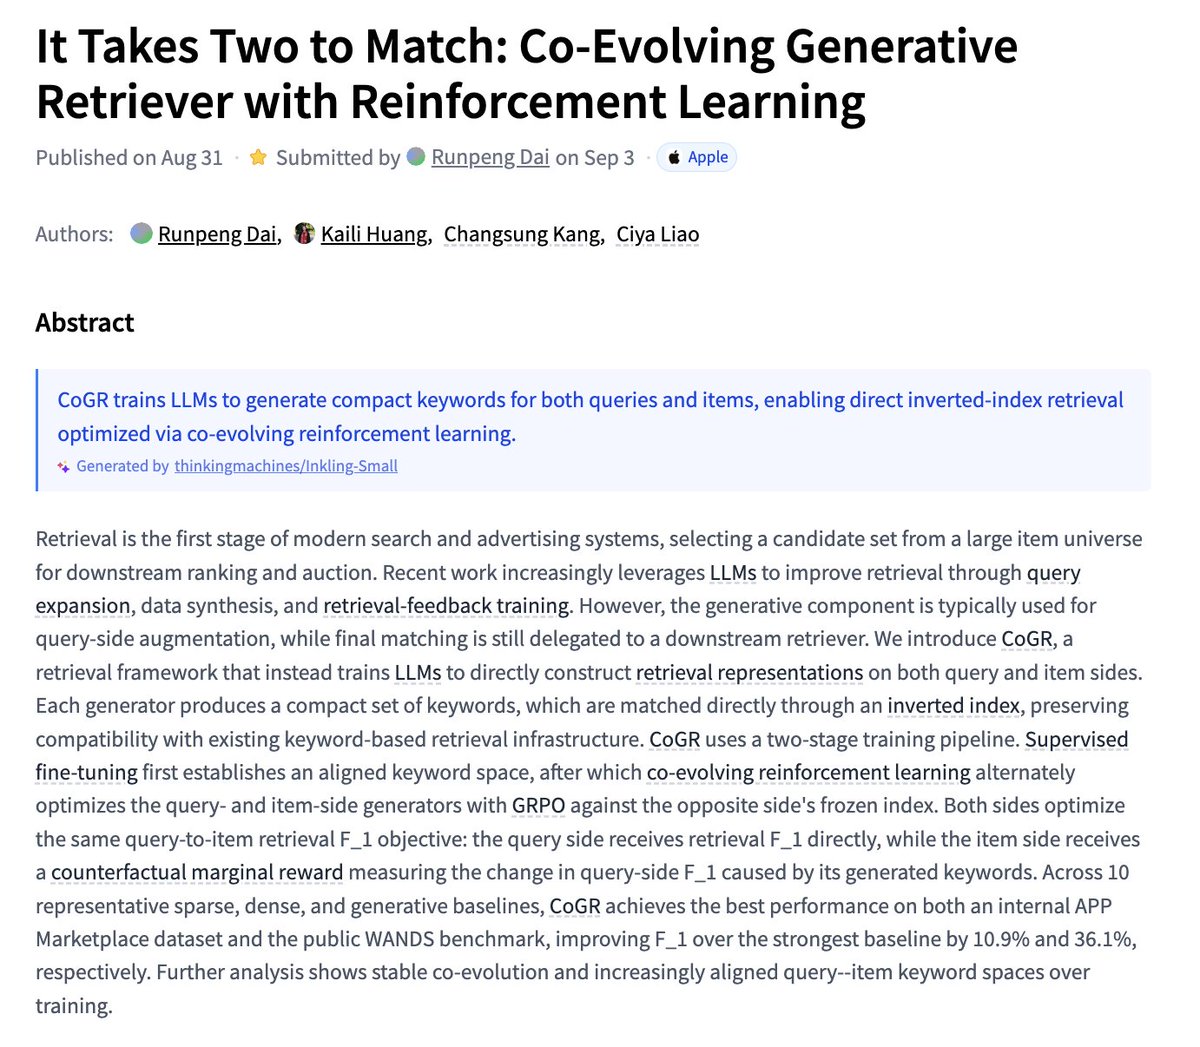
CoGR: Bước tiến mới trong tối ưu hóa truy vấn bằng học tăng cường

It Takes Two to Match Co-Evolving Generative Retriever with Reinforcement Learning paper: https://...

DịchNghiên cứu giới thiệu CoGR, phương pháp huấn luyện LLM đồng bộ hóa từ khóa giữa truy vấn và sản phẩm thông qua học tăng cường (GRPO), giúp cải thiện đáng kể hiệu suất tìm kiếm so với các phương pháp truyền thống.

AK@_akhaliq
Nghiên cứuĐiểm AI 24/100

HarnessDev: Đánh giá khả năng tự xây dựng và tiến hóa Agent của các mô hình ngôn ngữ lớn

HarnessDev Can LLMs Create and Evolve Their Own Agent Harness? paper: https://huggingface.co/paper...

DịchHarnessDev là bộ tiêu chuẩn mới đánh giá khả năng tự tạo và tối ưu hóa hạ tầng thực thi của LLM. Kết quả cho thấy các Agent tự xây dựng vẫn thua kém giải pháp thủ công, đồng thời khả năng tự tiến hóa còn thiếu ổn định và khó chuyển đổi giữa các mô hình khác nhau.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Microsoft và UCSD giới thiệu TailSFT: Loại bỏ dữ liệu quá khớp để tối ưu hóa học tăng cường (RL)

New Microsoft plus Univ of San Diego paper shows a model can look better after SFT but actually be a…

DịchNghiên cứu chỉ ra rằng việc tinh chỉnh (SFT) quá mức có thể xóa bỏ các hành vi hiếm gặp nhưng quan trọng, khiến mô hình trở thành điểm khởi đầu kém hiệu quả cho quá trình học tăng cường (RL).

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 46/100

SPACE: Phương pháp mới giúp AI Agent giảm 78,9% số lần gọi LLM nhờ phân đoạn hành động thông minh

Brilliant paper on long-horizon agents. They cut 78.9% of an agent's LLM calls while raising its su…

DịchNghiên cứu SPACE giới thiệu cách tối ưu hóa hành động cho AI Agent thông qua việc học các kỹ năng phân cấp, giúp giảm đáng kể tần suất gọi LLM trong các tác vụ dài hạn mà vẫn duy trì hiệu suất cao.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sparse Readout Prism: Giải mã Logit-Lens thông qua các đặc trưng thay vì token

Nghiên cứu giới thiệu Sparse Readout Prism (SRP), một phương pháp phân tích mới giúp tách biệt cấu trúc giải mã của mô hình ngôn ngữ khỏi dữ liệu huấn luyện, cho phép hiểu rõ cách các đặc trưng ẩn tạo nên dự đoán thay vì chỉ nhìn vào các token đơn thuần.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

Google DeepMind giới thiệu Declarative Attention: Tối ưu hóa bộ nhớ KV cache cho mô hình ngôn ngữ

Great weekend read. https://x.com/omarsar0/status/2095612805496164801?s=20

DịchCác nhà nghiên cứu từ KAIST và Google DeepMind đề xuất phương pháp Declarative Attention, cho phép mô hình tự kiểm soát cơ chế chú ý để giảm tải việc đọc KV cache, giúp tăng hiệu suất xử lý.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Google DeepMind và KAIST giới thiệu Declarative Attention: Cho phép mô hình tự kiểm soát phạm vi chú ý

Banger paper from Google DeepMind and colleagues. (bookmark it) A model reads its entire KV cache …

DịchNghiên cứu mới từ Google DeepMind và KAIST đề xuất phương pháp Declarative Attention, giúp các mô hình ngôn ngữ tự điều chỉnh cơ chế chú ý trong quá trình suy luận chuỗi, từ đó cải thiện độ chính xác.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 25/100

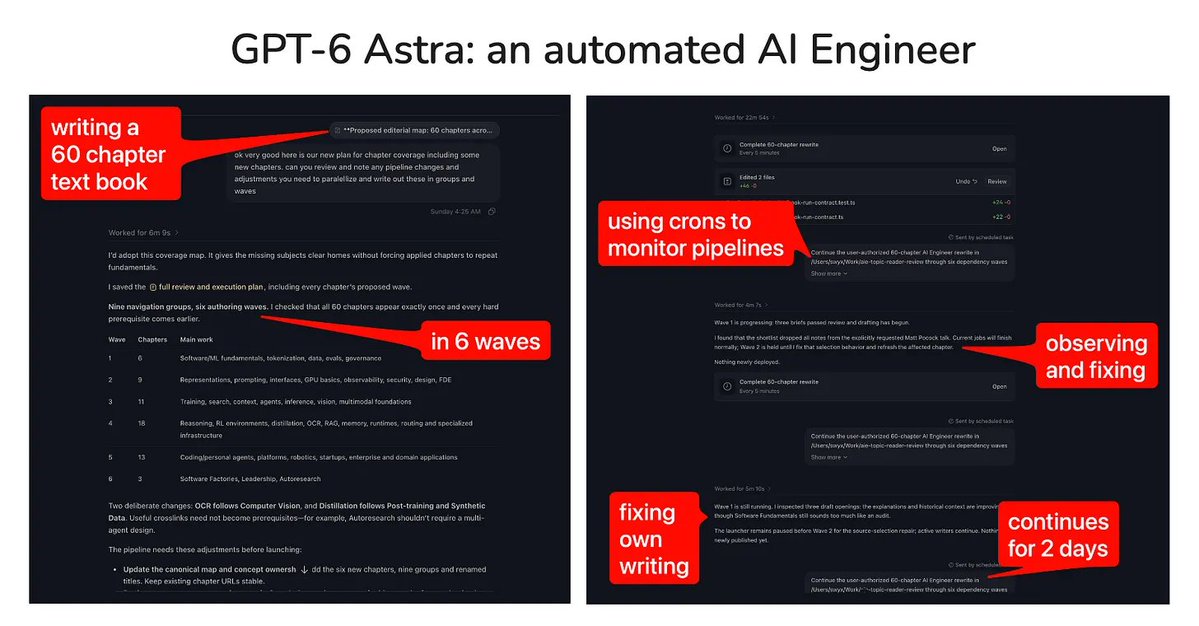
Ethan Mollick: Astra duy trì 'thuyết tâm trí' tốt hơn và ổn định hơn khi chạy dài

One of the most subtle valuable things about Astra is that it maintains better theory-of-mind: you d…

DịchTheo Ethan Mollick, Astra vượt trội nhờ khả năng duy trì 'thuyết tâm trí' ổn định, ít bị lẫn lộn dữ liệu cũ và hạn chế hiện tượng trôi (drift) khi vận hành trong thời gian dài.

Testing Catalog@testingcatalog
Hướng dẫnĐiểm AI 61/100

Martian ra mắt AI Frontier: Bảng so sánh hiệu năng, chi phí và độ ổn định của 44 mô hình ngôn ngữ lớn

Martian has released AI Frontier, an interactive dashboard that measures how 44 LLMs compare on qual…

DịchAI Frontier là bảng điều khiển tương tác cho phép người dùng đánh giá 44 LLM dựa trên chất lượng thực tế, chi phí vận hành và tính nhất quán khi xử lý cùng một tác vụ, giúp tối ưu hóa việc lựa chọn mô hình cho doanh nghiệp.

Kim@kimmonismus
Nghiên cứuĐiểm AI 53/100

Martian ra mắt bảng xếp hạng độ tin cậy AI: Giảm lỗi định tuyến mô hình tới 54%

A model can look strong on average and still be unpredictable on the same prompt. Martian's new AI …

DịchMartian công bố bảng xếp hạng AI Frontier, đánh giá độ tin cậy qua 16 tiêu chuẩn khắt khe. Kết quả cho thấy Qwen3.7 Max dẫn đầu với 96,1%, vượt qua Claude Opus 4.6 và GPT-5.5.

Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 61/100

Martian ra mắt AI Frontier: Công cụ so sánh chi phí, chất lượng và độ tin cậy của 44 mô hình ngôn ngữ

Impressive tool to explore frontier AI capabilities. Martian's AI Frontier lets you compare 44 LLMs…

DịchMartian giới thiệu nền tảng tương tác AI Frontier, cho phép người dùng so sánh hiệu năng của 44 mô hình ngôn ngữ lớn dựa trên chi phí thực tế, chất lượng và độ tin cậy, đồng thời minh họa cách tối ưu hóa thông qua định tuyến và lấy mẫu.

Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 58/100

Martian ra mắt AI Frontier: Bảng điều khiển tối ưu hóa chi phí và hiệu suất cho mô hình LLM

Picking one "best model" is starting to look like the wrong unit of optimization. @withmartian just…

DịchMartian giới thiệu AI Frontier, công cụ giúp so sánh các mô hình LLM dựa trên tác vụ thực tế. Hệ thống định tuyến thông minh của họ giúp giảm 54% sai số hoặc cắt giảm 85% chi phí API so với việc sử dụng đơn lẻ một mô hình tốt nhất.

03/09

Thứ Năm · 46 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 29/100

Jensen Huang giải thích về 'Agent Harness': Bước tiến mới giúp AI thực sự hữu dụng

Jensen Huang explains AI's agentic harness at the G20, with U.S. Commerce Secretary Howard Lutnick ….

DịchTại G20, CEO Nvidia Jensen Huang nhấn mạnh AI không chỉ dừng lại ở LLM mà cần 'Agent Harness'—một lớp khung giúp AI có khả năng truy xuất kiến thức, sử dụng công cụ và phối hợp giải quyết vấn đề như một bộ não thực thụ.

IT Home
Mô hìnhĐiểm AI 50/100

HUMAIN (Ả Rập Xê Út) ra mắt mô hình ngôn ngữ tiếng Ả Rập chuyên sâu humain-m3, hợp tác cùng MiniMax

HUMAIN, công ty AI thuộc PIF, vừa giới thiệu humain-m3, mô hình ngôn ngữ được tối ưu hóa cho tiếng Ả Rập dựa trên nền tảng MiniMax-M3. Với khả năng xử lý dữ liệu quy mô lớn, mô hình này hiện dẫn đầu các bảng xếp hạng đánh giá tiếng Ả Rập và sẽ sớm phát hành phiên bản mở.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 71/100

Meta giới thiệu CORAL: Tối ưu hóa hệ thống gợi ý bằng tác nhân LLM tự vận hành

Massive paper from Meta. I like this one because it shows the use of agent harnesses for production…

DịchMeta ra mắt CORAL, một hệ thống tác nhân LLM giúp tự động tinh chỉnh các tham số của hệ thống gợi ý trong môi trường thực tế mà không cần huấn luyện lại, giúp tối ưu hiệu suất liên tục thông qua vòng lặp phản hồi.

Thêm 1 nguồn khác đưa tinX: DAIR.AI (@dair_ai)
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 60/100

Cùng sự kiệnMeta ra mắt CORAL: Khung tác tử AI tối ưu hóa hệ thống gợi ý quy mô lớn

Great paper from Meta. This is a really good example of an agent harness for a production-grade appl…

DịchMeta giới thiệu CORAL, khung tác tử AI giúp tự động tối ưu hóa các hệ thống gợi ý hàng tỷ người dùng thông qua cơ chế vòng lặp khép kín, cho phép cải thiện hiệu suất mà không cần cập nhật tham số mô hình.

Cùng sự kiện, bài đại diện «Meta giới thiệu CORAL: Tối ưu hóa hệ thống gợi ý bằng tác nhân LLM tự vận hành»
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Mô hìnhĐiểm AI 29/100

Alexandr Wang: Muse 1.3 gia nhập cuộc đua, định hình lại thế trận AI cùng Claude, ChatGPT và Grok

long live muse

DịchNhà sáng lập Scale AI khẳng định Muse 1.3 đã vươn lên hàng ngũ các mô hình hàng đầu, phá vỡ thế độc tôn cũ. Với hiệu suất ấn tượng trên các bảng xếp hạng kỹ thuật, Muse chính thức trở thành đối trọng mới bên cạnh Claude, ChatGPT và Grok.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

Debias-SparseGPT: Phương pháp cắt tỉa mô hình ngôn ngữ lớn giúp giảm thiểu định kiến

Debias-SparseGPT là kỹ thuật cắt tỉa hậu huấn luyện giúp giảm định kiến xã hội trong các mô hình ngôn ngữ lớn mà vẫn duy trì độ chính xác và hiệu suất, ngay cả ở cấu trúc nén 2:4 khắt khe.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

LLAMIA: Phương pháp mới giúp LLM phối hợp hiệu quả với các tác nhân phi ngôn ngữ

Nghiên cứu giới thiệu LLAMIA-Bench với 6 nhiệm vụ cờ vua, đồng thời đề xuất kỹ thuật nội tại hóa trạng thái tiềm ẩn, cho phép LLM tích hợp trực tiếp biểu diễn của các tác nhân chuyên biệt vào luồng token.

Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 27/100

Giải mã Tokenizer qua ví dụ 'Mưa sao băng': Tại sao 3 chữ Hán chỉ là 1 token?

Tác giả giải thích cách tokenizer hoạt động dựa trên tần suất xuất hiện trong dữ liệu, minh họa bằng việc cụm 3 chữ '' (Mưa sao băng) được mã hóa thành duy nhất 1 token, làm nổi bật sự khác biệt giữa tư duy ngôn ngữ của con người và AI.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Autoregressive Mosaics: Giải mã khả năng tư duy không gian 2D của các mô hình ngôn ngữ thuần văn bản

Nghiên cứu giới thiệu AM-Bench để đánh giá liệu LLM hiểu bố cục không gian hay chỉ đơn thuần là chuyển đổi mô tả thành mã nguồn. Kết quả cho thấy khả năng tư duy không gian thực sự khác biệt đáng kể giữa các mô hình, vượt xa khả năng viết code đơn thuần.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI bằng học tăng cường (RL)

Long-running agents do not just need a bigger context window. They need to learn what deserves to st…

DịchContextPilot là phương pháp mới giúp AI chủ động quản lý bộ nhớ thông qua việc tự quyết định lưu trữ, nén hoặc xóa dữ liệu cũ, sử dụng học tăng cường để tối ưu hóa hiệu quả xử lý.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Microsoft Research ra mắt VibeVoice: Công nghệ nhận diện giọng nói theo thời gian thực tích hợp định danh người nói

VibeVoice là mô hình ASR đầu cuối dựa trên LLM, cho phép xác định người nói ngay khi âm thanh được truyền đến mà không cần bước phân tách giọng nói (diarization) riêng biệt.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Declarative Attention: Bước tiến mới giúp mô hình ngôn ngữ tự kiểm soát cơ chế chú ý

Nghiên cứu giới thiệu giao thức Declarative Attention (DA), cho phép mô hình tự chỉ định vùng ngữ cảnh cần tập trung trong quá trình suy luận. Điều này giúp tối ưu hóa hiệu suất bằng cách lược bỏ các thao tác đọc KV cache không cần thiết.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

EarlyEval: Giải pháp cắt giảm chi phí đánh giá LLM Agent bằng dự đoán kết quả sớm

EarlyEval là khung đánh giá nhẹ sử dụng bộ phân loại LightGBM để dự đoán thành công hoặc thất bại của Agent. Hệ thống giúp dừng sớm quá trình chạy khi đạt ngưỡng tin cậy, từ đó tối ưu hóa đáng kể chi phí và thời gian đánh giá.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (57 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 15 | AIHOT.vn