18/08

Thứ Ba · 29 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

ClawGym II: Đột phá học tăng cường hộp đen cho tác nhân AI

Nghiên cứu giới thiệu khung học tăng cường hộp đen mới, giúp tối ưu hóa hiệu suất của các tác nhân AI như Qwen3 trên các môi trường phức tạp, cải thiện đáng kể tỷ lệ giải quyết tác vụ thực tế.

Boris Cherny@bcherny
Sản phẩmĐiểm AI 30/100

Claude Code CLI tối ưu hiệu năng: Giảm một nửa mức sử dụng CPU ở ngưỡng p99

Small quality of life improvements like this add up. More on the way

DịchBằng cách điều chỉnh cơ chế thu gom rác của Bun để chỉ chạy khi tiến trình rảnh rỗi, Claude Code CLI đã giảm đáng kể mức tiêu thụ CPU ở ngưỡng p99, giúp trải nghiệm người dùng mượt mà hơn.

Claude Devs@ClaudeDevs
Sản phẩmĐiểm AI 42/100

Claude Code CLI tối ưu hóa hiệu năng: Giảm 50% mức sử dụng CPU

Perf win of the day: Claude Code CLI now uses 2x less CPU at p99. Bun's garbage collector was runni…

DịchClaude Code CLI vừa cập nhật cơ chế quản lý bộ nhớ, chuyển việc dọn dẹp rác (GC) sang thời điểm nhàn rỗi thay vì chạy theo lịch trình cố định, giúp giảm một nửa mức tiêu thụ CPU trong các tác vụ nặng.

Thêm 1 nguồn khác đưa tinX: Boris Cherny (@bcherny)
Aravind Srinivas (Perplexity CEO)@AravSrinivas
Hướng dẫnĐiểm AI 15/100

Bước đột phá: Chạy mô hình AI dày đặc (dense model) cục bộ với tốc độ kinh ngạc

Dense models are slow to run on local hardware, but this is incredible and a sign of things to come …

DịchViệc các mô hình AI phức tạp chạy mượt mà trên phần cứng cá nhân đang trở thành hiện thực, mở ra xu hướng mới cho tương lai của AI cục bộ.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

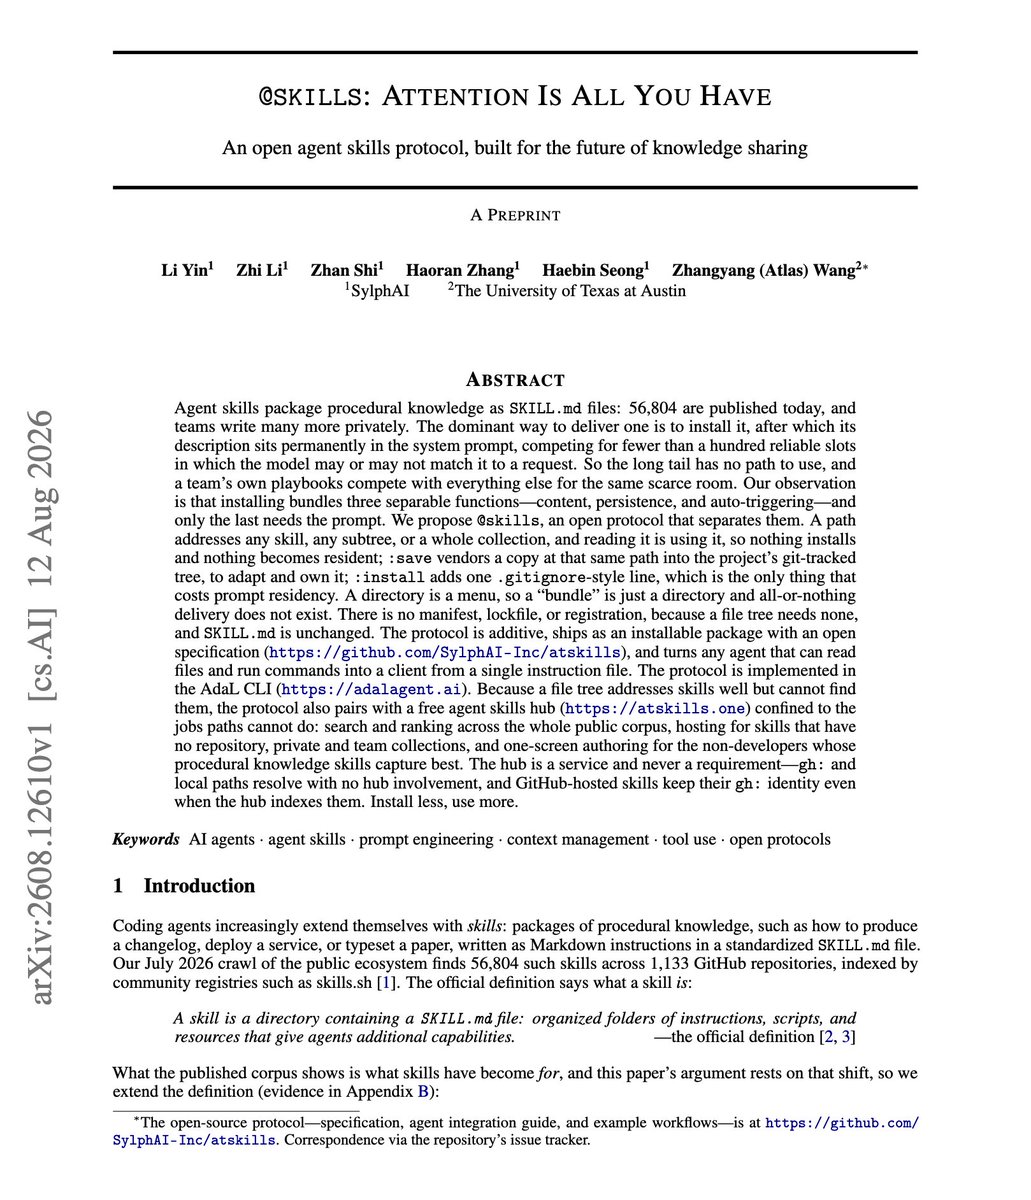
Hệ sinh thái kỹ năng AI: Hơn 56.000 kỹ năng tranh giành chưa đầy 100 vị trí kích hoạt

Recommended paper for agent skill builders. There are 56, 804 public agent skills today, all competi…

DịchNghiên cứu chỉ ra sự quá tải khi hàng chục nghìn kỹ năng AI cùng tranh giành không gian trong prompt hệ thống. Giải pháp đề xuất là tách biệt nội dung và cơ chế kích hoạt thông qua cấu trúc cây Git, giúp tối ưu hóa việc quản lý và triển khai kỹ năng mà không cần tệp cấu hình phức tạp.

Tomer Tunguz Blog (phân tích VC)
Hướng dẫnĐiểm AI 48/100

Khi AI tự học trong lúc chạy: Công nghệ Test-time Training thay đổi cuộc chơi về bộ nhớ và chi phí

Thay vì đóng băng trọng số sau khi huấn luyện, Test-time Training cho phép mô hình cập nhật liên tục khi sử dụng, giúp tăng tốc độ suy luận gấp 2.7 lần và mở rộng ngữ cảnh hiệu quả mà không cần huấn luyện lại.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tối ưu hóa Nanbeige4.2-3B trên Apple Silicon: Khắc phục lỗi triển khai và giảm tải bộ nhớ

Bài viết phân tích cách khắc phục các lỗi kỹ thuật khi chạy mô hình Nanbeige4.2-3B trên Apple Silicon và giới thiệu chiến lược 'chunked-prefill' giúp tăng gấp 2.7 lần độ dài ngữ cảnh bằng cách giảm tải bộ nhớ cho kiến trúc Looped Transformer.

17/08

Thứ Hai · 11 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐại học Bắc Kinh và StepFun ra mắt TensorCast: Giải pháp quản lý tensor thống nhất, giảm 93.2% độ trễ TTFT

TensorCast là lớp trừu tượng mới giúp quản lý vòng đời tensor (trọng số, KV Cache) một cách thống nhất, giải quyết tình trạng phân mảnh trong hạ tầng LLM hiện nay. Công nghệ này cho phép tối ưu hóa hiệu suất vượt trội, đặc biệt giảm tới 93.2% độ trễ phản hồi đầu tiên (TTFT) cho các tác nhân AI.


Vì sao đáng đọc: Đây là một bước tiến quan trọng trong hạ tầng hệ thống LLM, giải quyết vấn đề thực tế về quản lý tài nguyên và hiệu suất, có giá trị cao cho cộng đồng kỹ thuật.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SimpleOPD: Phương pháp chưng cất mô hình tối ưu cho suy luận ngữ cảnh dài

SimpleOPD giải quyết các thách thức khi chuyển giao khả năng suy luận từ mô hình ngữ cảnh dài sang mô hình ngữ cảnh ngắn, thông qua việc đồng bộ hóa không gian văn bản và tối ưu hóa quá trình huấn luyện để tránh lỗi độ dài và mất ổn định.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

Kiến trúc mô hình ảnh hưởng thế nào đến khả năng xử lý ngữ cảnh dài của LLM?

Some architecture choices that make transformers cheaper or more stable also make them harder to ext…

DịchNghiên cứu trên 26 mô hình 7B cho thấy các lựa chọn kiến trúc như QK-norm hay Sliding Window khi kết hợp có thể làm suy giảm nghiêm trọng khả năng xử lý ngữ cảnh dài, dù các bài kiểm tra ngắn hạn không thể hiện rõ điều này.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu mới: Việc bổ sung kỹ năng cho AI Agent đôi khi lại làm giảm hiệu suất

Very timely paper. An agent skill can be completely relevant to the task and still make the agent wo…

DịchNghiên cứu thực nghiệm chỉ ra rằng ngay cả khi kỹ năng bổ sung hoàn toàn phù hợp với nhiệm vụ, chúng vẫn có thể khiến AI Agent hoạt động kém hiệu quả do lỗi thực thi hoặc quy trình xác thực dư thừa. Các nhà phát triển cần kiểm tra kỹ lưỡng và so sánh hiệu suất trước khi tích hợp kỹ năng mới.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnIntern-S2-Mobius: Mô hình nền tảng với kiến trúc tách biệt tri thức và suy luận

Intern-S2-Mobius giới thiệu kiến trúc Mobius-v0, tách biệt bộ nhớ tri thức và bộ suy luận để tối ưu hóa khả năng nén dữ liệu và tăng tốc độ suy luận gấp 4 lần so với các mô hình truyền thống.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong kiến trúc mô hình ngôn ngữ, giải quyết bài toán hiệu suất và suy luận, rất có giá trị cho cộng đồng nghiên cứu AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vượt xa điểm số: Đánh giá hệ thống các tác nhân AI trong nghiên cứu và phát triển dài hạn

Nghiên cứu đề xuất khung đánh giá mới để phân tích hành vi của các tác nhân AI trong các nhiệm vụ dài hạn, thay vì chỉ dựa vào kết quả cuối cùng. Kết quả cho thấy các mô hình hiện nay hoạt động giống công cụ tối ưu hóa kỹ thuật hơn là những nhà nghiên cứu tự chủ thực thụ.

16/08

Chủ Nhật · 4 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Phương pháp MDA giúp LLM đạt hiệu suất vượt trội chỉ với 8 lần thử nghiệm

LLMs can suggest scientific mechanisms, but this paper finds that letting the agent choose experimen…

DịchMDA tối ưu hóa LLM bằng cách tách biệt việc tạo giả thuyết và suy luận Bayes, giúp đạt độ chính xác tương đương Opus 4.7 chỉ với 8 lần thử nghiệm thay vì 41, với tỷ lệ thành công vượt trội 93% so với 31%.

AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 49/100

Đừng nhồi nhét mọi thứ vào AGENTS.md: Tại sao Skills là giải pháp tối ưu hơn?

Thay vì dồn hết dữ liệu vào AGENTS.md gây tốn token và khó quản lý, hãy sử dụng Skills để tải nội dung theo nhu cầu. Đây là cách tiếp cận thông minh giúp tối ưu hóa hiệu suất và khả năng bảo trì cho các luồng công việc phức tạp.

Dex Horthy (HumanLayer)@dexhorthy
Hướng dẫnĐiểm AI 21/100

Claude Opus 3.5 đạt tỷ lệ thành công 97% trong lập trình nhờ phong cách phản hồi mới

this guy gets it

DịchNgười dùng phát hiện phong cách phản hồi 'Attention-kind' giúp Claude Opus 3.5 tăng hiệu suất lập trình lên 97%, giảm 43% độ dài văn bản và tối ưu hóa tốc độ phản hồi đáng kể. Đây là minh chứng cho thấy việc thiết kế tương tác AI-người dùng (AHI) có thể thay đổi hoàn toàn hiệu quả công việc.

15/08

Thứ Bảy · 8 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Nghiên cứu Qwen2.5: Lấy mẫu lặp lại hiệu quả hơn tự phản tư trong suy luận toán học

If you're spending extra tokens making an LLM critique itself, this paper says a simpler move can be…

DịchNghiên cứu trên các mô hình Qwen2.5 cho thấy việc lấy mẫu lặp lại và chọn đáp án đa số mang lại hiệu quả cao hơn các phương pháp tự phản tư phức tạp khi cùng giới hạn số lượng token.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu mới: Cách prompt sai lầm khiến AI lập trình lãng phí tài nguyên tính toán

Really useful revelation on prompting coding agent in this paper. Your coding-agent prompt may be …

DịchNghiên cứu chỉ ra rằng việc yêu cầu AI lập trình cân nhắc nhiều phương án hoặc thêm các chỉ dẫn thừa thãi như "hãy chắc chắn tuyệt đối" làm tăng chi phí vận hành lên tới 18 lần mà không cải thiện tỷ lệ thành công.

AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 42/100

OpenAI tối ưu hóa giao diện: Tốc độ tải hội thoại tăng gấp 16 lần

OpenAI đã tối ưu hóa việc tải các đoạn hội thoại dài, giảm số lượng yêu cầu mạng và bộ nhớ JS đáng kể, giúp thời gian tải giảm từ 27 giây xuống còn 1,66 giây. Điều này cho thấy OpenAI đang tập trung giải quyết nút thắt hiệu năng từ phía client trong kỷ nguyên AI agent.

Kim@kimmonismus
Sản phẩmĐiểm AI 40/100

Codex sắp cập nhật lớn: Tốc độ tải hội thoại tăng gấp 16 lần

Hype: Codex is rolling out a major performance update next week that should make very long conversat…

DịchCodex chuẩn bị tung bản cập nhật giúp tối ưu hóa đáng kể tốc độ tải các đoạn hội thoại dài, giảm thiểu bộ nhớ và số lượng yêu cầu. Trong thử nghiệm thực tế, thời gian tải trung bình đã rút ngắn ấn tượng từ 27,6 giây xuống còn 1,7 giây.

Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 37/100

Atomic ra mắt phiên bản Qwen3.8 27B nén GGUF siêu nhẹ

Atomic has released Dynamic Quants for Qwen3.8-27B-GGUF, a quantized version of Qwen3.8 27B, compres…

DịchAtomic vừa phát hành phiên bản Qwen3.8-27B với công nghệ nén GGUF động, giảm dung lượng từ 28.9GB xuống chỉ còn 8.5GB. Đáng chú ý, phiên bản AD-IQ3_S có thể chạy mượt trên MacBook Air 16GB mà vẫn giữ được 92.4% độ chính xác so với bản gốc BF16.

14/08

Thứ Sáu · 15 tin
SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 26/100

SemiAnalysis: Tốc độ là lợi thế cạnh tranh, hạ tầng ổn định là chìa khóa

Speed is the Moat 🚨🚨🚨 & @AnushElangovan & his team Keep Running Faster 🚀 & Faster! H…

DịchTheo SemiAnalysis, rào cản lớn nhất khiến các đội ngũ phát triển AI khó bứt tốc chính là sự thiếu ổn định của các cụm máy chủ nội bộ. Việc xây dựng hạ tầng ổn định là yếu tố sống còn để duy trì lợi thế cạnh tranh.

Qwen@Alibaba_Qwen
Mô hìnhĐiểm AI 46/100

Qwen3.8-27B ra mắt: Đạt tốc độ 206 tok/s trên RTX 5090

Yes, we are back👑, with 206 tok/s on a single RTX 5090! Amazing Day-0 work from the SGLang team. Gi…

DịchAlibaba vừa phát hành mã nguồn mở Qwen3.8-27B, thiết lập chuẩn mực mới cho các mô hình nhỏ trong tác vụ lập kế hoạch và xử lý dài hạn, với tốc độ ấn tượng 206,1 tok/s trên RTX 5090.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (44 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “tối ưu hóa” — Trang 13 | AIHOT.vn