TRACE-Bench phân tách quá trình tạo ảnh từ nhiều tham chiếu thành 4 thao tác cơ bản, giúp chỉ ra rằng các mô hình AI hiện nay vẫn gặp khó khăn lớn trong việc tách biệt và gán thuộc tính chính xác.
Nghiên cứu đề xuất chiến lược huấn luyện mới bằng cách tận dụng tiền đề từ không gian tiềm ẩn (latent) trước khi chuyển sang không gian pixel, giúp mô hình đạt hiệu suất vượt trội và tăng tốc độ suy luận đáng kể so với các phương pháp truyền thống.
OVOW là bước đột phá giúp chuyển đổi video đơn lẻ thành các mô hình 4D dạng Mesh có thể tương tác, hỗ trợ đắc lực cho việc huấn luyện robot trong môi trường mô phỏng thực tế mà không cần dựng hình thủ công.
Vì sao đáng đọc: Nghiên cứu giải quyết bài toán cốt lõi trong huấn luyện robot (Real2Sim) bằng cách tự động hóa việc tạo môi trường mô phỏng từ video, có tính ứng dụng thực tiễn rất cao.
NaviDC-OCR là khung làm việc thống nhất giúp giải quyết các lỗi biến dạng hình học và hạn chế về khả năng suy luận cấu trúc trong các mô hình ngôn ngữ thị giác (VLM) khi xử lý tài liệu.
Dòng GPT-5.6 mới của OpenAI, đặc biệt là phiên bản Sol, đã thiết lập tiêu chuẩn mới về khả năng thị giác máy tính với hiệu suất vượt trội trong các bài kiểm tra phát hiện vật thể và đếm đối tượng so với thế hệ tiền nhiệm.
Nghiên cứu giới thiệu bộ dữ liệu ALD/E-ImageMiner giúp AI hiểu và trích xuất thông tin từ biểu đồ, bảng biểu khoa học, đặt nền móng cho khả năng suy luận hình ảnh chuyên sâu trong nghiên cứu.
Nghiên cứu giới thiệu S^2VOPD, phương pháp tạo tín hiệu học tập bằng cách lược bỏ thông tin từ mô hình học sinh thay vì bổ sung dữ liệu cho giáo viên, giúp huấn luyện mô hình thị giác hiệu quả mà không cần nhãn hay mô hình giáo viên mạnh.
UniProbe là giải pháp nhẹ giúp phát hiện các thông tin sai lệch (ảo tưởng) trong mô hình thị giác - ngôn ngữ bằng cách phân tích cấu trúc dữ liệu nội bộ mà không cần tinh chỉnh toàn bộ mô hình.
Vinci2 giải quyết bài toán khó khi nào AI nên chủ động lên tiếng bằng cách kết hợp ra quyết định và tạo nội dung dựa trên dòng video liên tục và bộ nhớ dài hạn, giúp trợ lý AI hiểu ngữ cảnh và thói quen người dùng tốt hơn.
Vì sao đáng đọc: Nghiên cứu đột phá tại ECCV 2026, giải quyết vấn đề thực tế trong tương tác người-AI (trợ lý chủ động), có tính ứng dụng cao cho kính thông minh và thiết bị đeo.
CPI-Bench giải quyết hạn chế của các bộ tiêu chuẩn cũ bằng cách đánh giá khả năng chỉnh sửa đa ảnh, yêu cầu suy luận phức tạp và tính ứng dụng thực tế cao của các mô hình AI.
GAS là khung huấn luyện mới sử dụng việc tạo sinh hình ảnh làm giám sát phụ để cải thiện khả năng hiểu thị giác của các mô hình ngôn ngữ đa phương thức mà không làm tăng chi phí suy luận.
Alibaba vừa ra mắt mô hình thị giác Qwen 3.8 27B với hiệu suất vượt trội. Tuy nhiên, chế độ 'suy nghĩ' mặc định khiến tốc độ phản hồi chậm, người dùng cần tùy chỉnh để tối ưu hóa trải nghiệm.
SPARGen là khung làm việc đa phương thức thống nhất, giải quyết các bài toán tái dựng 3D, tương ứng mật độ và suy luận không gian bằng cách chuyển đổi chúng thành các tác vụ tạo sinh có điều kiện, giúp tối ưu hóa khả năng biểu diễn không gian.
Thử nghiệm PerceptionBench từ Moonshot AI cho thấy các mô hình AI hàng đầu đều chưa đạt 60% độ chính xác trong việc nhận diện hình ảnh, chứng minh lỗi suy luận thường bắt nguồn từ khâu đọc hình ảnh kém.
RibAssist 3D sử dụng hai góc chiếu CT trực giao để tự động phát hiện và định vị chính xác các vết gãy xương sườn trong không gian 3D, giúp giảm tải đáng kể công việc cho bác sĩ chẩn đoán hình ảnh.
Nghiên cứu đề xuất phương pháp dùng LLM để tự động thiết kế thuật toán cắt tỉa token hình ảnh, giúp giảm chi phí tính toán cho các mô hình đa phương thức mà không cần tinh chỉnh thủ công.
LiveAnimate là hệ thống tạo hoạt ảnh người dùng mô hình DiT 14B, cho phép tạo video dài ổn định với độ trễ thấp nhờ cơ chế PR-Sink và tối ưu hóa quy trình lấy mẫu chỉ trong 3 bước.
UniSwap là khung làm việc đầu tiên cho phép thay đổi đồng thời diện mạo và giọng nói trong video nói thông qua mô hình Transformer khuếch tán, giúp giữ nguyên nội dung và chuyển động gốc của video.
CW-BASS v2 giải quyết vấn đề bão hòa độ tin cậy khi dùng DINOv2 làm giáo viên trong phân đoạn bán giám sát, giúp cải thiện đáng kể hiệu suất trên các tập dữ liệu như ADE20K.
Spatial Memory Agent (SMA) là khung tự tiến hóa giúp các mô hình VLM đóng băng cải thiện khả năng suy luận không gian thông qua việc đúc kết kinh nghiệm và đánh giá độ tin cậy, đạt hiệu suất vượt trội trên nhiều tiêu chuẩn đánh giá.
DreamX-Phi 1.0 là mô hình thế giới video dự đoán trạng thái tương lai dựa trên hình ảnh, lệnh ngôn ngữ và chuỗi hành động. Mô hình tối ưu hóa khả năng điều khiển robot thông qua mã hóa hình học PRoPE và kỹ thuật duy trì tính nhất quán của vật thể.
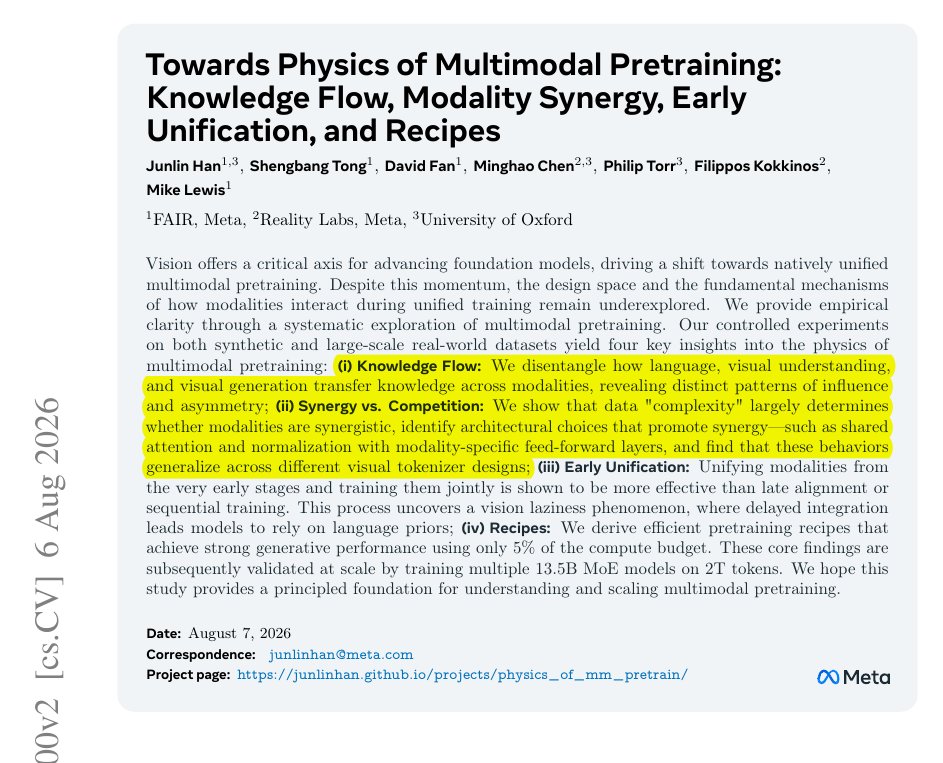
The Meta/Oxford study finds, a multimodal model may need surprisingly little image-generation data i…
DịchNghiên cứu chỉ ra rằng việc cân bằng tỷ lệ dữ liệu ngôn ngữ và hình ảnh giúp mô hình đa phương thức đạt hiệu suất cao hơn dù giảm 5 lần dữ liệu tạo ảnh. Đồng thời, việc đưa hình ảnh vào quá muộn dễ gây ra tình trạng 'lười thị giác', khiến mô hình quá phụ thuộc vào ngôn ngữ.
PGE là mô hình end-to-end đột phá cho phép xác định đối tượng mà con người đang nhìn vào thông qua các câu lệnh văn bản hoặc hình ảnh linh hoạt, loại bỏ sự phụ thuộc vào các bước tiền xử lý phức tạp.
This is so cool: Matic put the same vision-first bet Tesla made for self driving into a robot that c…
DịchMatic áp dụng triết lý thị giác của Tesla cho robot hút bụi, sử dụng 5 camera RGB-IR và chip NVIDIA Jetson Orin để nhận diện vật thể thông minh mà không cần LiDAR. Sản phẩm nhận đánh giá tuyệt đối 10/10 từ WIRED nhờ khả năng xử lý 3D thời gian thực.
Liquid AI giới thiệu LFM2.5-VL-3B, mô hình 3.1 tỷ tham số có khả năng đọc màn hình, định vị đối tượng, phân tích biểu đồ và tự động gọi công cụ ngay trên thiết bị.
Hand Visibility Detector là hệ thống đầu tiên chuyên biệt hóa việc ước tính độ hiển thị của từng khớp tay, giúp tối ưu hóa độ chính xác cho các tác vụ 3D và thực tế ảo (AR/VR). Công cụ này hiện đã được phát hành dưới dạng mã nguồn mở để cộng đồng dễ dàng tích hợp.
AtlasVLA giải quyết hạn chế của các mô hình VLA truyền thống bằng cách tích hợp bộ nhớ không gian 4D và trạng thái làm việc cá nhân, giúp robot duy trì nhận thức về môi trường và tiến độ công việc ngay cả khi vật thể nằm ngoài tầm nhìn.
Vì sao đáng đọc: Đây là nghiên cứu quan trọng giải quyết điểm yếu cốt lõi của robot AI hiện nay là khả năng ghi nhớ dài hạn, có tiềm năng ứng dụng cao trong tự động hóa thực tế.
Self-Geometry là giải pháp plug-and-play giúp các mô hình thị giác nền tảng tự điều chỉnh trong quá trình kiểm thử, bằng cách áp đặt các ràng buộc hình học đa góc nhìn thông qua tương quan pixel mà không cần dữ liệu huấn luyện.
Nghiên cứu chỉ ra rằng các thao tác thị giác như cắt/phóng ảnh trong LLM đa phương thức thường không cải thiện hiệu suất đáng kể mà lại gây tốn kém tài nguyên. Tác giả đề xuất mô hình đồ thị nhân quả để kiểm chứng liệu các công cụ này có thực sự hỗ trợ tư duy hay chỉ là sự ngẫu nhiên.
S2R là khung làm việc toàn diện đầu tiên kết hợp mô phỏng vật lý, khử phản chiếu video bằng mô hình khuếch tán và bộ tiêu chuẩn đánh giá mới, giúp khôi phục video sắc nét chỉ với một bước khử nhiễu.
North Micro Vision is our new quick, smart, and Apache 2 vision model for enterprise document unders…
DịchCohere vừa giới thiệu North Micro Vision, mô hình thị giác máy tính mã nguồn mở theo giấy phép Apache 2, được tối ưu hóa đặc biệt cho khả năng hiểu và xử lý tài liệu doanh nghiệp.
Today, we're adding another member to our model family. Meet North Micro Vision. Our smallest visio…
DịchCohere vừa giới thiệu North Micro Vision, mô hình ngôn ngữ thị giác nhỏ nhất của hãng, được tối ưu hóa cho việc hiểu tài liệu phức tạp và phát hành mã nguồn mở theo giấy phép Apache 2.0.
Liquid AI ra mắt mô hình LFM2.5-VL-3B, tối ưu hóa khả năng xử lý thị giác cho các thiết bị biên với tốc độ vượt trội và hiệu suất cao, mở ra tiềm năng ứng dụng thực tế rộng rãi.
360CityArena là bộ chuẩn mới sử dụng video 360 độ từ khu Akihabara (Tokyo) để kiểm tra khả năng hiểu môi trường, lập kế hoạch đường đi và tư duy không gian của các tác nhân AI trong bối cảnh đô thị chân thực.
Nhóm nghiên cứu MiLM Plus của Xiaomi giới thiệu khung đánh giá PROVE, bao gồm hai chỉ số RC-S và RC-T cùng bộ dữ liệu thực tế, giúp tối ưu hóa khả năng xóa vật thể trong video. Công trình đã được chấp nhận tại hội nghị ACM MM 2026.
iFAN giải quyết sự lệch pha giữa quá trình huấn luyện và suy luận trong các mô hình Mask Transformer bằng cách điều chỉnh thứ hạng xác suất và chưng cất tri thức giữa các lớp, giúp cải thiện độ chính xác của phân đoạn hình ảnh.