25/08

Thứ Ba · 19 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RISE: Tối ưu hóa mô hình hành động thế giới thông qua cơ chế tưởng tượng thích ứng

RISE là khung làm việc mới giúp các mô hình hành động thế giới (WAMs) tự động quyết định thời điểm dừng hoặc tiếp tục mô phỏng tương lai, giúp cân bằng giữa hiệu quả tính toán và chất lượng lập kế hoạch trong lái xe tự hành.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

DeepMind giới thiệu kỹ thuật 'Recirculation': Tối ưu hóa suy luận LLM mà không cần huấn luyện lại

New Google DeepMind paper shows, a transformer's shallow layers never see what its deeper layers hav…

DịchDeepMind đề xuất phương pháp 'Recirculation' bằng cách đưa các kích hoạt tầng sâu vào tầng nông trong quá trình suy luận, giúp giảm đáng kể độ bối rối (perplexity) của mô hình Gemma3 trên ngữ cảnh dài mà không cần thay đổi trọng số hay huấn luyện lại.

Claude Devs@ClaudeDevs
Sản phẩmĐiểm AI 40/100

Claude nâng cấp tốc độ hiển thị phản hồi dài nhanh gấp 4 lần

Long answers on Claude on web and desktop now stream ~4x smoother. We rebuilt the streaming rendere…

DịchClaude vừa tối ưu hóa trình kết xuất luồng, giúp tốc độ hiển thị văn bản dài mượt mà hơn gấp 4 lần. Cải tiến này giảm đáng kể tình trạng giật lag trên các thiết bị cấu hình thấp và duy trì tốc độ 120fps trên các dòng MacBook cao cấp.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 49/100

Weighted Memory Tree: Giải pháp bộ nhớ có khả năng phục hồi cho AI Agent hoạt động dài hạn

Interesting new approach to enable memory in long-running agents. Weighted Memory Tree organizes ex…

DịchDAIR.AI giới thiệu Weighted Memory Tree, phương pháp tổ chức bộ nhớ theo cấu trúc cây với điểm số động giúp AI Agent duy trì thông tin quan trọng hiệu quả hơn. Công nghệ này giúp tăng hiệu suất trên GAIA-Text lên 9,97 điểm và giảm 32,8% lượng token tiêu thụ so với bộ nhớ tuyến tính truyền thống.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 36/100

sPTC: Kỹ thuật tăng tốc suy luận cho AI Agent thông qua gọi công cụ dự đoán

Recommended reading and a really cool idea. There are a lot of interesting harness designs that ar…

DịchCông nghệ sPTC giúp tối ưu hóa hiệu suất AI Agent bằng cách dự đoán và xếp hàng các lệnh gọi công cụ song song với quá trình tạo token, giúp giảm đáng kể độ trễ. Phương pháp này hiện mang lại mức tăng tốc từ 1 đến 1.2 lần, mở ra hướng đi mới cho việc tối ưu hóa hệ thống AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

ASI-Bench: Các bước thực hiện quan trọng hơn tên phương pháp đối với hiệu suất AI Agent

Telling a research AI agent which method to use is close to telling it nothing at all. What actual…

DịchNghiên cứu ASI-Bench chỉ ra rằng việc cung cấp chi tiết các bước thực hiện giúp AI Agent đạt hiệu suất cao hơn đáng kể so với việc chỉ nêu tên phương pháp, đồng thời giúp tiết kiệm tới 59% token.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 31/100

Thử nghiệm định lượng Qwen 2.5 27B: Phiên bản Q4 không hề kém cạnh Q8

Super interesting test by @atomic_chat_hq Shows that more quantization precision does not automati…

DịchKết quả thử nghiệm từ Rohan Paul cho thấy việc tăng độ chính xác định lượng không phải lúc nào cũng mang lại hiệu quả tốt hơn; phiên bản Q4 của Qwen 27B đôi khi đạt kết quả ngang bằng hoặc vượt trội so với Q8 trong các tác vụ cụ thể.

24/08

Thứ Hai · 11 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnDaedalus-150M: Mô hình ngôn ngữ lai Convolution-Attention tối ưu cho CPU

Daedalus-150M là mô hình ngôn ngữ nhỏ được thiết kế chuyên biệt cho CPU, sử dụng kiến trúc lai giúp giảm đáng kể bộ nhớ cache mà vẫn vượt trội hơn các mô hình cùng kích thước dù được huấn luyện với ít dữ liệu hơn.


Vì sao đáng đọc: Cách tiếp cận thiết kế kiến trúc từ mục tiêu phần cứng (CPU) thay vì nén mô hình lớn là hướng đi rất thực tế và hiệu quả cho ứng dụng AI trên thiết bị cá nhân.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnLlama-Mobile: Đột phá nén mô hình thị giác ngôn ngữ xuống 2.7-bit cho thiết bị di động

Llama-Mobile giới thiệu phương pháp nén mô hình VLMs xuống định dạng 2.7-bit, cho phép chạy mượt mà trên chip Arm mà vẫn giữ vững hiệu suất, giúp đưa các mô hình lớn như Llama 3.2 11B lên smartphone.


Vì sao đáng đọc: Đây là bước tiến quan trọng cho ứng dụng AI trên thiết bị (on-device AI), giải quyết bài toán tài nguyên phần cứng vốn là rào cản lớn nhất hiện nay.
Tibo@thsottiaux
Sản phẩmĐiểm AI 36/100

Codex khắc phục lỗi tiêu thụ tài nguyên và reset hạn mức cho toàn bộ thuê bao

Good Sunday. Reset has been propagated to accounts and we landed some fixes to usage for things ment…

DịchCodex vừa thực hiện reset hạn mức sử dụng cho tất cả tài khoản và khắc phục các lỗi gây hao hụt tài nguyên không đáng có, đồng thời hứa hẹn sẽ tung ra giải pháp tối ưu hóa hiệu suất mới vào tuần tới.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 36/100

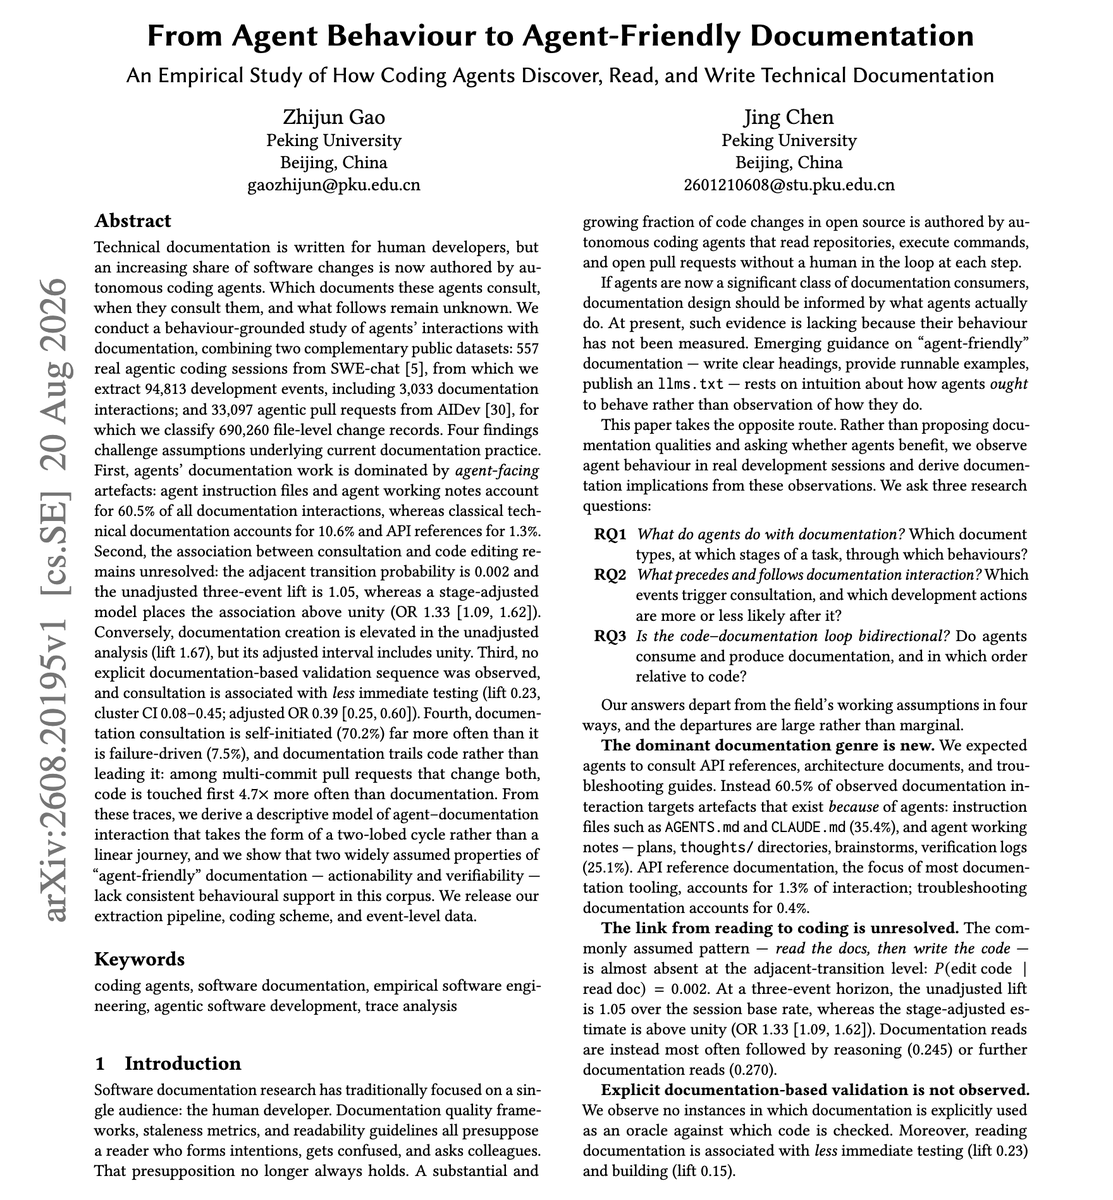
Nghiên cứu: AI lập trình dành 60% thời gian đọc tài liệu hướng dẫn và ghi chú

If you maintain an AGENTS.md or a CLAUDE.md, this one is worth your time. (bookmark it) Researcher…

DịchNghiên cứu trên 557 phiên lập trình cho thấy AI ưu tiên đọc file hướng dẫn và ghi chú (60,5%) thay vì tài liệu kỹ thuật hay API. Việc đọc tài liệu giúp giảm thiểu lỗi cần kiểm thử, đồng thời phần lớn các truy vấn của AI là chủ động thay vì phản ứng khi gặp lỗi.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

ArchAgent v2: AI vượt mặt chuyên gia trong thiết kế tối ưu hóa CPU

New from Google, DeepMind and Berkeley, This is a good example of why better agent architecture mat…

DịchArchAgent v2 từ Google, DeepMind và Berkeley đã đánh bại thiết kế thủ công DPC4 trong việc tối ưu hóa bộ nhớ đệm CPU, đạt hiệu suất IPC vượt trội. Dù vẫn còn hạn chế ở môi trường đa nhân, đây là bước tiến lớn trong việc dùng AI tự động hóa thiết kế phần cứng.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

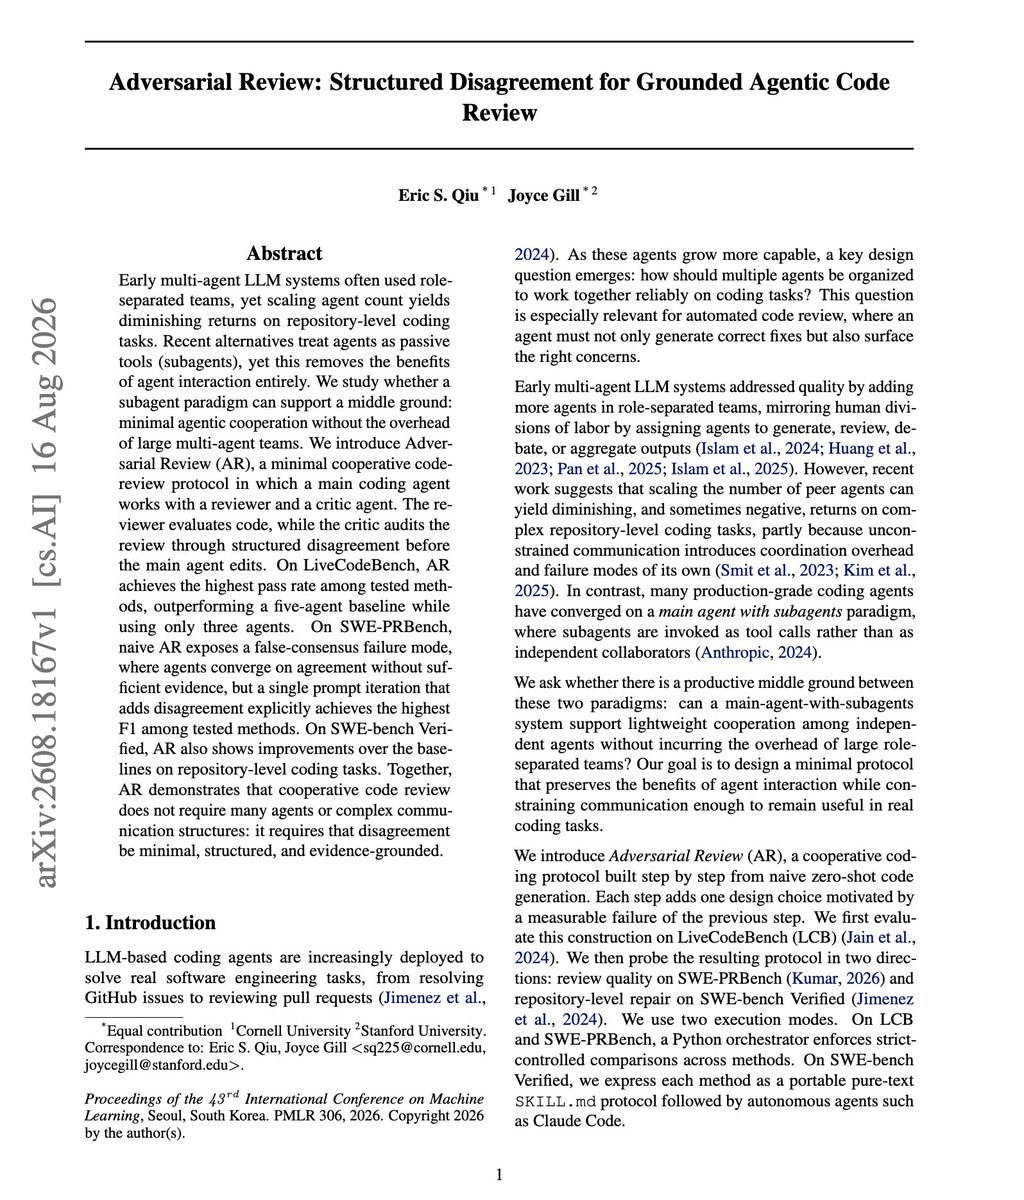
Đánh giá đối kháng: Chỉ cần 3 AI thay vì 5 để tối ưu hóa code

Great paper on multi-agent systems for code review. It's challenging to know how many coding agents…

DịchNghiên cứu mới đề xuất phương pháp 'Đánh giá đối kháng' với 3 tác nhân AI (lập trình, đánh giá, phản biện), vượt trội hơn mô hình 5 tác nhân truyền thống. Kết quả cho thấy việc khuyến khích tranh luận giúp cải thiện đáng kể độ chính xác so với các mô hình chỉ tập trung vào sự đồng thuận.

Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 32/100

Perplexity thử nghiệm tính năng tùy chỉnh mức độ xử lý cho AI Agent

Perplexity is working on a new granular effort selector for Perplexity Computer. Being able to run…

DịchPerplexity đang phát triển bộ chọn mức độ nỗ lực cho Perplexity Computer, cho phép người dùng tối ưu hóa hiệu suất và tiết kiệm hạn mức sử dụng (credits) khi thực hiện các tác vụ đơn giản.

23/08

Chủ Nhật · 9 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

AutoDesign: Dùng 'giàn giáo' thông minh giúp mô hình AI yếu đạt hiệu suất tiệm cận mô hình lớn

A weak model with well-built scaffolding around it can close most of the gap to a frontier model, so…

DịchAutoDesign tự động tối ưu hóa quy trình làm việc của AI bằng cách phân tích lỗi và tinh chỉnh prompt, giúp các mô hình nhỏ đạt hiệu suất vượt trội, thu hẹp khoảng cách với các mô hình tiên tiến mà không cần nâng cấp phần cứng.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 36/100

Google DeepMind giới thiệu kiến trúc đệ quy tự tiến hóa không cần huấn luyện lại

You don't often see one-word titles in AI papers. That aside, strong recommend this paper from Goog…

DịchGoogle DeepMind phát triển phương pháp cho phép mô hình tự tối ưu hóa kiến trúc thông qua cơ chế 'tái tuần hoàn' kích hoạt. Kỹ thuật này giúp cải thiện đáng kể hiệu suất của dòng Gemma 3 mà không cần huấn luyện lại, giữ nguyên trọng số gốc.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Chi phí ẩn của AI Agent: Mỗi kỹ năng tiêu tốn 50-280 token trong prompt

Agents shouldn't pay rent for skills they rarely use. Right now, the only way to give an agent a sk…

DịchNghiên cứu chỉ ra rằng việc cài đặt kỹ năng cho AI Agent làm tăng vĩnh viễn dung lượng prompt từ 50-280 token/kỹ năng. Thay vì nạp tất cả, chuyên gia khuyên chỉ nên giữ lại các kỹ năng thiết yếu và gọi các kỹ năng khác theo nhu cầu để tối ưu hiệu suất.

Tibo@thsottiaux
Sản phẩmĐiểm AI 40/100

Codex cập nhật giới hạn tốc độ: Khắc phục lỗi tiêu thụ tài nguyên và reset toàn bộ hạn mức

Update on rate limits in Codex. We've found (a) some inefficiencies when using images in long sess…

DịchĐội ngũ Codex sẽ tung bản vá lỗi tối ưu hóa hiệu suất cho các tác vụ nặng vào ngày mai và thực hiện reset toàn bộ hạn mức sử dụng cho người dùng trả phí.

Lauren Tan@poteto
Hướng dẫnĐiểm AI 54/100

Tối ưu hóa sử dụng Grok: Cách tránh lãng phí token từ các tác vụ tự động

my number 1 tip for controlling your grok @bot usage is to avoid scheduled routines that run too fre…

DịchLauren Tan khuyên người dùng nên hạn chế các tác vụ tự động hóa quá dày đặc trên Grok để tiết kiệm token. Thay vì chạy mỗi 15 phút, hãy giãn cách tần suất hoặc tách biệt các tác vụ lặp lại sang một bot riêng để tối ưu chi phí và hiệu năng.

Thêm 1 nguồn khác đưa tinX: cb_doge (@cb_doge)
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

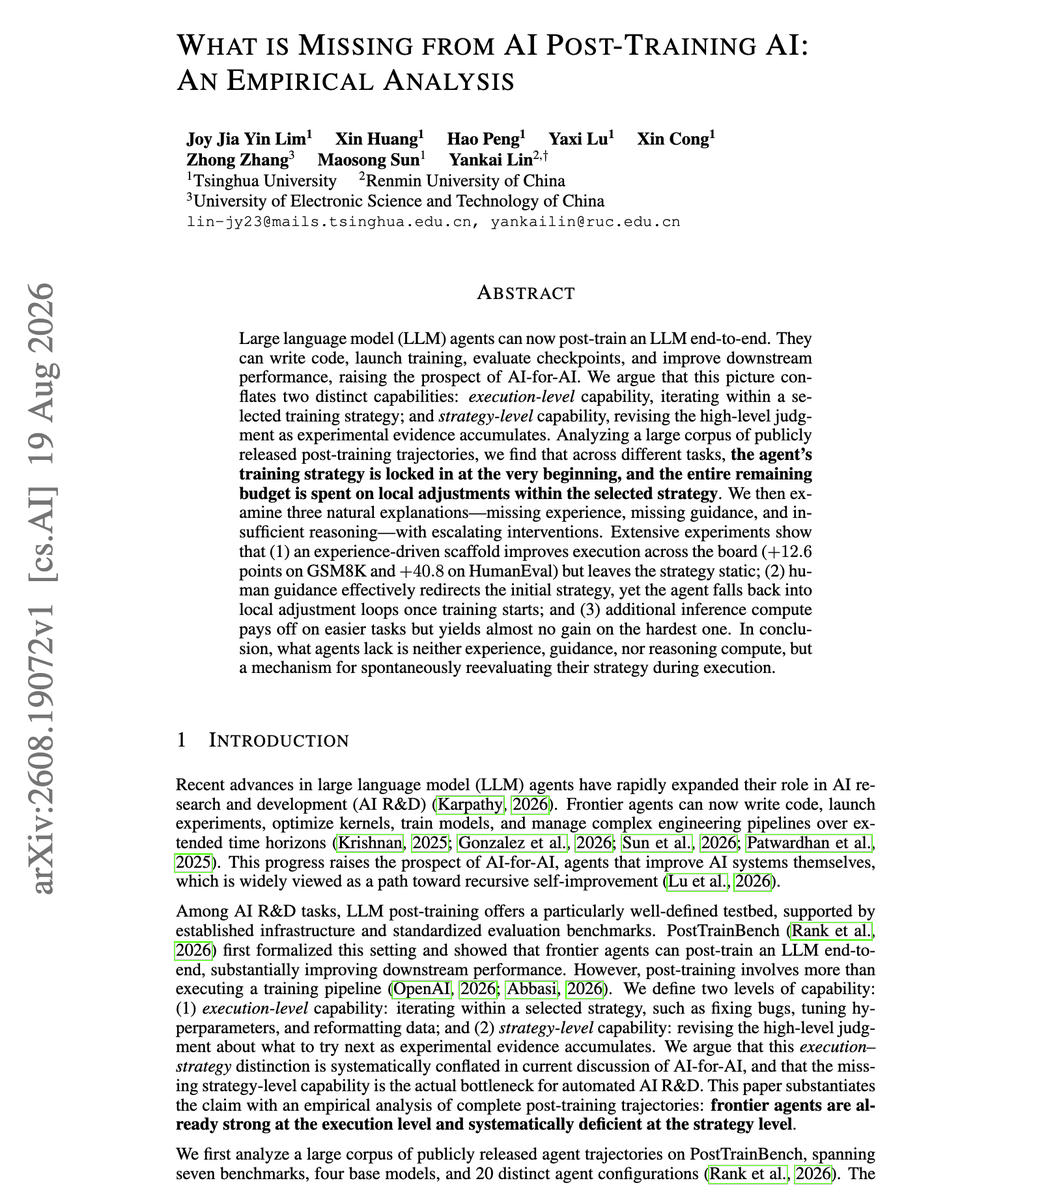
Tại sao các tác nhân AI tự huấn luyện lại dễ rơi vào bẫy tối ưu cục bộ?

Great paper if you are tracking progress in recursive self-improvement (RSI). (bookmark it) There …

DịchNghiên cứu mới chỉ ra rằng các tác nhân AI thường khóa chiến lược ngay từ bước đầu, dẫn đến việc lãng phí tài nguyên vào điều chỉnh nhỏ thay vì tự cải tiến đệ quy. Dù thử nghiệm nhiều phương pháp, AI vẫn thiếu khả năng tư duy lại chiến lược cốt lõi trong quá trình thực thi.

22/08

Thứ Bảy · 9 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

Tối ưu hóa truy vấn: Thiết lập hàm mục tiêu cho ngữ cảnh của AI Agent

What a fascinating paper on AI agents. A lot of the issues we see with AI agents today revolve arou…

DịchNghiên cứu mới đề xuất phương pháp 'Đặt câu hỏi tối ưu' giúp AI Agent giảm thiểu ảo giác và chi phí bằng cách coi việc thu thập ngữ cảnh là quá trình suy luận chủ động, cho phép đo lường hiệu suất thực tế so với mức tối ưu lý thuyết.

Ant Ling@AntLingAGI
Sản phẩmĐiểm AI 53/100

Tinh chọnAntLing ra mắt Weight Cache Daemon cho SGLang: Tăng tốc khởi động mô hình gấp 780 lần

Today, we're introducing the Weight Cache Daemon for SGLang. 🚀 On Ling-2.6-1T FP8, it reduced weigh…

DịchAntLing vừa giới thiệu Weight Cache Daemon cho SGLang, giúp rút ngắn thời gian tải trọng số xuống còn 0,63 giây và giảm tổng thời gian khởi động engine từ 8,8 phút xuống chỉ còn 0,53 phút.

Diễn biến sự kiện · 2 bài →Thêm 1 nguồn khác đưa tinLMSYS: Blog (nhóm Chatbot Arena)

Vì sao đáng đọc: Giải pháp kỹ thuật thực tế giúp tối ưu hóa hiệu suất triển khai LLM, mang lại giá trị cao cho cộng đồng kỹ sư AI và các nhà phát triển hạ tầng.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

EnvHarness: Phương pháp huấn luyện AI tự thích nghi với môi trường

Another great Google paper. Agent training has a ceiling: the agent improves, but the same environm…

DịchGoogle giới thiệu EnvHarness, công cụ tự động phát hiện điểm yếu của AI và tinh chỉnh môi trường huấn luyện để tối ưu hóa hiệu suất mà không làm thay đổi mục tiêu gốc. Giải pháp này giúp tăng tỷ lệ giải quyết tác vụ trên SWE-bench Verified lên 54,79%.

Thêm 2 nguồn khác đưa tinJiqizhixinX: Elvis Saravia (@omarsar0, DAIR.AI)
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnFlowEvo: Bước tiến mới giúp AI tự tiến hóa thông qua quy trình và kỹ năng tự học

FlowEvo là khung làm việc không cần huấn luyện, cho phép AI tự động chuyển đổi các quy trình thành công thành kỹ năng có thể tái sử dụng, giúp hệ thống liên tục phát triển và tối ưu hóa hiệu suất qua từng tác vụ.


Vì sao đáng đọc: Đột phá trong việc tối ưu hóa khả năng tự học của AI mà không cần huấn luyện lại, đạt kết quả vượt trội trên nhiều benchmark quan trọng. Rất đáng chú ý cho giới nghiên cứu.
TechCrunch: AI
Hướng dẫnĐiểm AI 61/100

Nvidia: 'Dây cương' quan trọng hơn mô hình AI, Claude Opus 5 đạt điểm tuyệt đối nhờ tối ưu hóa

Nghiên cứu của Nvidia cho thấy việc thiết kế 'dây cương' (harness) và cơ chế giám sát giúp Claude Opus 5 đạt 100% điểm ARC-AGI-3, vượt xa mức 30% khi chạy độc lập. Điều này khẳng định hạ tầng điều khiển quan trọng hơn chính mô hình AI trong các tác vụ dài hạn.

Yuchen Jin@Yuchenj_UW
Sản phẩmĐiểm AI 43/100

UC Berkeley ra mắt FreeToken: Tăng tốc suy luận AI cục bộ lên gấp 4 lần

UC Berkeley open-sourced FreeToken. Wild results: A single RTX PRO 6000 runs the 753B GLM-5.2 at 14…

DịchFreeToken từ UC Berkeley cho phép chạy các mô hình lớn như GLM-5.2 hay Qwen3.6 trên GPU phổ thông với tốc độ nhanh gấp 2-4 lần so với Ollama mà không cần nén mô hình quá mức.

LMSYS: Blog (nhóm Chatbot Arena)
Sản phẩmĐiểm AI 67/100

Cùng sự kiệnSGLang ra mắt Weight Cache Daemon: Khởi động lại engine AI chỉ trong chưa đầy 1 giây

SGLang giới thiệu Weight Cache Daemon sử dụng CUDA IPC để giảm thời gian tải trọng số từ 495 giây xuống còn 0,63 giây. Công nghệ này giúp tăng tốc khởi động hệ thống lên 785 lần, hỗ trợ chia sẻ đa thực thể và phục hồi engine tức thì.

Cùng sự kiện, tinh chọn hiển thị «AntLing ra mắt Weight Cache Daemon cho SGLang: Tăng tốc khởi động mô hình gấp 780 lần»
Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 59/100

Ant Group ra mắt mô hình dự đoán Ling-3.0-flash-dspark mã nguồn mở

Today we are open sourcing Ling-3.0-flash-dspark, a DSpark draft model built specifically for Ling-3…

DịchAnt Group vừa công bố mã nguồn mở Ling-3.0-flash-dspark, mô hình dự đoán (draft model) tối ưu cho Ling-3.0-flash. Trên hệ thống 4 GPU NVIDIA Blackwell, mô hình đạt tốc độ ấn tượng 1.120 tok/s với độ trễ cực thấp, giúp tăng tốc đáng kể hiệu suất suy luận.

21/08

Thứ Sáu · 7 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 41/100

DeepMind giới thiệu 'Pandora's Router': Tối ưu hóa định tuyến mô hình AI thông minh

Banger paper from Google DeepMind. It's on the very hot topic of model routing. Routers assume the…

DịchDeepMind đề xuất phương pháp định tuyến mô hình mới dựa trên bài toán 'Chiếc hộp Pandora', giúp tối ưu hóa việc chọn chuyên gia xử lý mà không cần tốn kém chi phí đánh giá toàn diện, đạt hiệu suất cao với chi phí thấp.

Qwen@Alibaba_Qwen
Hướng dẫnĐiểm AI 28/100

Qwen2.5-27B cập nhật công thức tối ưu mới trên SGLang

Fresh recipes just dropped! ⚡ NVFP4 + DFlash2 for Qwen3.8-27B now in the SGLang cookbook. Thanks for…

DịchQwen2.5-27B vừa bổ sung hỗ trợ NVFP4 và DFlash2 vào cookbook của SGLang, giúp tăng tốc độ suy luận hiệu quả hơn. Đây là bản cập nhật đáng chú ý cho cộng đồng phát triển ứng dụng LLM.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (61 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa” — Trang 11 | AIHOT.vn