02/09

Thứ Tư · 16 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnClawBench: Khi các siêu AI 'bó tay' trước những tác vụ thực tế trên web

Nghiên cứu mới từ TIGER Lab cho thấy các mô hình hàng đầu như Claude, GPT và Gemini đều thất bại thảm hại khi thực hiện các tác vụ thực tế trên web, với tỷ lệ thành công chỉ đạt khoảng 33%.


Vì sao đáng đọc: Bài viết bóc trần sự thật về khả năng thực thi của AI agent trong môi trường thực tế, thách thức những kỳ vọng quá mức về khả năng tự động hóa hiện nay.
Sky Computing Lab@haoailab
Hướng dẫnĐiểm AI 39/100

Đánh giá độc lập từ Physion Labs: MiniMax H3 Max vượt trội so với H3 và FastH3

Very glad to see this independent evaluation of FastH3 Preview, @MiniMax_AI and H3 Max by @Physion_L…

DịchPhysion Labs đã thử nghiệm ba mô hình MiniMax trên các tác vụ robot, phim ảnh và quảng cáo. Kết quả cho thấy H3 Max dẫn đầu về hiệu năng tổng thể, trong khi FastH3 preview thể hiện khả năng tuân thủ câu lệnh (prompt adherence) ấn tượng hơn.

Kim@kimmonismus
Hướng dẫnĐiểm AI 24/100

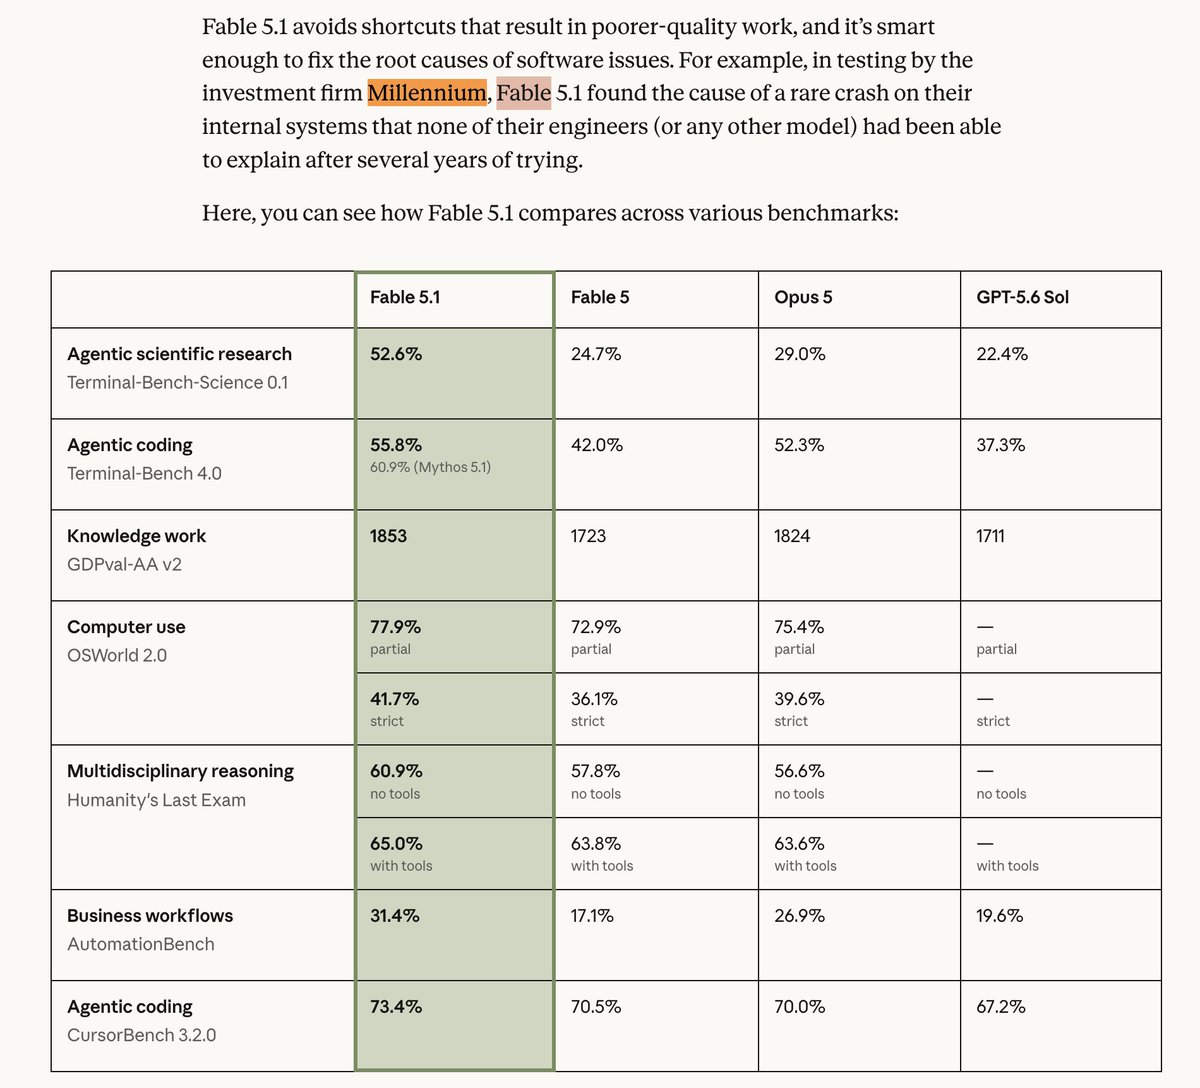
Đánh giá hiệu năng Fable 5.1: Bước tiến lớn về sức mạnh và giá thành

Looking solely at benchmarks and considering the price-performance ratio, Fable 5.1 represents a sig…

DịchFable 5.1 cho thấy hiệu suất vượt trội so với Sol 5.6 Max trong các bài kiểm tra Cursor Bench với mức giá cạnh tranh hơn. Đây là bản nâng cấp đáng chú ý về chỉ số AI, hứa hẹn mang lại trải nghiệm tối ưu và ít lỗi hơn cho người dùng.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 38/100

Ethan Mollick đánh giá Claude Fable 5.1: Bước tiến lớn trong các tác vụ đòi hỏi tư duy dài hạn

Had early access to Claude Fable 5.1. Its a real advance in long-run work that requires judgement an…

DịchEthan Mollick cho rằng Claude Fable 5.1 cải thiện đáng kể khả năng xử lý các công việc phức tạp cần tư duy và thẩm mỹ. Ông đã minh chứng bằng một trò chơi retro mô phỏng tàu vũ trụ do AI này tạo ra.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 42/100

Apodex 1.1 ra mắt: Hiệu suất tác vụ thông minh vượt trội dù điểm số tổng quát khiêm tốn

Apodex released Apodex 1.1, its proprietary model that reached 44 on the Artificial Analysis Intelli…

DịchApodex 1.1 đạt 1.348 Elo trên bảng xếp hạng GDPval-AA v2, vượt qua nhiều mô hình có điểm số tổng quát cao hơn, chứng minh khả năng xử lý tác vụ thực tế ấn tượng dù chỉ đạt 44 điểm trên Artificial Analysis Intelligence Index.

Yuchen Jin@Yuchenj_UW
Mô hìnhĐiểm AI 52/100

Yuchen Jin đánh giá Fable 5.1: Bước nhảy vọt ấn tượng giữa làn sóng 'làm đẹp' bảng xếp hạng

Even if most AI labs are benchmark-maxxing now, Fable 5.1 still looks like an insane jump. From Ant…

DịchChuyên gia Yuchen Jin nhận định Fable 5.1 thể hiện sự tiến bộ vượt bậc về hiệu năng thực tế, khác biệt hoàn toàn với xu hướng tối ưu hóa điểm số trên các bảng xếp hạng AI hiện nay.

01/09

Thứ Ba · 5 tin
Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 58/100

Nghiên cứu Hacker-Opus: Các phương pháp đánh giá căn chỉnh hành vi thông thường khó phát hiện sự lệch lạc của mô hình

Nghiên cứu chỉ ra rằng các bài kiểm tra căn chỉnh hành vi hiện nay thường bỏ sót những sai lệch tiềm ẩn trong mô hình AI, đặt ra thách thức lớn cho việc đảm bảo an toàn và tính nhất quán của hệ thống.

Qwen@Alibaba_Qwen
Nghiên cứuĐiểm AI 38/100

Accio ra mắt CommerceAgentBench: Qwen-Max dẫn đầu hiệu năng mô hình mã nguồn mở

CommerceAgentBench starts with real commercial demand, and Qwen3.8-Max delivers the strongest overal…

DịchAccio công bố CommerceAgentBench, bộ tiêu chuẩn đánh giá tác nhân AI trong môi trường thương mại thực tế. Qwen-Max hiện là mô hình mã nguồn mở có hiệu suất tốt nhất với tỷ lệ hoàn thành tác vụ ấn tượng trên 107 quy trình công việc phức tạp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 64/100

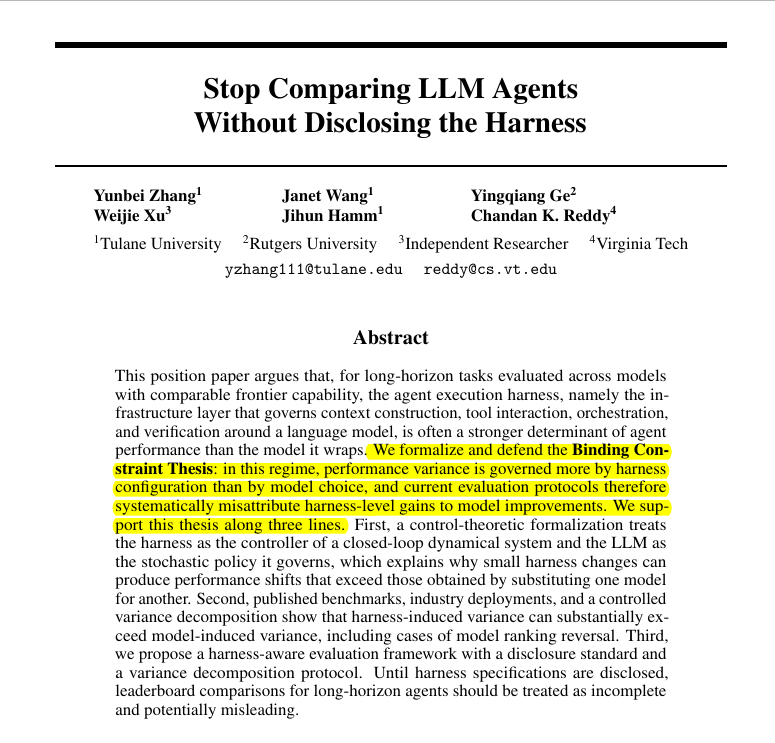
Nghiên cứu mới: 'Harness' trong đánh giá AI có thể quan trọng hơn cả chính mô hình

For long-horizon agents, this paper argues the harness can matter more than the model, so benchmark …

DịchMột bài báo trên arXiv chỉ ra rằng trong các bài kiểm tra tác nhân AI dài hạn, công cụ đánh giá (harness) có ảnh hưởng đến kết quả lớn hơn cả bản thân mô hình, đòi hỏi sự minh bạch hơn khi công bố điểm số.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

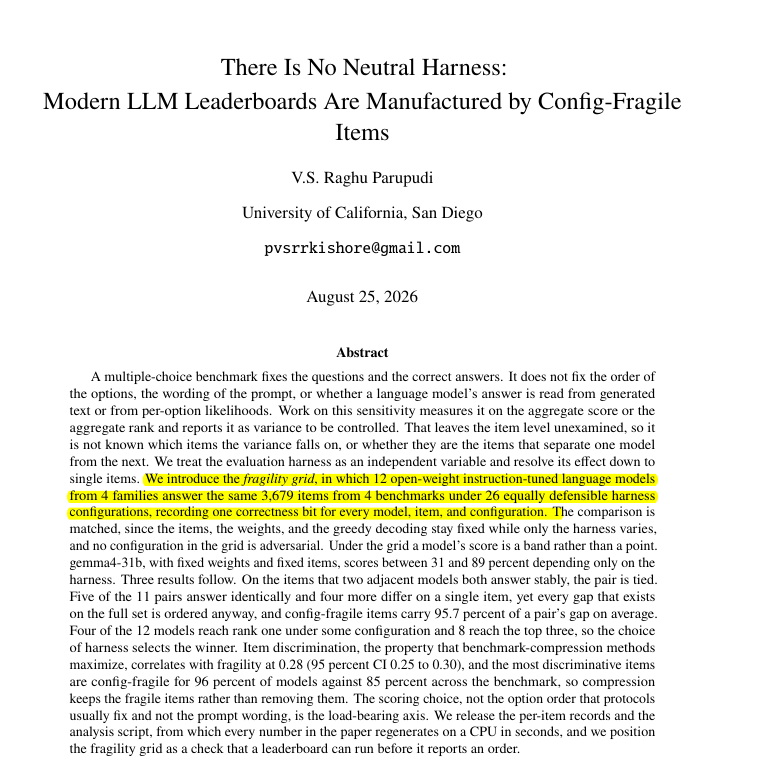
Nghiên cứu mới: Thứ hạng LLM trên bảng xếp hạng phụ thuộc lớn vào cách thiết lập đánh giá

LLM rankings can be created by evaluation choices as much as model differences, so one setup should …

DịchMột nghiên cứu cho thấy chỉ cần thay đổi định dạng prompt hoặc cách chấm điểm, điểm số của cùng một mô hình (như Gemma-2-27b) có thể dao động từ 31% đến 89%, làm lung lay tính khách quan của các bảng xếp hạng LLM hiện nay.

31/08

Thứ Hai · 2 tin

30/08

Chủ Nhật · 2 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 43/100

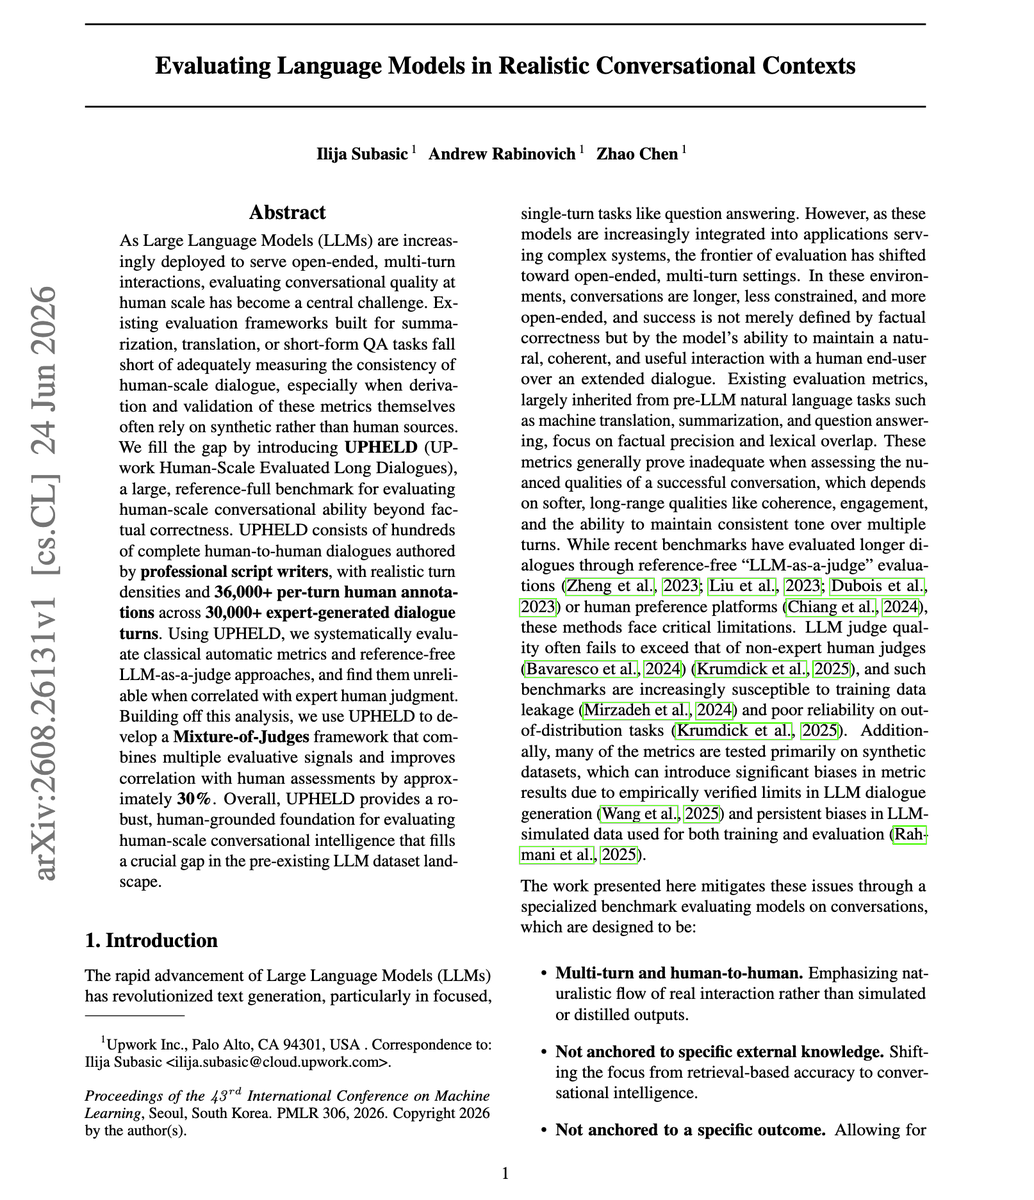
Nghiên cứu mới: LLM làm 'giám khảo' không còn đáng tin cậy trong các cuộc hội thoại thực tế

// Your LLM judge disagrees with the experts // LLM Judges can be tricky to build. Here is an inte…

DịchNghiên cứu chỉ ra rằng các chỉ số tự động và phương pháp 'LLM-as-a-judge' truyền thống không khớp với đánh giá của chuyên gia. Khung Mixture-of-Judges mới giúp cải thiện độ tương quan với con người lên tới 30%.

Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 29/100

Claude Opus 3.5 không còn là lựa chọn số một

I barely use Claude Opus 5 these days. It doesn't talk like a normal person (especially in Chinese) …

DịchNgười dùng đang dần từ bỏ Claude Opus 3.5 do phong cách phản hồi thiếu tự nhiên và rườm rà, thay vào đó chuyển sang các mô hình như GPT-5.6 Sol hoặc các lựa chọn thay thế hiệu quả về chi phí như GLM-5.3 và Kimi K3.

29/08

Thứ Bảy · 1 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 43/100

EdgeBench: Các AI Agent mạnh nhất chỉ đạt 51,3 điểm sau 12 giờ thử thách

Another long-horizon benchmark, another reminder that current AI can work for hours and still remain…

DịchTrong bài kiểm tra EdgeBench kéo dài 12 giờ, các mô hình AI hàng đầu chỉ đạt 51,3/100 điểm dù có khả năng tự sửa lỗi và chạy mô phỏng. Kết quả cho thấy hiệu suất của AI vẫn gặp ngưỡng bão hòa dù được cung cấp môi trường tương tác liên tục.

28/08

Thứ Sáu · 7 tin
Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 39/100

Accio ra mắt CommerceAgentBench: Bộ tiêu chuẩn đánh giá AI trong thương mại điện tử

Accio has open-sourced CommerceAgentBench, a 107-task benchmark spanning procurement, product listin…

DịchAccio vừa công bố CommerceAgentBench, bộ tiêu chuẩn gồm 107 tác vụ thực tế từ khâu nhập hàng đến hậu mãi. Kết quả thử nghiệm trên 13 mô hình AI cho thấy hiệu suất cao nhất chỉ đạt 61,7%, cho thấy tiềm năng lớn nhưng cũng đầy thách thức cho các tác nhân AI trong ngành bán lẻ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giấy phép đánh giá AI có ý nghĩa gì? Phân tích tính xác thực của các bộ tiêu chuẩn Inspect Evals

Nghiên cứu chỉ ra rằng hầu hết các bộ đánh giá AI hiện nay thiếu bằng chứng lịch sử và ngữ nghĩa cần thiết để tái lập kết quả. Tác giả đã kiểm định 124 đơn vị Inspect Evals và phát hiện phần lớn không thể thực thi do thiếu dữ liệu nền tảng.

Meituan LongCat@Meituan_LongCat
Nghiên cứuĐiểm AI 51/100

AI có thể trở thành nhà nghiên cứu độc lập? Đánh giá từ 7 mô hình hàng đầu

AI agents can now propose changes, run experiments, interpret feedback, and refine technical artifac…

DịchNghiên cứu từ Meituan LongCat cho thấy các mô hình AI hiện nay giống công cụ tối ưu hóa kỹ thuật hơn là nhà nghiên cứu độc lập, khi khả năng tối ưu mạnh không đồng nghĩa với năng lực đổi mới sáng tạo.

Kim@kimmonismus
Sản phẩmĐiểm AI 40/100

CommerceAgentBench: Bộ tiêu chuẩn đánh giá khả năng thực thi tác vụ thực tế của AI trong thương mại điện tử

Most AI benchmarks test whether a model can give the right answer. CommerceAgentBench asks whether a…

DịchAccio ra mắt CommerceAgentBench với 107 tác vụ thực tế từ vận hành đến hậu mãi. Thay vì dựa trên lý thuyết, bộ tiêu chuẩn này kiểm chứng trực tiếp kết quả công việc của AI, cho thấy các mô hình hiện nay chỉ đạt tỷ lệ thành công 61,7%.

Thêm 2 nguồn khác đưa tinX: Testing Catalog (@testingcatalog)TechNode

27/08

Thứ Năm · 9 tin
Ethan Mollick@emollick
Hướng dẫnĐiểm AI 41/100

Cảnh báo về xu hướng 'nhân hóa' AI từ báo cáo của METR

The METR report on Hugging Face is really good and important but people are now comfortably ascribin…

DịchChuyên gia Ethan Mollick cảnh báo rằng việc gán ghép động cơ và tính cách con người cho AI dựa trên các nghiên cứu vội vã có thể làm sai lệch nhận định thực tế về khả năng của mô hình.

Google DeepMind@GoogleDeepMind
NgànhĐiểm AI 51/100

DeepMind tiên phong triển khai đánh giá mù kép cho các mô hình AI tiên tiến

In an industry first, we're piloting double-blind evaluations for frontier AI. By creating a secure…

DịchDeepMind vừa thử nghiệm phương pháp đánh giá mù kép nhằm đảm bảo tính bảo mật và khách quan cho các mô hình AI, bằng cách giữ kín cả câu lệnh kiểm thử lẫn trọng số mô hình trong môi trường an toàn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SWE Refactor Bench: Đánh giá khả năng tự động di chuyển mã nguồn toàn hệ thống của AI

Nghiên cứu giới thiệu bộ tiêu chuẩn SWE Refactor Bench nhằm kiểm tra khả năng thực hiện các đợt di chuyển mã nguồn phức tạp của AI, khắc phục tình trạng các mô hình chỉ 'gian lận' để vượt qua bài kiểm tra mà không thực sự thay đổi cấu trúc hệ thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Video-IFBench: Bộ tiêu chuẩn mới đánh giá khả năng tuân thủ chỉ dẫn của mô hình AI đa phương thức trong hiểu video

Video-IFBench là bộ tiêu chuẩn đánh giá chuyên sâu khả năng tuân thủ chỉ dẫn của các mô hình đa phương thức (MLLM) khi xử lý video, thông qua 1.500 mẫu thử nghiệm với độ phức tạp cao. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn lớn với các yêu cầu đa ràng buộc và cấu trúc phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VGI-BENCH: Đánh giá khả năng suy luận thị giác trong các mô hình tạo video

VGI-bench là bộ tiêu chuẩn mới gồm 27 tác vụ giúp đánh giá chuyên sâu khả năng suy luận thị giác của các mô hình tạo video hiện nay. Kết quả cho thấy ngay cả những mô hình mạnh nhất cũng chưa đạt hiệu suất ổn định, chỉ dừng lại ở mức 51%.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AnTrap: Đánh giá độ bền của AI điều khiển giao diện Android trước các bất thường thời gian thực

Nghiên cứu giới thiệu AnTrap, bộ tiêu chuẩn đầu tiên đánh giá khả năng chống chịu của các tác nhân AI trên Android trước những biến cố bất ngờ như pop-up hay lỗi thao tác, cho thấy lỗ hổng bảo mật phổ biến ngay cả ở các mô hình mạnh nhất.

26/08

Thứ Tư · 10 tin
ModelBest OpenBMB@OpenBMB
Nghiên cứuĐiểm AI 36/100

PACE-Bench: Đánh giá khả năng tự thích nghi mã nguồn của AI trong môi trường vật lý biến đổi

Executable Python code can define a vehicle that works on high-friction ground yet spins uselessly o…

DịchNhóm nghiên cứu từ Đại học Thanh Hoa giới thiệu PACE-Bench, bộ tiêu chuẩn đánh giá khả năng điều chỉnh mã nguồn của AI khi các thông số vật lý thay đổi đột ngột. Kết quả cho thấy việc phản hồi dựa trên mô phỏng thực tế hiệu quả hơn nhiều so với việc chỉ tăng cường khả năng suy luận.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnAI có thể tự làm nghiên cứu khoa học? ASI-Bench ra đời để đo lường khả năng tự chủ của AI

ASI-Bench là bộ tiêu chuẩn đánh giá mới do các đại học hàng đầu thế giới phát triển, nhằm đo lường khả năng tự chủ của AI trong việc thực hiện các nghiên cứu khoa học thực thụ thay vì chỉ xử lý dữ liệu có sẵn.


Vì sao đáng đọc: Chủ đề mang tính đột phá về tương lai của AI tự chủ (ASI). Việc kết hợp giữa các đại học danh tiếng tạo nên độ uy tín cao, rất đáng để cộng đồng nghiên cứu quan tâm.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (51 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” — Trang 6 | AIHOT.vn