07/09

Thứ Hai · 6 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 59/100

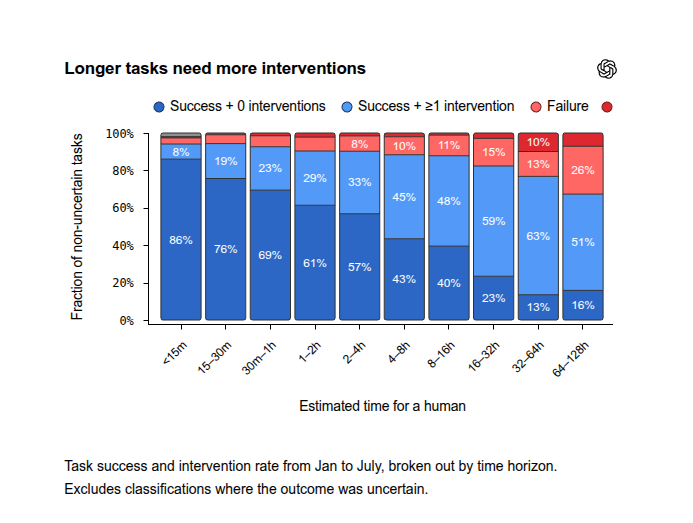
Rohan Paul: 'Thời gian thực thi' là thước đo mới đánh giá năng lực AI Agent

I think "time horizon" is becoming one of the more useful ways to talk about agent capability. At O…

DịchRohan Paul cho rằng thời gian thực thi là chỉ số quan trọng để đo lường AI Agent. Dữ liệu từ OpenAI cho thấy tỷ lệ thành công giảm mạnh từ 86% (nhiệm vụ 15 phút) xuống còn 16% khi kéo dài lên 64-128 giờ.
06/09

Chủ Nhật · 5 tin

05/09

Thứ Bảy · 7 tin
Francois Chollet@fchollet
Hướng dẫnĐiểm AI 64/100

François Chollet chia sẻ bài phân tích về hiệu suất đột phá của OpenAI trên bài kiểm tra ARC-AGI-3

Pour nos lecteurs francophones

DịchFrançois Chollet giới thiệu bài viết từ Le Point về việc mô hình mới của OpenAI đạt điểm gần tuyệt đối trong bài kiểm tra ARC-AGI-3, kèm theo những góc nhìn chuyên sâu từ chính tác giả của bộ tiêu chuẩn đánh giá này.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 49/100

Artificial Analysis cập nhật Intelligence Index v4.2: Bổ sung bộ tiêu chuẩn đánh giá AI mới

Artificial Analysis ra mắt bản cập nhật v4.2, bổ sung AA-Briefcase cho tác vụ trí tuệ nhân tạo và GDP.pdf để kiểm tra khả năng suy luận trên tài liệu dài, đồng thời loại bỏ các bài kiểm tra đã bão hòa.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 45/100

Ethan Mollick chỉ trích cách thay đổi tiêu chuẩn đánh giá của Artificial Analysis v4.2

The whole idea of indexes that you don't change all the criteria in ways that hugely change the rank…

DịchEthan Mollick cho rằng các chỉ số đánh giá AI không nên thay đổi tiêu chuẩn đột ngột làm xáo trộn bảng xếp hạng, đồng thời phê bình việc vẫn giữ lại phương pháp đo lường GDPval-AA thiếu chính xác.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

Scale AI và UC Berkeley giới thiệu khung READY để đánh giá độ tin cậy của AI Agent trong doanh nghiệp

Scale AI + Univ of California paper shows 2 agents can score almost the same yet need very different…

DịchScale AI và Đại học California vừa công bố khung đánh giá READY, giúp đo lường sự cân bằng giữa chi phí vận hành và mức độ giám sát của con người cần thiết để đảm bảo AI Agent hoạt động an toàn trong môi trường doanh nghiệp.

Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Hướng dẫnĐiểm AI 49/100

Artificial Analysis cập nhật Intelligence Index v4.2: Claude 3.5 Sonnet vươn lên dẫn đầu

updated artificial analysis index-muse spark 1.3 max still performs quite well! the efficient front…

DịchBản cập nhật v4.2 bổ sung các bài kiểm tra chuyên sâu về tác vụ trí tuệ và khả năng suy luận tài liệu dài, đồng thời tăng trọng số bộ dữ liệu kiểm thử kín để ngăn chặn tình trạng tối ưu hóa điểm số ảo.

Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 53/100

Artificial Analysis cập nhật Intelligence Index v4.2: Tăng trọng số kiểm thử riêng

Announcing Artificial Analysis Intelligence Index v4.2. We are accelerating elements of our upcoming…

DịchArtificial Analysis ra mắt bản cập nhật v4.2 với trọng số kiểm thử riêng tăng gấp đôi, bổ sung các bài đánh giá mới như AA-Briefcase và GDP.pdf, đồng thời loại bỏ bộ dữ liệu GPQA Diamond đã bão hòa.

04/09

Thứ Sáu · 13 tin
Don't Worry About the Vase (Zvi)
Mô hìnhĐiểm AI 92/100

Tinh chọnGiải mã Claude Fable 5.1 và Mythos 5.1: Đánh giá chi tiết từ tài liệu hệ thống

Tại thời điểm ra mắt, Claude Fable 5.1 được đánh giá là mô hình AI mạnh mẽ nhất thế giới hiện nay. Bài viết phân tích sâu về khả năng và các thông số kỹ thuật từ tài liệu hệ thống của mô hình này.


Vì sao đáng đọc: Đây là phân tích chuyên sâu về mô hình AI hàng đầu, cung cấp cái nhìn kỹ thuật quan trọng cho những người quan tâm đến sự phát triển của các mô hình ngôn ngữ lớn.
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 32/100

Cùng sự kiệnApodex ra mắt TRACES: Bộ tiêu chuẩn đánh giá khả năng khám phá khoa học của AI với các câu hỏi chưa có lời giải

Very important paper accelerating research around AI discovery. https://x.com/omarsar0/status/20958...

DịchTRACES là bộ benchmark mới giúp đo lường năng lực suy luận và khám phá khoa học của các mô hình AI khi đối mặt với những vấn đề chưa được xác thực trong thực tế.

Cùng sự kiện, bài đại diện «Apodex ra mắt TRACES: Bộ tiêu chuẩn đánh giá khả năng giải quyết các bài toán khoa học chưa có lời giải»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 36/100

Cùng sự kiệnApodex ra mắt TRACES: Chuẩn đánh giá khả năng khám phá khoa học của AI

New benchmark from @Apodex_AI worth digging into. TRACES scores AI systems on discoveries where the…

DịchApodex giới thiệu khung Discovery và chuẩn TRACES để đo lường năng lực giải quyết các vấn đề chưa có đáp án xác thực. Với dữ liệu từ 16 ngành công nghiệp, hệ thống này đã vượt qua các mô hình SOTA hiện tại 7% trong lĩnh vực thiết kế protein.

Cùng sự kiện, bài đại diện «Apodex ra mắt TRACES: Bộ tiêu chuẩn đánh giá khả năng giải quyết các bài toán khoa học chưa có lời giải»
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 50/100

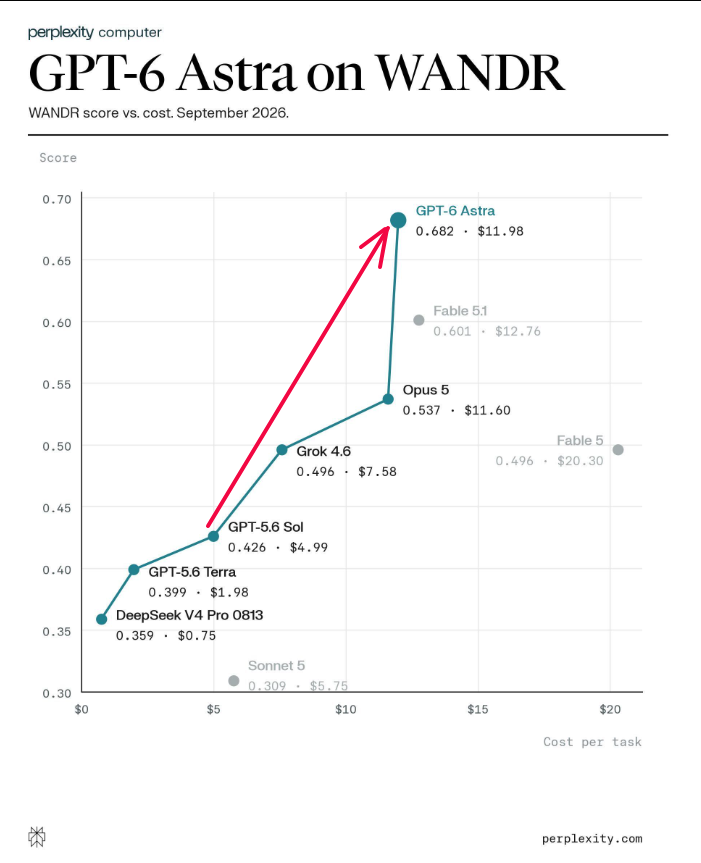
Perplexity đánh giá GPT-6 Astra: Đạt điểm kỷ lục 0.682 trên WANDR

GPT-6 Astra delivered Perplexity's strongest WANDR result yet 13.5% above Fable 5.1 while costing 6…

DịchPerplexity vừa thử nghiệm GPT-6 Astra trên bộ tiêu chuẩn WANDR, đạt số điểm cao nhất 0.682 với chi phí 11.98 USD/tác vụ. Kết quả này vượt trội hơn hẳn so với Fable 5.1 và Opus 5 về cả hiệu suất lẫn tối ưu chi phí.

Gary Marcus: The Road to AI We Can Trust
Hướng dẫnĐiểm AI 73/100

Tinh chọnGary Marcus đánh giá GPT-6 Astra: Bước tiến lớn nhưng vẫn lo ngại về độ tin cậy

Gary Marcus nhận định GPT-6 Astra là bước tiến thực sự khi OpenAI bắt đầu tích hợp mô hình thế giới biểu tượng, củng cố cho quan điểm mà ông theo đuổi suốt thập kỷ qua, dù vẫn còn hoài nghi về tính ổn định và khả năng kiểm soát.


Vì sao đáng đọc: Góc nhìn phản biện từ chuyên gia uy tín về một mô hình mới giúp độc giả có cái nhìn đa chiều, tránh sự thổi phồng quá mức từ truyền thông.
Kim@kimmonismus
Hướng dẫnĐiểm AI 57/100

Cùng sự kiệnARC-AGI 3 đã đạt ngưỡng bão hòa: Cần thiết lập bộ tiêu chuẩn đánh giá mới ngay lập tức

The lesson from today: we need new benchmarks asap.

DịchTác giả của ARC-AGI 3 xác nhận bộ tiêu chuẩn này đã không còn đủ thách thức cho các mô hình AI hiện nay, đồng thời kêu gọi cộng đồng sớm xây dựng các bài kiểm tra năng lực mới.

Cùng sự kiện, tinh chọn hiển thị «ARC-AGI-3 bị chinh phục chỉ sau 6 tháng, tốc độ phát triển AI vượt xa dự đoán»
Perplexity@perplexity_ai
Hướng dẫnĐiểm AI 38/100

Perplexity đánh giá GPT-6 Astra: WANDR dẫn đầu với 0.682 điểm, chi phí 11.98 USD mỗi tác vụ

We evaluated GPT-6 Astra on WANDR. It scored 0.682 at $11.98 per task, the highest score of any mode…

DịchPerplexity công bố kết quả kiểm thử mô hình GPT-6 Astra, trong đó WANDR đạt hiệu suất cao nhất với 0.682 điểm, đi kèm chi phí vận hành 11.98 USD cho mỗi tác vụ đơn lẻ.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
Francois Chollet@fchollet
Hướng dẫnĐiểm AI 62/100

François Chollet: AI đạt điểm tuyệt đối ARC-AGI-3 chỉ sau 6 tháng, xóa tan nghi ngờ về độ khó

Side note: when we released ARC-AGI-3 in March, and frontier models scored <1% on it, a few Singular…

DịchFrançois Chollet khẳng định bộ tiêu chuẩn ARC-AGI-3 được thiết kế chuẩn xác. Việc AI tiến bộ từ dưới 1% lên 100% chỉ trong nửa năm cho thấy tốc độ phát triển trí tuệ nhân tạo đang vượt xa mọi dự đoán ban đầu.

Francois Chollet@fchollet
Hướng dẫnĐiểm AI 81/100

Tinh chọnFrançois Chollet đánh giá hiệu suất của GPT-6 Astra trên bộ đề ARC-AGI-3

GPT-6 Astra represents a step-function change in model capability for interactive reasoning problems…

DịchFrançois Chollet cho biết GPT-6 Astra đạt bước tiến lớn trong suy luận tương tác, ghi 66% trên ARC-AGI-3 và gần 100% khi kết hợp kỹ thuật tối ưu hóa, dù chi phí mỗi lượt lên tới 360 USD.


Vì sao đáng đọc: Thông tin từ chuyên gia hàng đầu về một cột mốc quan trọng trong đánh giá trí tuệ nhân tạo tổng quát (AGI), có giá trị tham khảo cao cho cộng đồng AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sử dụng mô hình ngôn ngữ nhỏ làm giám khảo cho học tăng cường dựa trên tiêu chí

Nghiên cứu đánh giá khả năng thay thế các mô hình lớn bằng các mô hình ngôn ngữ nhỏ (như Qwen3-1.7B) để làm giám khảo chấm điểm trong học tăng cường, giúp giảm chi phí tính toán mà vẫn đảm bảo độ chính xác.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 83/100

Đánh giá GPT-6 Astra: Khả năng lập trình ngang ngửa Fable 5 nhưng chi phí tối ưu hơn

GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to …

DịchArtificial Analysis công bố GPT-6 Astra đạt 67 điểm Coding Agent Index, tương đương Claude Opus 5 và Fable 5, với hiệu suất token vượt trội và chi phí vận hành cạnh tranh hơn nhiều.

03/09

Thứ Năm · 10 tin
Qwen@Alibaba_Qwen
Nghiên cứuĐiểm AI 57/100

Qwen ra mắt E-Commerce Bench: Thử thách AI vận hành cửa hàng trực tuyến trong 1 năm

Meet E-Commerce Bench, a new benchmark for long-horizon autonomous business operations. 🚀 Agents s…

DịchQwen giới thiệu bộ tiêu chuẩn E-Commerce Bench để đánh giá khả năng của AI Agent trong việc tự chủ vận hành kinh doanh dài hạn, từ quản lý kho bãi, đàm phán giá đến tối ưu dòng tiền dựa trên dữ liệu thị trường thực tế.

Gabriel@gabriel1
Hướng dẫnĐiểm AI 14/100

So sánh Grokbot, Cowork và ChatGPT: Đâu là trợ lý tối ưu cho vận hành doanh nghiệp?

for those that have used both these for all daily operational work: - grokbot - cowork or chatgpt wo…

DịchGabriel thực hiện khảo sát người dùng về trải nghiệm thực tế giữa Grokbot, Cowork và ChatGPT trong các tác vụ vận hành hàng ngày, loại trừ các nhu cầu sử dụng cá nhân.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 62/100

Nghiên cứu Skill Following: Chỉ số RAE vạch trần sự thật về khả năng truy xuất kỹ năng của LLM Agent

Good measurement work on whether retrieved agent skills actually help. They report that agent skill…

DịchBài báo giới thiệu chỉ số RAE giúp đánh giá chính xác khả năng sử dụng kỹ năng thực tế của các LLM Agent, thay vì chỉ dựa vào các chỉ số tổng hợp vốn thường che giấu những hạn chế trong quá trình truy xuất.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

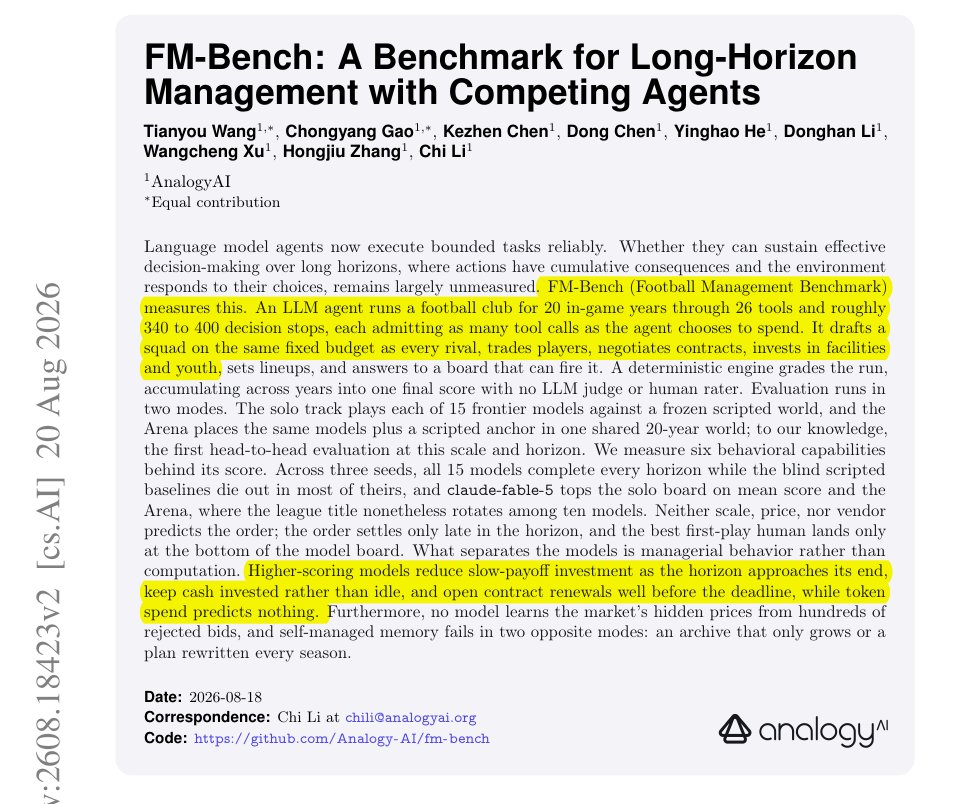
FM-Bench: Thử thách 15 mô hình AI quản lý câu lạc bộ bóng đá trong 20 mùa giải

Current agent benchmarks may be ending before the real failures start. FM-Bench shows that a model …

DịchNghiên cứu FM-Bench đánh giá khả năng ra quyết định dài hạn của 15 mô hình AI hàng đầu thông qua việc quản lý câu lạc bộ bóng đá trong 20 mùa giải, bao gồm các nhiệm vụ phức tạp như chuyển nhượng, hợp đồng và đầu tư tài chính.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AgentJudgeBench: Bộ tiêu chuẩn đánh giá khả năng làm 'giám khảo' của LLM trong các tác vụ dùng công cụ

AgentJudgeBench là bộ tiêu chuẩn đầu tiên đánh giá độ tin cậy của LLM khi đóng vai trò giám khảo cho các quy trình làm việc phức tạp (DAG). Nghiên cứu chỉ ra rằng khả năng đánh giá của LLM giảm dần theo độ khó, đặc biệt khi thiếu dữ liệu đối chứng.

Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 32/100

Trải nghiệm Fable 5.1 và Kimi K3: Khi AI dần trở nên 'người' hơn

Day 1 impressions of Fable 5.1: - talks much more like a normal human now, less Claudish. - web sea…

DịchYuchen Jin đánh giá Fable 5.1 có phong cách giao tiếp tự nhiên hơn, dù khả năng tìm kiếm vẫn thua kém GPT. Đồng thời, ông cho biết Kimi K3 hiện là lựa chọn hàng đầu cho công việc thực tế nhờ hiệu suất vượt mong đợi.

02/09

Thứ Tư · 16 tin
Google AI: DEV tác giả
Hướng dẫnĐiểm AI 65/100

Tinh chọnGoogle chia sẻ cách viết tiêu chí đánh giá chuẩn xác cho mô hình LLM-as-a-Judge

Google hướng dẫn cách xây dựng bộ tiêu chí đánh giá (rubric) cho LLM-as-a-Judge, giúp giảm thiểu sự mơ hồ và lãng phí token. Bài viết nhấn mạnh việc chia nhỏ câu hỏi, tập trung vào dữ kiện khách quan và sử dụng bộ dữ liệu chuẩn để hiệu chỉnh mô hình đạt độ chính xác tương đương con người.


Vì sao đáng đọc: Nội dung thực tế, giải quyết vấn đề nhức nhối trong việc đánh giá AI, có tính ứng dụng cao cho các kỹ sư và nhà phát triển đang làm việc với LLM.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

DramaChain Bench: Bộ tiêu chuẩn đánh giá toàn diện quy trình sản xuất phim ngắn bằng AI

DramaChain Bench là bộ tiêu chuẩn đầu tiên đánh giá toàn bộ quy trình làm phim ngắn từ kịch bản đến thành phẩm. Nghiên cứu chỉ ra rằng chất lượng phim không chỉ phụ thuộc vào video mà còn chịu ảnh hưởng dây chuyền từ các lỗi ở khâu tiền kỳ.

ARC Prize: Blog chính thức
Nghiên cứuĐiểm AI 78/100

Tinh chọnARC Prize công bố kết quả đánh giá GPT-6 Astra trên bộ đề ARC-AGI-3

GPT-6 Astra của OpenAI thiết lập kỷ lục SOTA mới trên ARC-AGI-3 với điểm số ấn tượng, đạt 99.9% ở bài kiểm tra Provider Adapter với chi phí tối ưu.


Vì sao đáng đọc: Đây là cột mốc quan trọng trong việc đo lường trí tuệ nhân tạo tổng quát (AGI), cho thấy bước tiến vượt bậc của GPT-6 trong các bài toán suy luận logic phức tạp.
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

ByteDance giới thiệu HarnessDev: Bước tiến mới giúp LLM tự tạo và tối ưu hóa môi trường kiểm thử Agent

Banger paper from ByteDance Seed. If you are curious about self-evolving agent harnesses, this one …

DịchByteDance Seed công bố HarnessDev, một chuẩn đánh giá mới chuyển dịch từ việc kiểm tra kết quả sang tạo lập và tiến hóa môi trường thực thi (harness) cho AI Agent, giúp tối ưu hóa hiệu suất và chi phí vận hành.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (46 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” — Trang 5 | AIHOT.vn