27/08

Thứ Năm · 6 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 56/100

V-Rubrics: Tối ưu hóa độ trung thực thị giác cho mô hình đa phương thức bằng học tăng cường

V-Rubrics cải thiện độ chính xác của mô hình thị giác-ngôn ngữ bằng cách phân tách câu trả lời thành các mệnh đề nguyên tử và chấm điểm dựa trên độ trung thực, tính nhất quán và khả năng tuân thủ chỉ dẫn, giúp mô hình suy luận tốt hơn thông qua phương pháp GRPO.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Open-MOPD: Giải mã và khắc phục sự mất cân bằng năng lực trong chưng cất mô hình đa giáo viên

Nghiên cứu chỉ ra rằng phương pháp chưng cất đa giáo viên (M-OPD) hiện nay gặp hạn chế lớn trong việc tích hợp năng lực, chỉ đạt 35,6% hiệu suất tối ưu. Nhóm tác giả đề xuất giải pháp khắc phục tình trạng suy giảm chất lượng khi huấn luyện mô hình tổng quát từ các chuyên gia RL.

26/08

Thứ Tư · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OraRL: Tối ưu hóa học tăng cường hiệu quả cho mô hình ngôn ngữ đa phương thức video

Nghiên cứu giới thiệu OraRL, phương pháp mới tận dụng dữ liệu chú giải làm 'oracle rollout' để cải thiện hiệu suất học tăng cường cho mô hình MLLM video, giải quyết vấn đề đảo ngược lợi thế trong quá trình huấn luyện.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

BPCO: Giải pháp tối ưu hóa Critic giúp huấn luyện Reinforcement Learning ổn định hơn

BPCO là phương pháp huấn luyện mới kết hợp nhiều kỹ thuật tiên tiến nhằm khắc phục sự bất ổn trong Reinforcement Learning dựa trên Critic, giúp cải thiện đáng kể khả năng suy luận toán học của các mô hình ngôn ngữ lớn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

OPDVR: Phương pháp chưng cất chính sách không giám sát kết hợp phần thưởng kiểm chứng

OPDVR là phương pháp mới kết hợp học tăng cường dựa trên phần thưởng kiểm chứng (RLVR) với chưng cất chính sách trực tuyến (OPD) mà không cần thêm siêu tham số, giúp tối ưu hóa mô hình hiệu quả hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

CAFE: Khung tự cải thiện cho tác nhân tìm kiếm thông qua cơ chế phản hồi đồng tiến hóa

CAFE là mô hình cho phép tác nhân tìm kiếm và bộ phê bình cùng tiến hóa thông qua học tăng cường trực tuyến và tối ưu hóa ưu tiên, giúp giảm thiểu ảo giác và nâng cao hiệu suất vượt trội trên nhiều tiêu chuẩn đánh giá.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

DiffusionOPSD: Khung tự chưng cất chiến lược trực tuyến cho mô hình khuếch tán

DiffusionOPSD tối ưu hóa mô hình khuếch tán bằng cách chuyển đổi phần thưởng hình ảnh thành mục tiêu dự đoán trực tiếp, giúp cải thiện đáng kể hiệu suất và giảm tới 63% thời gian huấn luyện so với các phương pháp hiện có.

25/08

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vượt xa bắt chước: Tối ưu hóa chưng cất mô hình ngôn ngữ dựa trên tiến trình suy luận

Nghiên cứu đề xuất phương pháp R2-OPD giúp lọc phản hồi từ giáo viên trong quá trình chưng cất mô hình, đảm bảo việc học tập tập trung vào tiến trình suy luận thực tế thay vì chỉ bắt chước đầu ra của giáo viên.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 34/100

Nghiên cứu về tác nhân lập kế hoạch dài hạn: Tiền huấn luyện và chưng cất OPD

No amount of post-training cleanly fixes weak long-horizon foundations: noisy trajectories compound …

DịchNghiên cứu chỉ ra rằng hậu huấn luyện không thể khắc phục lỗi tích lũy trong lập kế hoạch dài hạn. Thay vào đó, việc sử dụng mô hình thế giới rõ ràng và kỹ thuật chưng cất chính sách (OPD) giúp tối ưu hóa phản hồi xuyên suốt quỹ đạo thay vì chỉ dựa vào kết quả cuối cùng.

24/08

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnAgentMercury: Khung tổng hợp môi trường thực thi quy mô lớn cho các kịch bản kinh doanh

AgentMercury là khung làm việc đột phá giúp tự động tạo ra các môi trường kinh doanh thực tế, có thể kiểm chứng thay vì dựa vào các tác vụ thủ công, cho phép huấn luyện AI trong các quy trình công việc phức tạp và đa dạng.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng giải quyết bài toán thiếu hụt dữ liệu môi trường thực tế cho AI tác tử, có tính ứng dụng cao trong doanh nghiệp và quy mô dữ liệu ấn tượng.

23/08

Chủ Nhật · 1 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 31/100

Điểm tin AI tuần này: Đột phá huấn luyện Agent và giải mã nút thắt kỹ năng

Microsoft giới thiệu Agent Lightning v1.0 giúp tích hợp Agent vào học tăng cường mà không cần viết lại code, đồng thời cải thiện đáng kể hiệu suất mô hình Qwen3.5-9B. Ngoài ra, các nghiên cứu mới còn giải quyết tình trạng quá tải kỹ năng và đề xuất phương pháp đo lường hiện tượng 'quên' trong mô hình AI.

22/08

Thứ Bảy · 3 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

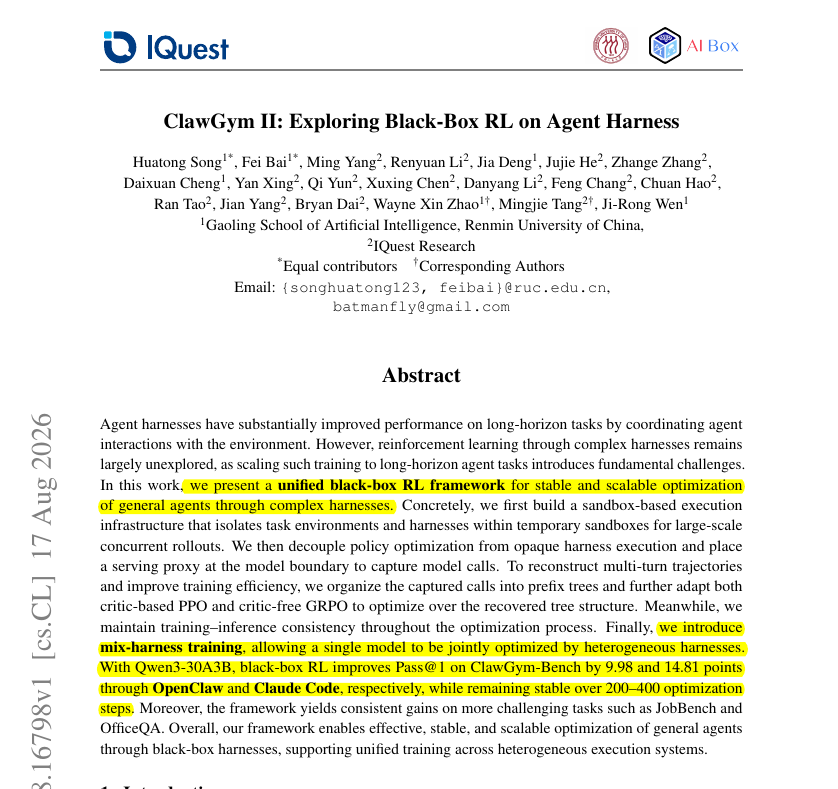
ClawGym II: Tối ưu hóa tác nhân AI thông qua huấn luyện RL hộp đen

You can now RL-train an agent through the same complex harness it will actually run in, without need…

DịchKhung ClawGym II tích hợp OpenClaw và Claude Code như các hệ thống hộp đen vào quy trình huấn luyện RL, giúp cải thiện đáng kể điểm số trên các bộ benchmark như ClawGym-Bench mà không cần can thiệp vào cấu trúc nội tại của mô hình.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

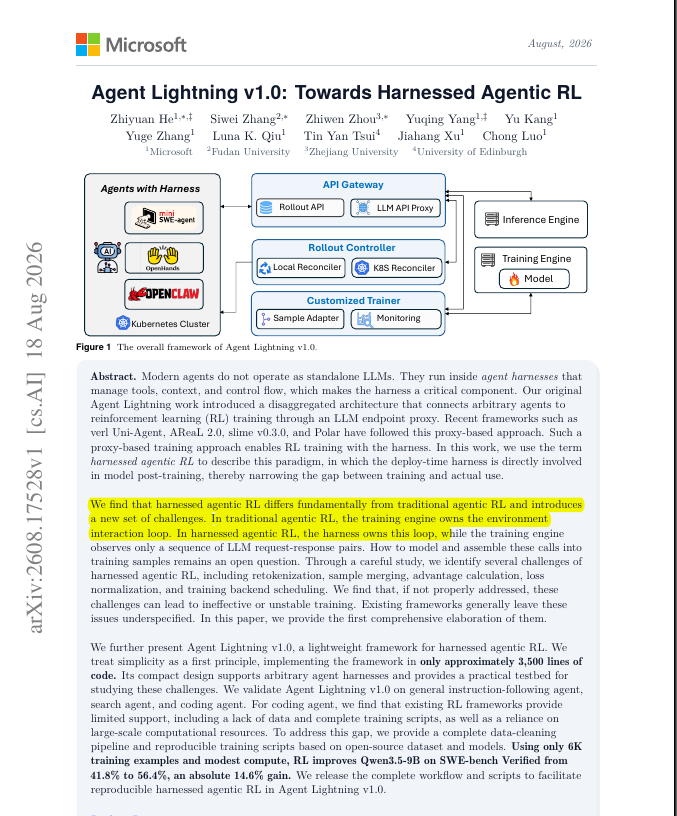
Agent Lightning v1.0: Microsoft đề xuất huấn luyện AI Agent trực tiếp trong môi trường thực tế

New Microsoft paper says agent training should happen inside the agent's normal operating setup. Oth…

DịchMicrosoft giới thiệu Agent Lightning v1.0, khung huấn luyện AI Agent nhẹ giúp tối ưu hóa mô hình ngay trong môi trường triển khai thực tế thay vì mô phỏng, đảm bảo tính nhất quán và hiệu quả cao hơn cho các ứng dụng AI.

21/08

Thứ Sáu · 4 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 30/100

Cùng sự kiệnGoogle giới thiệu EnvHarness và EnvRigger: Bước tiến mới trong huấn luyện môi trường cho AI

Impressive research from Google on building better environments for agents. Training environments f…

DịchGoogle phát triển EnvHarness và EnvRigger nhằm giải quyết hạn chế của các môi trường huấn luyện tĩnh, giúp AI tự thích nghi và tối ưu hóa hiệu suất thông qua việc tái cấu trúc hành vi và chẩn đoán lỗi. Giải pháp này giúp cải thiện đáng kể độ chính xác và rút ngắn thời gian thực thi tác vụ.

Cùng sự kiện, bài đại diện «EnvHarness: Phương pháp huấn luyện AI tự thích nghi với môi trường»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VA-Judger: Mô hình phần thưởng dựa trên phản hồi người dùng cho thế hệ video-âm thanh đồng bộ

VA-Judger giải quyết vấn đề thiếu tính nhất quán trong tạo video-âm thanh bằng cách sử dụng tập dữ liệu VAPref-10K, giúp mô hình hiểu rõ hơn về sự đồng bộ ngữ nghĩa và cảm nhận của con người thay vì chỉ tối ưu các chỉ số rời rạc.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 25/100

SPADE: Phương pháp tự đối đầu cho tác nhân AI trong môi trường tổng hợp thích ứng

SPADE: Self-Play in Adaptive Synthetic Executable Environments

DịchSPADE là phương pháp huấn luyện tác nhân tự đối đầu, nơi chính AI sẽ tạo ra và cải tiến các môi trường cũng như nhiệm vụ của mình dựa trên chỉ số hối tiếc (regret). Đây là bước tiến quan trọng trong việc giúp AI tự quyết định lộ trình học tập tối ưu.

20/08

Thứ Năm · 7 tin
The Decoder: AI News
Hướng dẫnĐiểm AI 56/100

Huyền thoại AI Richard Sutton: Dữ liệu tổng hợp là 'sai lầm lớn', LLM đang đâm đầu vào ngõ cụt

Richard Sutton, cha đẻ học tăng cường, cho rằng dữ liệu tổng hợp không thể thay thế trải nghiệm thực tế. Ông khẳng định AI cần học hỏi từ tương tác trực tiếp với thế giới thay vì chỉ dựa vào kho dữ liệu tĩnh trên internet.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

SkillGate: Tối ưu hóa lựa chọn kỹ năng cho tác nhân AI dài hạn

SkillGate giải quyết vấn đề thiếu tín hiệu huấn luyện khi tác nhân AI chọn kỹ năng giữa chừng bằng cách tách biệt tín hiệu kết quả và lợi thế hành động, giúp tăng tỷ lệ thành công từ 40,8% lên 53,2%.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Co-RL: Đột phá khả năng suy luận không cần giám sát nhờ đa dạng hóa tác nhân trong học tăng cường

Co-RL là khung học tăng cường đa tác nhân mới, cho phép các mô hình tự tối ưu hóa thông qua tín hiệu phần thưởng lẫn nhau mà không cần nhãn. Việc tăng cường tính đa dạng của nhóm giúp giảm lỗi phản hồi và cải thiện đáng kể hiệu suất trên các tác vụ văn bản và đa phương thức.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 42/100

Căn chỉnh thước đo quyết định trong mô hình thế giới tiềm ẩn: Chẩn đoán và tối ưu hóa lập kế hoạch MPC

Nghiên cứu giới thiệu hai chỉ số chẩn đoán mới để khắc phục sự lệch pha giữa khoảng cách tiềm ẩn và tiến độ thực tế trong các mô hình thế giới (LeWM), từ đó cải thiện tốc độ hội tụ và hiệu suất của tác nhân AI.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SPADE: Khung tự đối kháng giúp LLM tự thiết kế môi trường huấn luyện tối ưu

SPADE cho phép một LLM đóng vai trò kép: vừa là người thiết kế môi trường, vừa là tác nhân suy luận, giúp tự động tạo ra các bài kiểm tra ở ngưỡng năng lực để tối ưu hóa hiệu suất mô hình. Phương pháp này cải thiện đáng kể khả năng sử dụng công cụ và giải quyết vấn đề trên nhiều tiêu chuẩn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

LEGO-RL: Khung học tăng cường nguyên bản cho các tác nhân lập trình AI

LEGO-RL là khung làm việc mới giúp tối ưu hóa các tác nhân lập trình AI mà không cần can thiệp vào luồng điều khiển, giải quyết triệt để các vấn đề về lỗi môi trường, thao túng phần thưởng và sự thiếu nhất quán giữa huấn luyện và suy luận.

19/08

Thứ Tư · 8 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 36/100

Agent Lightning v1.0 của Microsoft giúp tăng 14,6% khả năng lập trình cho Qwen3.5-9B

Very interesting new work from Microsoft. (bookmark it) This work is related to this emerging them…

DịchNghiên cứu mới từ Microsoft giới thiệu Agent Lightning v1.0, giúp tối ưu hóa hậu huấn luyện mô hình. Chỉ với 6.000 mẫu dữ liệu, hiệu suất của Qwen3.5-9B trên SWE-bench Verified đã tăng vọt từ 41,8% lên 56,4%.

Kim@kimmonismus
Hướng dẫnĐiểm AI 40/100

GLM-5.3 chứng minh: Sức mạnh AI không chỉ nằm ở số lượng tham số

Interesting take by the zAI (GLM-Models) founder: AI scaling is not over, but we just focused too mu…

DịchNhà sáng lập Zhipu AI khẳng định việc tối ưu hóa dữ liệu và huấn luyện hậu kỳ (RL) quan trọng hơn việc chỉ tăng quy mô tham số, minh chứng qua bước nhảy vọt về hiệu năng của GLM-5.3 so với bản tiền nhiệm.

Gabriel@gabriel1
NgànhĐiểm AI 69/100

Cùng sự kiệnOpenAI tạm dừng huấn luyện RL tiên tiến để ưu tiên an toàn và kiểm soát

i have always felt openai taking safety where it matters very seriously i trust sam & team a lo…

DịchOpenAI quyết định tạm dừng một phần quá trình huấn luyện học tăng cường (RL) để đảm bảo các tiêu chuẩn an toàn bắt kịp tốc độ phát triển của mô hình, đồng thời kêu gọi sự phối hợp toàn ngành về các quy chuẩn an toàn AI.

Cùng sự kiện, bài đại diện «OpenAI tạm dừng huấn luyện mô hình tiên tiến để tăng cường kiểm soát an toàn»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Sản phẩmĐiểm AI 66/100

Agent Lightning v1.0: Bước tiến mới trong huấn luyện tác nhân AI bằng học tăng cường

Agent Lightning v1.0 là khung làm việc nhẹ giúp tối ưu hóa tác nhân AI qua học tăng cường (RL). Chỉ với 6.000 mẫu huấn luyện, công cụ này đã giúp Qwen3.5-9B tăng điểm số trên SWE-bench Verified từ 41,8% lên 56,4%.

SemiAnalysis@SemiAnalysis_
Sản phẩmĐiểm AI 31/100

RadixArk ra mắt Miles v0.1: Khung huấn luyện tăng cường mã nguồn mở cho LLM

Congrats RadixArk on the launch! https://x.com/radixark/status/2089746481339384068

DịchRadixArk giới thiệu Miles v0.1, khung học tăng cường tối ưu cho LLM và mô hình đa phương thức, giúp giải quyết bài toán khó trong huấn luyện và hiệu suất phần cứng. Dự án đã được kiểm chứng trên các mô hình hàng đầu như DeepSeek V4 và Qwen.

MiniMax@MiniMax_AI
Sản phẩmĐiểm AI 26/100

MiniMax chúc mừng SGLang/RadixArk ra mắt khung huấn luyện tăng cường Miles v0.1

Congrats to our long-term partner SGLang/RadixArk on the launch of Miles v0.1! 🎉 From M-Series to …

DịchMiniMax chúc mừng đối tác chiến lược SGLang/RadixArk phát hành Miles v0.1, khung mã nguồn mở hỗ trợ huấn luyện mô hình ngôn ngữ và đa phương thức, đã được kiểm chứng trên các dòng model tiên tiến như Kimi, DeepSeek và MiniMax.

Thêm 1 nguồn khác đưa tinX: SemiAnalysis (@SemiAnalysis_)
OpenAI@OpenAI
NgànhĐiểm AI 66/100

OpenAI tạm dừng huấn luyện RL trên các mô hình tiên tiến để tăng cường an toàn

As models become more capable, the risks associated with developing and testing them internally also…

DịchOpenAI đã tạm dừng huấn luyện học tăng cường (RL) cho các mô hình mới nhất trong hai tuần nhằm củng cố môi trường nghiên cứu và mở rộng thử nghiệm an toàn, sau khi nhận thấy rủi ro gia tăng từ năng lực mô hình.

Diễn biến sự kiện · 2 bài →Thêm 1 nguồn khác đưa tinTechCrunch: AI

18/08

Thứ Ba · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SA-MRPO: Phương pháp tối ưu hóa đa mục tiêu trong học tăng cường giúp tránh lãng phí tài nguyên tính toán

SA-MRPO giải quyết vấn đề các mục tiêu đã bão hòa vẫn tiêu tốn tài nguyên bằng cách chuẩn hóa độc lập và điều chỉnh trọng số thích ứng, giúp cải thiện hiệu suất đáng kể trong các bài toán suy luận và lập trình.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

Bài toán Kẻ trộm du lịch kết hợp Drone (TTP-D): Tối ưu hóa đồng bộ lộ trình và vận chuyển hàng hóa

Nghiên cứu giới thiệu bài toán TTP-D, tối ưu hóa đồng thời việc chọn vật phẩm, lộ trình xe và drone để tối đa hóa lợi nhuận. Nhóm tác giả đề xuất mô hình lập trình tuyến tính hỗn hợp và chiến lược học tăng cường dựa trên cơ chế chú ý để giải quyết các bài toán quy mô lớn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

ClawGym II: Đột phá học tăng cường hộp đen cho tác nhân AI

Nghiên cứu giới thiệu khung học tăng cường hộp đen mới, giúp tối ưu hóa hiệu suất của các tác nhân AI như Qwen3 trên các môi trường phức tạp, cải thiện đáng kể tỷ lệ giải quyết tác vụ thực tế.

17/08

Thứ Hai · 2 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (76 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “học tăng cường” — Trang 4 | AIHOT.vn