18/09

Thứ Sáu · 5 tin
Epoch AI@EpochAIResearch
Nghiên cứuĐiểm AI 48/100

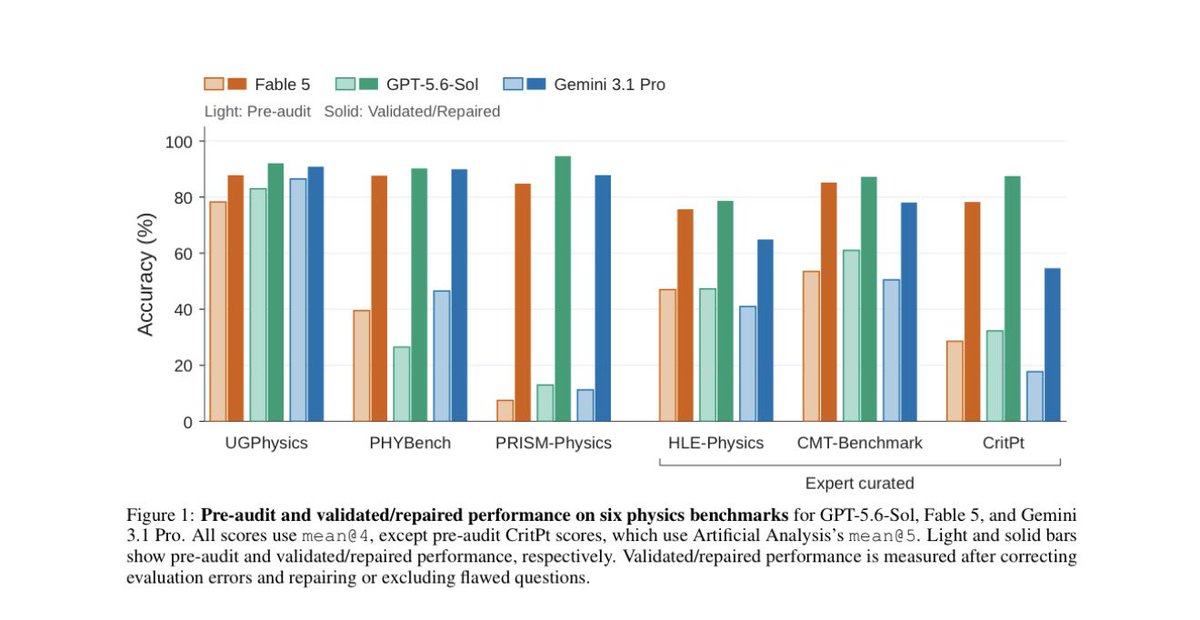
Epoch AI khởi động dự án đánh giá tính minh bạch của các bộ tiêu chuẩn AI

Introducing Benchmark Reviews: our new initiative to audit AI benchmarks. We are launching with 15 b…

DịchEpoch AI vừa ra mắt chương trình 'Benchmark Reviews' nhằm kiểm định chất lượng các bộ tiêu chuẩn đo lường AI. Trong đợt đầu, họ đã đánh giá 15 bộ tiêu chuẩn, kết quả cho thấy 4 cái đạt chuẩn, 9 cái có khiếm khuyết và 2 cái chưa đủ dữ liệu.

17/09

Thứ Năm · 2 tin
karminski@karminski3
Mô hìnhĐiểm AI 29/100

Giải mã mô hình ẩn danh union-alpha trên OpenRouter: Liệu có phải là siêu phẩm?

Thử nghiệm trên mô hình ẩn danh union-alpha cho thấy hiệu năng không đạt chuẩn flagship 2026. Việc sử dụng thư viện three.js cũ kỹ (r127) thay vì các phiên bản mới nhất cho thấy đây khó có thể là sản phẩm từ các ông lớn như OpenAI, Anthropic hay các đơn vị dẫn đầu tại Trung Quốc.

16/09

Thứ Tư · 12 tin
Ethan Mollick@emollick
Quan điểmĐiểm AI 48/100

Khủng hoảng niềm tin: Các bài kiểm tra đánh giá AI hiện nay đang dần mất đi giá trị

The state of public AI benchmarking is dire and is undermining our ability to understand how good AI…

DịchCác bộ tiêu chuẩn đánh giá AI công khai đang trở nên lỗi thời và thiếu chính xác, khiến việc đo lường năng lực thực tế của các mô hình AI trở nên khó khăn và dễ gây hiểu lầm.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 49/100

Google Research ra mắt Fuse: Khung đánh giá khả năng suy luận xã hội của LLM

Banger paper from Google Research. This one is on how LLM assistants reason about the people in a u…

DịchGoogle Research giới thiệu Fuse, khung đánh giá khả năng suy luận xã hội của LLM thông qua các kịch bản mô phỏng. Kết quả cho thấy các mô hình dễ bị ảnh hưởng bởi định kiến từ người dùng và độ dài hội thoại không đảm bảo cải thiện độ chính xác.

Thêm 1 nguồn khác đưa tinHugging Face Daily Papers
JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

Harness Evolution cho AI Agent: Liệu có thực sự hiệu quả hơn việc chạy thử nhiều lần?

Nghiên cứu mới từ AI2 và ĐH Washington chỉ ra rằng các phương pháp tự tiến hóa (Harness Evolution) phức tạp của AI Agent thường không vượt trội hơn so với chiến lược chạy thử nhiều lần (test-time scaling) đơn giản khi xét trên cùng ngân sách suy luận.

IT Home
NgànhĐiểm AI 40/100

Cùng sự kiệnZuckerberg: Đảm bảo an toàn AI cần đánh giá độc lập, không phải kìm hãm phát triển

CEO Meta khẳng định an toàn AI nên dựa vào các đơn vị đánh giá độc lập thay vì làm chậm tiến độ công nghệ. Ông nhấn mạnh việc tối ưu hóa sự an toàn và tin cậy chính là lợi thế cạnh tranh cốt lõi để các mô hình AI tồn tại và phát triển bền vững.

Cùng sự kiện, bài đại diện «Meta ra mắt Muse Spark 1.3, tích hợp vào Muse Code và Meta Model API»
JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

Amap kết hợp các đại học hàng đầu ra mắt WorldRoamBench: Chuẩn mực mới đánh giá mô hình thế giới tương tác dài hạn

WorldRoamBench là bộ tiêu chuẩn đánh giá toàn diện khả năng duy trì tính nhất quán, vật lý và trí nhớ của các mô hình thế giới tương tác trong thời gian dài, giải quyết lỗ hổng của các bài kiểm tra ngắn hạn hiện nay.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 66/100

Cùng sự kiệnĐánh giá Gemini 3.8 Live: Phiên bản Extended Thinking thống trị bảng xếp hạng giọng nói

Google has released Gemini 3.8 Live, its new Speech to Speech model, with the Extended Thinking (Hig…

DịchArtificial Analysis công bố Gemini 3.8 Live (bản Extended Thinking) đã vươn lên dẫn đầu bảng xếp hạng Speech to Speech Index với 82.6 điểm và đạt hiệu suất 68.6% trên Tau Voice.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.8 Live và bản Extended Thinking: Đột phá mới cho trợ lý giọng nói»

15/09

Thứ Ba · 6 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

ModaLens: Phương pháp kiểm định mới đánh giá độ phụ thuộc vào hình ảnh của mô hình VLM y tế

Nghiên cứu giới thiệu ModaLens, kỹ thuật thay thế hình ảnh theo cặp để đo lường mức độ ảnh hưởng của báo cáo chẩn đoán đến khả năng phân tích hình ảnh thực tế của các mô hình thị giác ngôn ngữ (VLM) trong y tế.

Tencent Hunyuan@TencentHunyuan
NgànhĐiểm AI 45/100

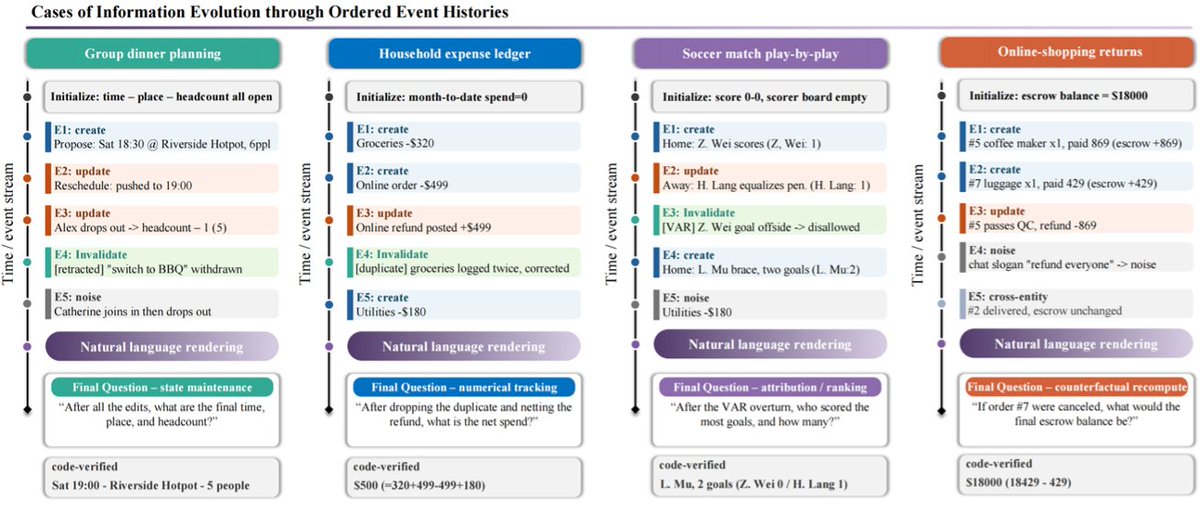
Tencent Hunyuan ra mắt EvolveScaler: Chuẩn đánh giá khả năng xử lý thông tin tiến hóa của AI

🚀 EvolveScaler is here. Read a 40-day RPG log. Now answer one question: if you skip the mini-boss …

DịchTencent Hunyuan giới thiệu EvolveScaler, bộ tiêu chuẩn mới mô phỏng các kịch bản thông tin phức tạp như chỉnh sửa, thu hồi và cập nhật dữ liệu. Công cụ này giúp kiểm tra khả năng suy luận logic của AI và cải thiện đáng kể hiệu suất trên nhiều tác vụ thực tế.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 60/100

Phân tích Elo-per-token: Hiệu suất giảm dần của chiến lược tính toán trên LLM Agent

Nghiên cứu giới thiệu phương pháp Elo-per-token sử dụng mô hình Bradley-Terry để đánh giá hiệu quả của việc tăng cường tài nguyên tính toán trong quá trình suy luận của LLM Agent, từ đó chỉ ra quy luật lợi nhuận giảm dần.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 44/100

VoiceArena ra mắt Jarvis Bench v0.5: Chuẩn mực mới đánh giá tác nhân AI giọng nói

I really like how @voicearena_ai designed this evaluation. Instead of asking whether one voice mode…

DịchJarvis Bench v0.5 đánh giá tác nhân AI qua độ hoàn thành nhiệm vụ và sự tự nhiên bằng phương pháp đối chứng với con người. Kết quả cho thấy AI đã tiệm cận con người về khả năng hoàn thành tác vụ, nhưng vẫn còn khoảng cách lớn về sự tự nhiên trong giao tiếp.

Emad Mostaque@EMostaque
NgànhĐiểm AI 20/100

Emad Mostaque cảnh báo: Các tổ chức đánh giá AI đối mặt với nguy cơ tấn công cấp quốc gia

Gonna have to be real careful

DịchCựu CEO Stability AI cảnh báo các tổ chức như METR cần chuẩn bị kỹ lưỡng về an ninh mạng, vì họ đang trở thành mục tiêu tấn công của các thế lực cấp quốc gia khi nắm giữ các tiêu chuẩn đánh giá AI quan trọng.

14/09

Thứ Hai · 8 tin
Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 44/100

Artificial Analysis ra mắt chỉ số năng lực AI v1.1: Đánh giá chuyên sâu theo từng ngành nghề

Announcing Artificial Analysis Capability Indices v1.1, updated with stronger domain tuning, combini…

DịchArtificial Analysis cập nhật chỉ số năng lực v1.1, kết hợp dữ liệu O*NET để đo lường hiệu suất AI trong 6 lĩnh vực chuyên môn như tài chính, luật và y tế dựa trên Intelligence Index v4.3.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 62/100

Nghiên cứu GAUGE từ Amazon: Khi nào không nên tin tưởng vào LLM Judge để đánh giá AI Agent?

Great paper from Amazon. In discusses when not to trust LLM judges for agent evaluation. (bookmark…

DịchAmazon chỉ ra rằng việc dùng LLM làm giám khảo (LLM judge) thường gây hiểu lầm: 57,5% cuộc hội thoại được đánh giá 'hài lòng' thực tế lại thất bại trong việc hoàn thành nhiệm vụ, đồng thời độ chính xác của phương pháp này giảm mạnh khi so sánh các AI có năng lực tương đương.

Ethan Mollick@emollick
NgànhĐiểm AI 39/100

Ethan Mollick đề xuất dùng các câu đố lịch sử để kiểm chứng năng lực AI

For all the focus on hard math, we should also have a bank of historical mysteries and cyphers that …

DịchThay vì chỉ tập trung vào toán học, Ethan Mollick gợi ý xây dựng kho dữ liệu các câu đố và mật mã lịch sử để thử thách khả năng suy luận của AI, hỗ trợ các nhà sử học giải mã những văn bản cổ chưa được dịch.

OpenRouter: Announcements
Hướng dẫnĐiểm AI 61/100

Tinh chọnHướng dẫn OpenRouter: Tự động đánh giá đầu ra của AI Agent bằng phương pháp LLM-as-a-judge

OpenRouter chia sẻ cách sử dụng mô hình AI làm giám khảo để chấm điểm tự động cho các phản hồi của AI Agent, giúp kiểm soát chất lượng các câu trả lời mở mà phương pháp kiểm thử truyền thống không làm được.


Vì sao đáng đọc: Đây là kỹ thuật thực tiễn cao cho các nhà phát triển AI, giúp tối ưu hóa quy trình kiểm thử và nâng cao chất lượng phản hồi của Agent một cách tự động.
Hacker News: AI bài nổi bật
Nghiên cứuĐiểm AI 64/100

Nghiên cứu từ Princeton: AI vẫn chưa thể tự mình thực hiện các nghiên cứu khoa học mở

Nhóm nghiên cứu tại Princeton đã thử nghiệm cho AI tự thực hiện các nghiên cứu khoa học, kết quả cho thấy dù tốn kém ngân sách và thời gian, AI vẫn chưa thể thay thế con người trong việc tự chủ nghiên cứu chuyên sâu.

Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 46/100

Artificial Analysis trở thành đối tác đánh giá chính thức cho các mô hình AI chủ quyền của Hàn Quốc

Artificial Analysis is proud to support the Korean Government as an official evaluation partner for …

DịchArtificial Analysis đã ký thỏa thuận với chính phủ Hàn Quốc để trở thành đơn vị đánh giá độc lập cho các dự án AI quốc gia, với chỉ số đo lường của họ chiếm 25% trọng số trong các cuộc thi AI tại nước này.

13/09

Chủ Nhật · 8 tin
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Hướng dẫnĐiểm AI 55/100

Meta Muse Spark 1.3 Max gây ấn tượng mạnh trong bài kiểm tra sửa lỗi phần mềm thực tế

muse code + muse spark 1.3 max is really good at real-world software engineering

DịchAlexandr Wang chia sẻ kết quả thử nghiệm cho thấy Muse Spark 1.3 Max đã sửa thành công 33/105 lỗi trong các kho lưu trữ thực tế, ngang bằng với Fable 5.1 và vượt qua Grok 4.6 cùng Opus 5, khẳng định vị thế của Meta trong lĩnh vực AI lập trình.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 47/100

Cảnh báo từ kỹ sư phần mềm: Rủi ro tiềm ẩn khi AI tự đánh giá và lập trình

Các kỹ sư cảnh báo rằng việc phụ thuộc vào AI để tự đánh giá và lập trình tạo ra nhiều rủi ro 'ẩn'. Do dữ liệu huấn luyện chứa đầy các thói quen xấu từ người dùng không chuyên, AI dễ tạo ra mã nguồn dư thừa và thiếu tối ưu, gây ảnh hưởng đến toàn bộ hệ thống đánh giá tự động.

Ethan Mollick@emollick
NgànhĐiểm AI 27/100

Khi AI ngày càng thông minh, việc đánh giá năng lực thực sự trở nên khó khăn hơn

One of the downsides in AI getting so good is that it is getting harder to demonstrate its strengths…

DịchSự tiến bộ vượt bậc của AI khiến ranh giới giữa ưu và nhược điểm trở nên mờ nhạt. Người dùng cần có kiến thức chuyên môn sâu mới có thể nhận diện được những hạn chế tinh vi mà các mô hình hiện đại đang che giấu.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 40/100

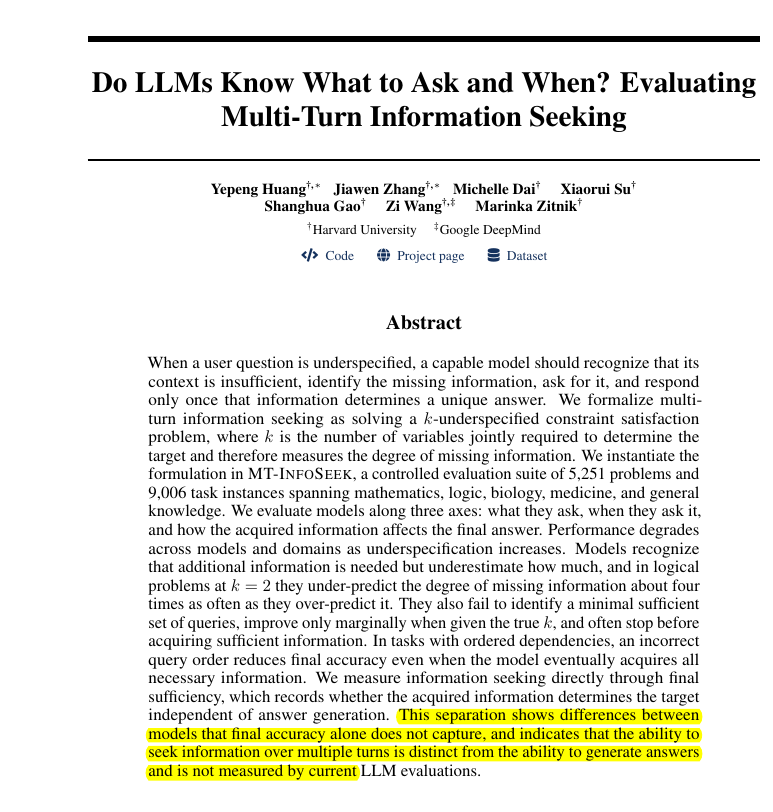
Nghiên cứu mới: Đánh giá khả năng đặt câu hỏi và thu thập thông tin của LLM

LLMs frequently underestimate how much information they need, so test when they stop instead of rely…

DịchNghiên cứu chỉ ra rằng LLM thường dừng thu thập thông tin quá sớm dù trả lời đúng nhờ kiến thức sẵn có. Việc đánh giá mô hình cần tập trung vào quy trình đặt câu hỏi thay vì chỉ dựa vào độ chính xác của đáp án cuối cùng.

Nathan Lambert@natolambert
Hướng dẫnĐiểm AI 58/100

Nathan Lambert sẵn sàng làm bên thứ ba đánh giá độc lập cho các mô hình AI

I would consider helping as an independent evaluator along with the non profit I'm building. Is goin…

DịchNathan Lambert ủng hộ cam kết của Anthropic trong việc cấp quyền truy cập hệ thống cho các bên đánh giá độc lập, đồng thời bày tỏ sẵn sàng đảm nhận vai trò này thông qua tổ chức phi lợi nhuận của mình.

Dex Horthy (HumanLayer)@dexhorthy
NgànhĐiểm AI 30/100

Đánh giá SlopCodeBench: So sánh hiệu năng GLM 5.3, Sol 5.6 và Astra

finally finished a full SlopCodeBench run against GLM 5.3, Sol 5.6, and Astra (Fable 5.1 results com…

DịchDex Horthy đã hoàn tất bài kiểm tra SlopCodeBench trên các mô hình mới. Kết quả cho thấy Astra vượt trội hơn GPT-5.5 nhưng không đáng kể, trong khi Sol gây bất ngờ với điểm số thấp hơn dự kiến do xu hướng 'mất kiểm soát' ở chế độ tư duy cao.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

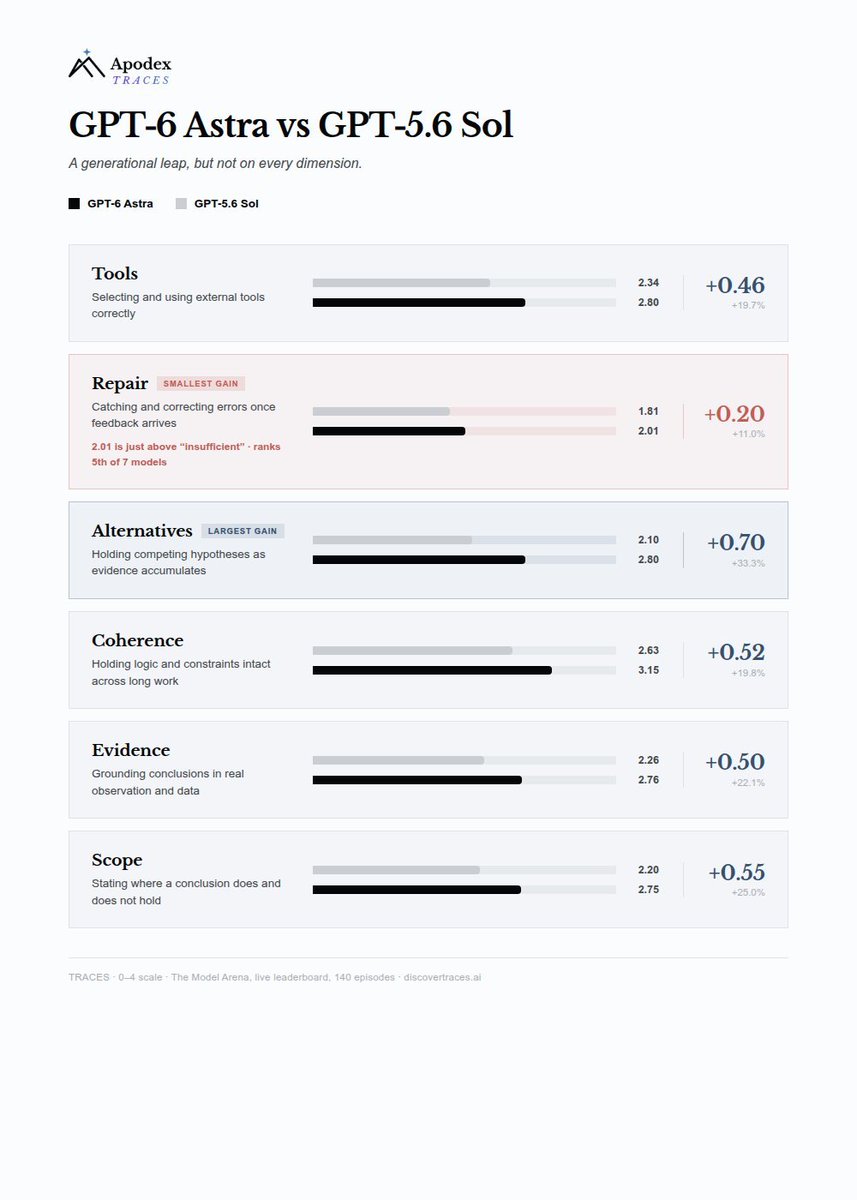
GPT-6 Astra dẫn đầu bảng xếp hạng TRACES về khả năng khám phá khoa học

A benchmark for difficult scientific discovery from @tianqiao_chen now shows GPT-6 Astra improving a…

DịchApodex AI giới thiệu bộ tiêu chuẩn TRACES, đánh giá toàn diện năng lực giải quyết các vấn đề khoa học phức tạp của AI dựa trên 6 tiêu chí chuyên sâu thay vì chỉ dựa vào điểm số tổng quát.

12/09

Thứ Bảy · 7 tin
ZHO@ZHO_ZHO_ZHO
Hướng dẫnĐiểm AI 66/100

Cùng sự kiệnTrải nghiệm thực tế GPT Images 2.5: Phân tích từ 730 ảnh và 5 vấn đề cốt lõi

Tác giả Zho đã thực hiện bài test cường độ cao với 730 ảnh tạo bởi GPT Images 2.5, đạt tỷ lệ thành công 96,6% và đánh giá chi tiết về khả năng chỉnh sửa chuyên sâu.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt ChatGPT Images 2.5: Tạo ảnh nhanh hơn, sắc nét và thông minh hơn»
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

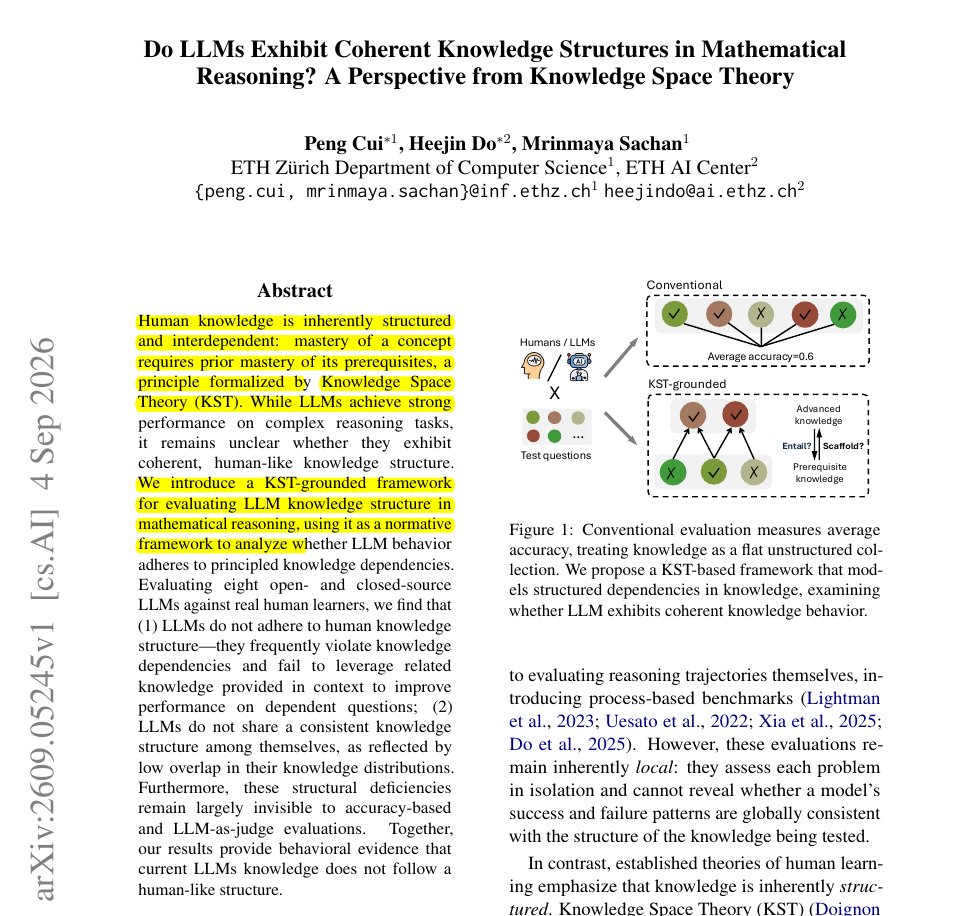
Nghiên cứu: LLM đạt điểm cao nhưng hổng kiến thức nền, Qwen3-80B chỉ đạt 48% độ nhất quán

Humans usually need the foundations before the advanced skill; we need to know the basics before the…

DịchNghiên cứu cho thấy dù Qwen3-80B đạt điểm cao hơn con người trong các bài kiểm tra, nhưng chỉ 48% câu trả lời đúng của nó đảm bảo được tính logic từ các kiến thức nền tảng, cho thấy mô hình AI hiện nay dễ bị 'học vẹt' thay vì hiểu sâu.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (42 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” — Trang 3 | AIHOT.vn