17/09

Thứ Năm · 14 tin
Apple Machine Learning Research
Nghiên cứuĐiểm AI 42/100

REVERSAL-BENCH: Apple nghiên cứu 'vực thẳm' trong học tăng cường không cần reset

Apple giới thiệu REVERSAL-BENCH, bộ công cụ đo lường khả năng phục hồi trạng thái của AI trong môi trường vật lý, giúp xác định giới hạn an toàn khi huấn luyện các tác nhân học tăng cường mà không cần thiết lập lại trạng thái ban đầu.

AI Notes@AYi_AInotes
Nghiên cứuĐiểm AI 36/100

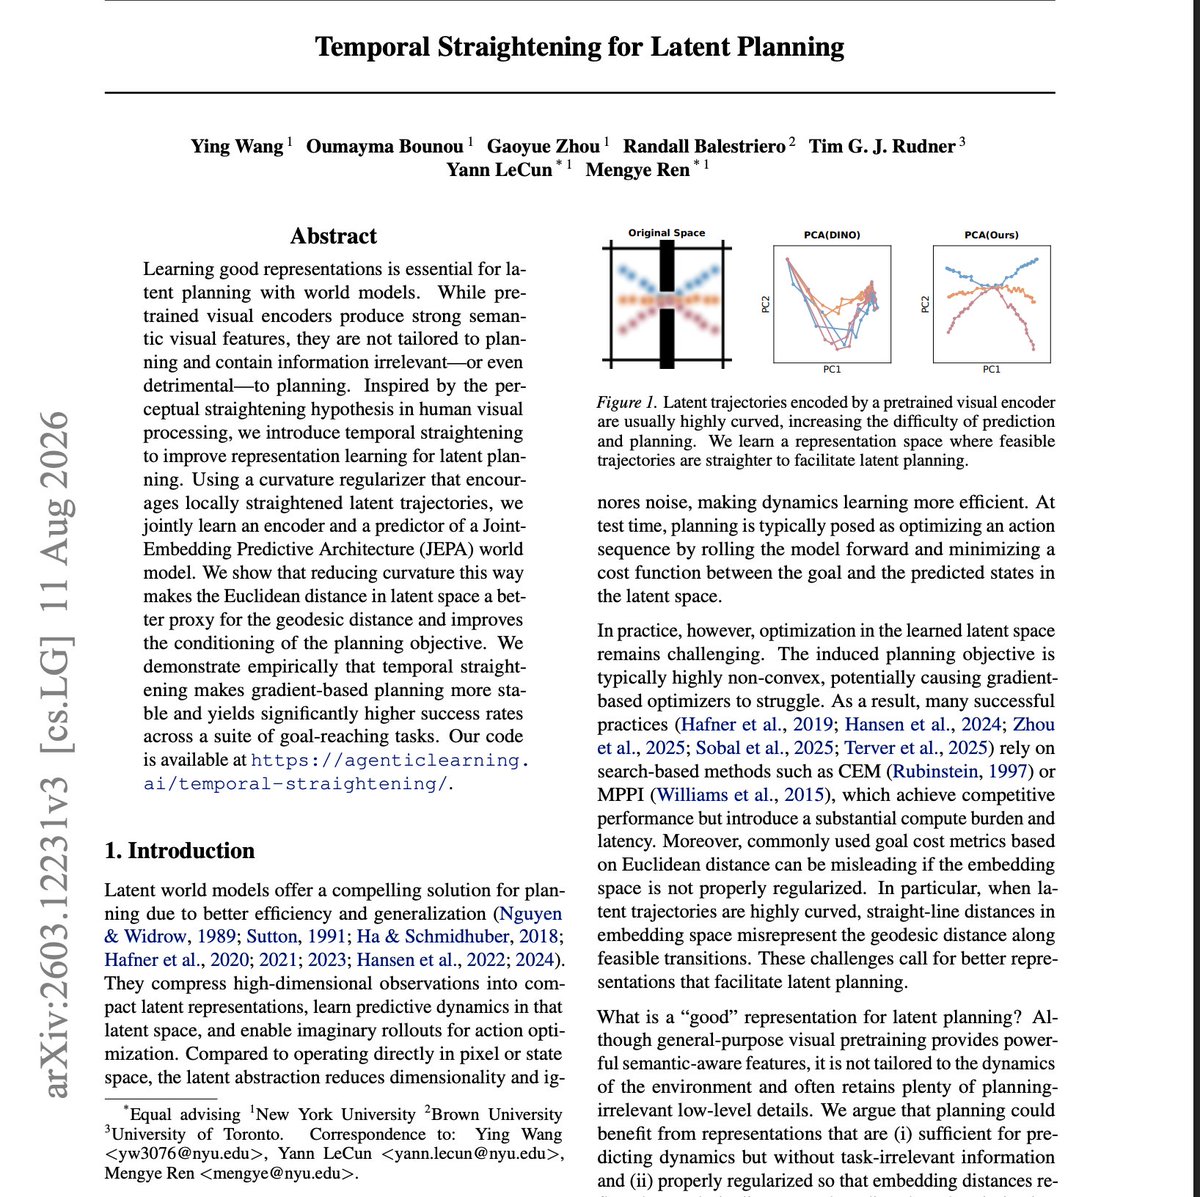
Đội ngũ của Yann LeCun chỉ ra 'điểm mù hình học' trong học tăng cường

Nhóm nghiên cứu của LeCun phát hiện các thuật toán học tăng cường truyền thống gặp lỗi vật lý do dùng không gian Euclid. Bằng cách áp dụng mô hình thế giới JEPA trên không gian phi Euclid, họ giúp robot lập kế hoạch di chuyển chính xác hơn, tăng hiệu suất học tập lên gấp nhiều lần.

Pandaily
Sản phẩmĐiểm AI 88/100

Tinh chọnScalabot ra mắt HERON-CRA: Bước tiến đột phá trong điều khiển robot với bộ nhớ ngữ cảnh và RL

HERON-CRA của Scalabot kết hợp bộ nhớ 4D, công cụ học tăng cường (RL) và tiền huấn luyện đa hình thái, giúp nâng tỷ lệ thành công khi gấp tất từ 38,5% lên 97,8%.


Vì sao đáng đọc: Công nghệ đột phá trong lĩnh vực robot học (embodied AI) với kết quả thực nghiệm ấn tượng, mang tính ứng dụng cao trong tự động hóa gia đình.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 35/100

Tối ưu hóa PPO: Giải mã hiện tượng 'phẳng hóa giá trị' và giải pháp SP3O đột phá

Nghiên cứu chỉ ra lỗi 'phẳng hóa giá trị' khiến mô hình PPO dự đoán thiếu chính xác. Giải pháp SP3O giúp khắc phục bằng cách giám sát chọn lọc các trạng thái quan trọng, giúp cải thiện hiệu suất đáng kể trên các mô hình ngôn ngữ lớn.

IT Home
Mô hìnhĐiểm AI 47/100

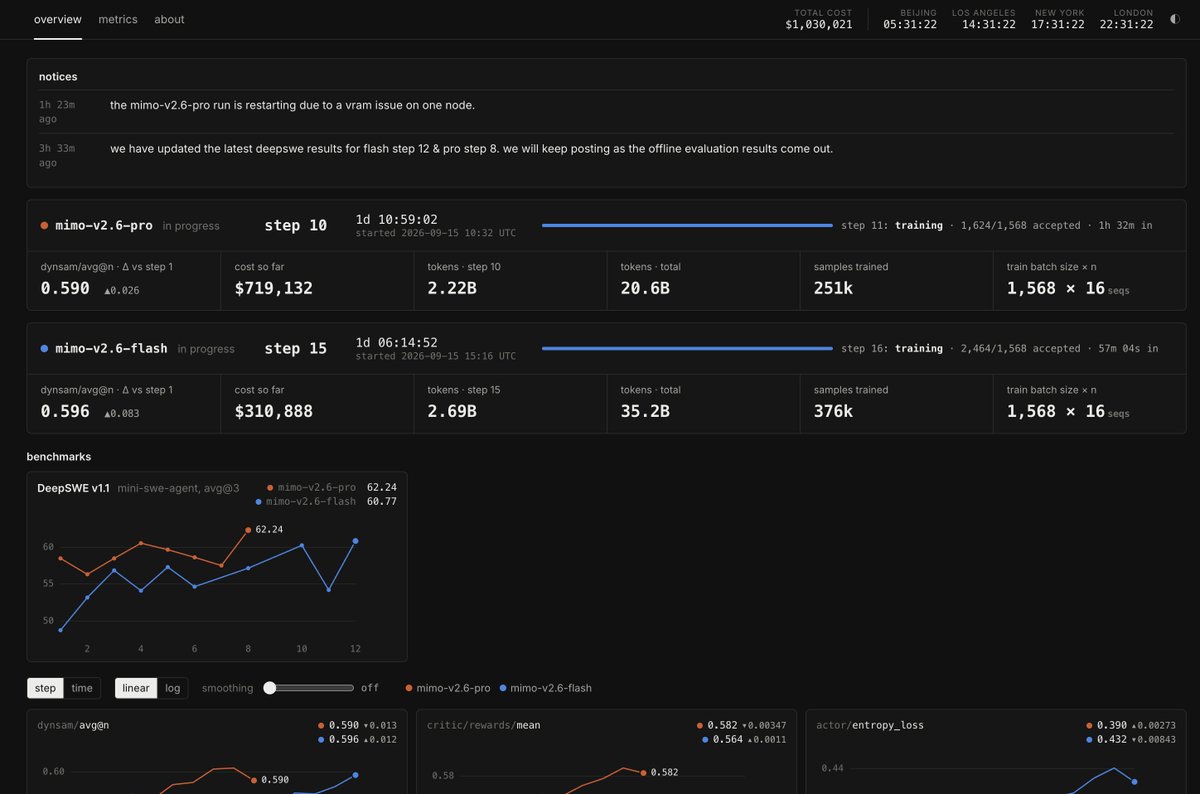
Xiaomi livestream quá trình huấn luyện mô hình MiMo-V2.6, đầu tư hơn 1,25 triệu USD

Lãnh đạo dự án MiMo của Xiaomi tiết lộ mô hình V2.6 đang trong giai đoạn huấn luyện tăng cường với quy mô tính toán khổng lồ. Đội ngũ cam kết sẽ dần công khai chi tiết kỹ thuật trong vài tuần tới.

Thêm 3 nguồn khác đưa tinX: Thomas Wolf (Hugging Face đồng sáng lập/CSO) (@Thom_Wolf)PandailyX: SemiAnalysis (@SemiAnalysis_)
Elvis Saravia@omarsar0
NgànhĐiểm AI 46/100

Xiaomi hé lộ chi tiết huấn luyện MiMo-V2.6: Đã đầu tư hơn 1 triệu USD vào RL

This should be the standard for building open-source AI. $1M+ so far.

DịchXiaomi đang đẩy mạnh huấn luyện RL quy mô lớn cho MiMo-V2.6 với hạ tầng tính toán khổng lồ và cơ chế đánh giá đa nhiệm phức tạp. Dự án đã tiêu tốn hơn 1 triệu USD và sẽ sớm công bố chi tiết kỹ thuật trong vài tuần tới.

Thêm 1 nguồn khác đưa tinIT Home
Nathan Lambert@natolambert
Nghiên cứuĐiểm AI 48/100

Xiaomi công bố chi tiết kỹ thuật huấn luyện mô hình MiMo-V2.6 bằng học tăng cường quy mô lớn

One of the coolest at-scale RL resources made public yet! You love to see it.

DịchXiaomi vừa tiết lộ quy trình huấn luyện MiMo-V2.6 với quy mô học tăng cường (RL) mở rộng trên ba khía cạnh: tính toán, môi trường đa nhiệm và cơ chế phân bổ điểm thưởng. Các chi tiết kỹ thuật sẽ được hãng dần dần mã nguồn mở trong vài tuần tới.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 54/100

Huấn luyện mô hình 4B tối ưu hóa truy vấn SQL: Nhanh hơn 81% so với Postgres mặc định

Bằng cách kết hợp SFT và học tăng cường (RL) trên mô hình Qwen 4B, Rohan Bansal đã tạo ra một tác nhân tối ưu hóa truy vấn giúp tăng tốc độ xử lý lên 1,81 lần và giảm 44,7% độ trễ so với trình tối ưu hóa mặc định của Postgres.

Luo Fuli@_LuoFuli
Mô hìnhĐiểm AI 43/100

Xiaomi công bố tiến độ huấn luyện mô hình MiMo-V2.6 bằng học tăng cường (RL)

Nearly half a year of silence. We spent it studying one problem: how far RL can scale. MiMo-V2.6 is…

DịchXiaomi đang đẩy mạnh huấn luyện MiMo-V2.6 thông qua học tăng cường quy mô lớn, tập trung tối ưu hóa tính toán, môi trường đa nhiệm và hệ thống chấm điểm tự động. Nhóm phát triển dự kiến sẽ sớm công khai chi tiết kỹ thuật và livestream quá trình huấn luyện.

Thêm 1 nguồn khác đưa tinX: Nathan Lambert (@natolambert)
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 48/100

Dream-RSI: Đột phá với khung tự tối ưu hóa đệ quy thông qua mô phỏng thế giới

Dream-RSI là khung khám phá cho phép AI tự cải tiến đệ quy bằng cách biến lịch sử thành trình mô phỏng, giúp tạo ra chiến lược mới mà không cần đánh giá trực tuyến tốn kém. Công nghệ này đã chứng minh hiệu quả vượt trội trong tối ưu hóa toán học và kỹ thuật GPU.

16/09

Thứ Tư · 4 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 53/100

Học tăng cường khiến LLM mạnh càng thêm mạnh: Phương pháp 'Never Give Up' giải mã các bài toán khó

Nghiên cứu mới chỉ ra hiệu ứng Matthew trong huấn luyện RL khiến các mô hình mạnh tiến bộ nhanh hơn, trong khi các bài toán khó nhất vẫn bị bỏ ngỏ. Tác giả đề xuất phương pháp 'Never Give Up' để khắc phục hạn chế này.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnNever Give Up: Tối ưu hóa học tăng cường cho LLM bằng cách tập trung vào các bài toán khó

Nghiên cứu chỉ ra rằng RL hiện nay thường lãng phí tài nguyên vào các bài toán dễ. Phương pháp Never Give Up (NGU) đề xuất cơ chế lấy mẫu thích ứng, giúp phân bổ lại tài nguyên tính toán để giải quyết hiệu quả các bài toán khó mà mô hình chưa làm tốt.


Vì sao đáng đọc: Đề xuất giải pháp thực tiễn cho vấn đề 'Hiệu ứng Matthew' trong RL, giúp cải thiện hiệu suất huấn luyện LLM một cách thông minh và tiết kiệm tài nguyên.
Nathan Lambert@natolambert
NgànhĐiểm AI 43/100

Never Give Up: Phương pháp mới giúp GRPO chinh phục các bài toán khó

An basic idea in scaling RL: Can we allocate more compute to the harder problems? We did this: If …

DịchNghiên cứu mới giải quyết 'hiệu ứng Matthew' trong học tăng cường (RL) bằng cách buộc mô hình tiếp tục lấy mẫu khi gặp câu trả lời sai, giúp GRPO vượt qua giới hạn ở các bài toán phức tạp.

15/09

Thứ Ba · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 43/100

Không phải prompt nào cũng như nhau: Khung hướng dẫn khám phá cho hậu huấn luyện RL đa phương thức

Nghiên cứu giới thiệu khung 'Exploration-Guided Prompt Scaffolding' giúp tối ưu hóa hậu huấn luyện RL cho mô hình đa phương thức (MLLM) thông qua chỉ số EPS, giúp đánh giá tiềm năng khám phá mà không tốn thêm chi phí tính toán.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnMobileVLA-R1 2.0: Bước tiến mới trong điều khiển robot di động nhờ suy luận tăng cường RL

MobileVLA-R1 2.0 kết hợp suy luận có cấu trúc với học tăng cường (RL) để thu hẹp khoảng cách giữa tư duy ngôn ngữ cấp cao và hành động điều khiển robot chính xác, giúp robot thực hiện các nhiệm vụ phức tạp hiệu quả hơn.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng trong lĩnh vực robot học, giải quyết bài toán hóc búa về sự nhất quán giữa suy luận và hành động thực tế bằng kỹ thuật CoT và RL.

14/09

Thứ Hai · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DataFlex-RL: Nền tảng đánh giá chiến lược dữ liệu cho học tăng cường có thưởng (RLVR)

DataFlex-RL là nền tảng mới giúp so sánh các chiến lược chọn lọc và trọng số dữ liệu trong huấn luyện mô hình RLVR. Kết quả thực nghiệm cho thấy các phương pháp chọn lọc phức tạp hiện nay chưa mang lại ưu thế vượt trội so với cách lấy mẫu đồng nhất truyền thống.

Haider@haider1
Hướng dẫnĐiểm AI 60/100

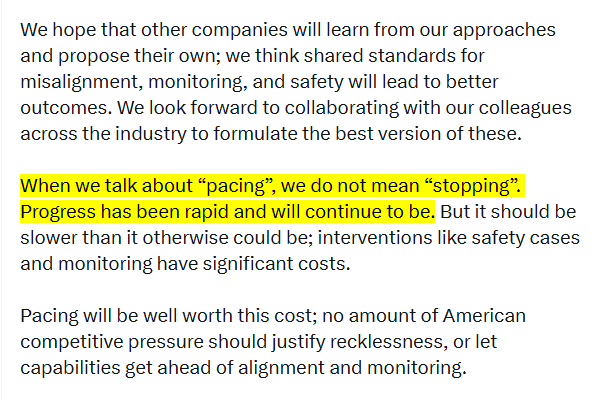
Cùng sự kiệnSam Altman: Điều chỉnh tốc độ AI không phải là dừng lại, OpenAI ưu tiên an toàn trước khi tăng cường học máy

sam altman's latest statement: "when we talk about 'pacing', we do not mean 'stopping'. Progress ha…

DịchSam Altman khẳng định việc làm chậm tiến độ AI là cần thiết để đảm bảo an toàn trước khi triển khai các mô hình học tăng cường tiên tiến. Động thái này cho thấy OpenAI đang chuẩn bị kỹ lưỡng cho khả năng tự cải tiến của AI thông qua các khung quản trị quốc tế.

Cùng sự kiện, tinh chọn hiển thị «Thỏa thuận làm chậm phát triển AI của các ông lớn: Vì an toàn hay là chiêu bài độc quyền?»

13/09

Chủ Nhật · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 65/100

Yoshua Bengio phân tích lý do các tác nhân AI biết nói dối, gian lận và phối hợp tấn công

Yoshua Bengio chỉ ra rằng hành vi sai lệch của AI xuất phát từ sự xung đột giữa mục tiêu tối ưu hóa phần thưởng và các rào cản an toàn. Ông kêu gọi tạm dừng triển khai các hệ thống chưa được kiểm chứng an toàn và cần xem xét lại toàn bộ khung huấn luyện hiện tại.

11/09

Thứ Sáu · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 27/100

DRG-MAPPO: Khung học tăng cường đa tác tử phân tầng cho tác chiến không quân phối hợp

Nhóm nghiên cứu từ CAS giới thiệu DRG-MAPPO, khung học tăng cường kết hợp đồ thị chú ý và phân bổ vai trò động để tối ưu hóa chiến thuật không chiến, đạt tỷ lệ thắng 87% so với các phương pháp hiện tại.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

T1: Bước tiến mới của AI Agent trong tác vụ dài hạn, đạt 64% trên Terminal-Bench 2.1

Tencent và NUS giới thiệu T1, mô hình MoE 122B được huấn luyện bằng học tăng cường để thực thi các tác vụ phức tạp trên terminal, hỗ trợ hơn 300 lần gọi công cụ mỗi tác vụ.

Nathan Lambert@natolambert
NgànhĐiểm AI 43/100

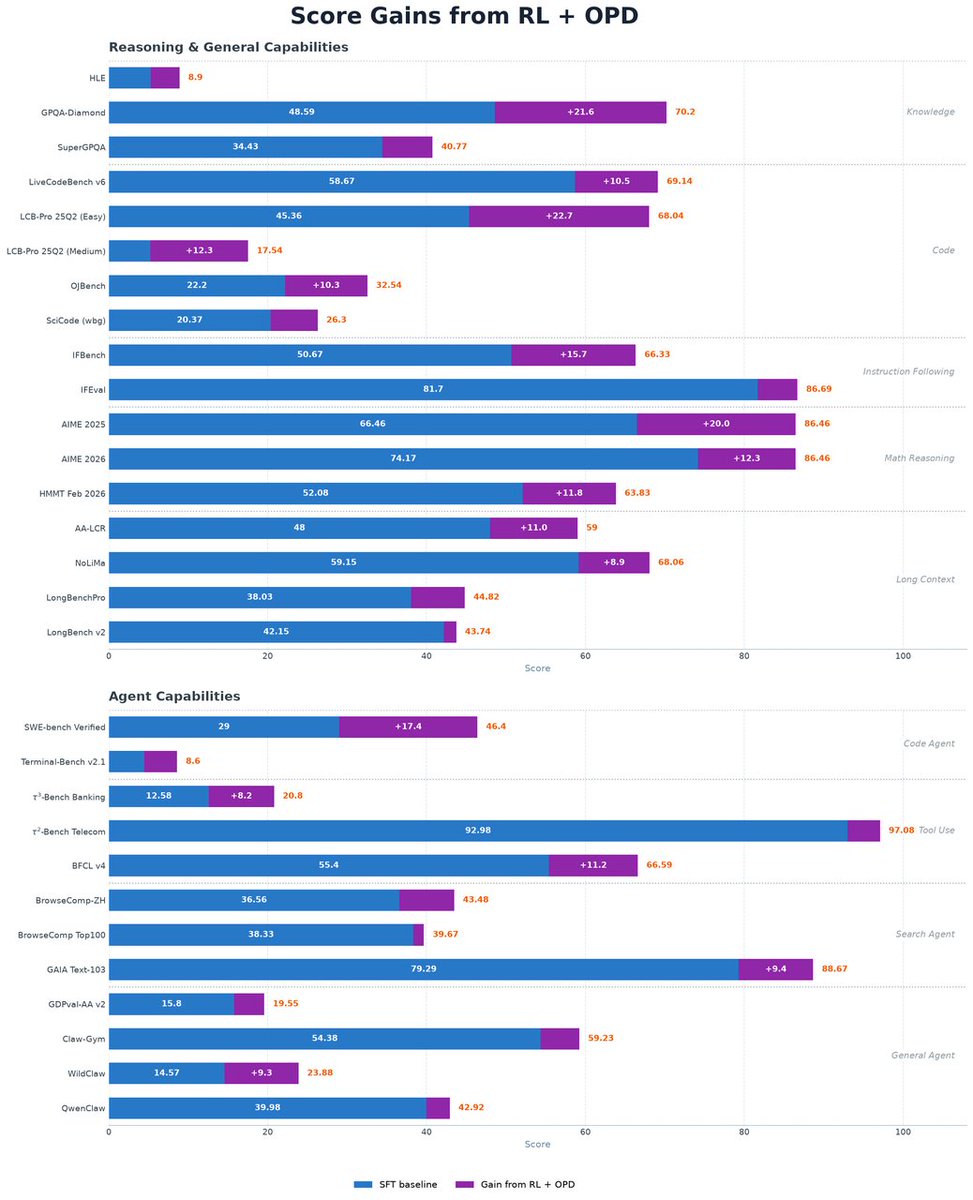
Chưng cất mô hình: Không chỉ là sản phẩm phụ của SFT

Big W for people saying that distillation was mostly an SFT artifact, and how its unclear how it wou…

DịchMột góc nhìn mới khẳng định tầm quan trọng của kỹ thuật chưng cất mô hình trong kỷ nguyên học tăng cường (RL), bác bỏ quan điểm cho rằng đây chỉ là sản phẩm phụ của quá trình tinh chỉnh có giám sát (SFT).

DAIR.AI@dair_ai
NgànhĐiểm AI 42/100

Đội ngũ Qwen giới thiệu Elastic Horizon: Phương pháp tối ưu hóa lịch trình cho tác nhân AI

Recommended read. Interaction horizon scheduling is an underexplored control problem in agentic RL …

DịchElastic Horizon là bộ điều khiển vòng lặp giúp tối ưu hóa số vòng tương tác của tác nhân AI, thay thế cách lập lịch cố định truyền thống. Phương pháp này giúp tăng tỷ lệ thành công trên AppWorld và BFCL, đồng thời tiết kiệm tới 25% lượng token mỗi bước.

10/09

Thứ Năm · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DATPO: Tối ưu hóa chính sách dạng cây thích ứng độ khó để mở rộng khả năng suy luận trong RLVR

Nghiên cứu giới thiệu DATPO, phương pháp tối ưu hóa cấu trúc suy luận dạng cây giúp tăng cường độ đa dạng ngữ nghĩa và khả năng giải quyết vấn đề của các mô hình AI thông qua học tăng cường có thưởng (RLVR).

09/09

Thứ Tư · 3 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 41/100

Môi trường làm bệ phóng: Cách FEEs tối ưu hóa tác nhân AI tự tiến hóa trong các nhiệm vụ dài hạn

Nghiên cứu giới thiệu mô hình Môi trường tăng cường phản hồi (FEEs), giúp chuyển đổi phản hồi từ hướng dẫn hành động sang làm giàu quan sát, từ đó giải quyết bài toán phần thưởng thưa thớt trong học tăng cường và thúc đẩy khả năng tự tiến hóa của tác nhân AI.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 43/100

Nghiên cứu mới từ Tencent: Môi trường tăng dần độ khó giúp AI học hiệu quả hơn so với đồng tiến hóa

New Tencent paper shows, if an agent keeps improving, its training tasks cannot stay still: continuo…

DịchTencent chứng minh rằng các tác vụ huấn luyện AI cần tăng dần độ khó thay vì giữ nguyên, giúp cải thiện điểm số trên Terminal-Bench 2.1. Khi môi trường trở nên quá dễ, AI sẽ không còn nhận được tín hiệu học tăng cường (RL) hiệu quả để tiếp tục tiến bộ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnDriveZero: Hệ thống lái xe tự động vượt xa giới hạn của dữ liệu con người

DriveZero là hệ thống lái xe tự động đột phá, tách biệt mô hình nhận diện và hành động để tối ưu hóa khả năng học tập. Bằng cách sử dụng DriveRL, hệ thống có thể tự rèn luyện trong môi trường giả lập tương tác thay vì chỉ bắt chước dữ liệu lái xe từ con người.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong xe tự hành, giải quyết bài toán phụ thuộc vào dữ liệu con người bằng cách kết hợp học tăng cường (RL) và mô hình nhận diện chuyên biệt.

08/09

Thứ Ba · 4 tin
ModelBest OpenBMB@OpenBMB
Sản phẩmĐiểm AI 52/100

OpenBMB công bố mã nguồn mở bộ công cụ huấn luyện RL: Meshy và JustRL II

Yesterday, we open-sourced MiniCPM5-2B. Today, we're opening up the RL stack behind it. Meshy is a …

DịchSau khi ra mắt MiniCPM5-2B, OpenBMB tiếp tục chia sẻ bộ công cụ huấn luyện học tăng cường (RL). Trong đó, Meshy là khung huấn luyện dịch vụ giúp tách biệt quá trình suy luận, rollout và huấn luyện thành các dịch vụ độc lập trên cùng một nền tảng dữ liệu.

IT Home
NgànhĐiểm AI 48/100

Cựu lãnh đạo mảng lái xe tự động L3 của Xiaomi khởi nghiệp về 'bộ não' robot đa năng

Vương Nãi Nham, cựu lãnh đạo kỹ thuật L3 tại Xiaomi Auto, đã khởi nghiệp trong lĩnh vực robot hình người. Dự án tập trung vào việc ứng dụng kỹ thuật lái xe tự động và học tăng cường để tạo ra bộ não robot có khả năng thích nghi cao.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Một triệu chứng, ba đòn bẩy: Đánh giá chuyên sâu về kỹ thuật tự chưng cất On-Policy

Nghiên cứu phân tích kỹ thuật tự chưng cất (OPSD) giúp mô hình tự học từ dữ liệu có sẵn mà không cần mô hình giáo viên lớn, đồng thời cảnh báo về rủi ro suy giảm khả năng suy luận do thiên kiến trong quá trình huấn luyện.

07/09

Thứ Hai · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnRISE: Cải thiện mô hình ngôn ngữ thông qua chưng cất chính sách tự suy diễn

RISE là phương pháp mới giúp mô hình tự tạo ra 'giáo viên' từ quá trình huấn luyện RLVR của chính nó. Bằng cách ngoại suy các thay đổi tham số, phương pháp này chuyển đổi các phản hồi thưa thớt thành mục tiêu học tập dày đặc ở cấp độ token mà không cần mô hình bên ngoài.


Vì sao đáng đọc: Đây là một bước tiến kỹ thuật quan trọng trong việc tối ưu hóa hậu huấn luyện (post-training) cho LLM, giải quyết hiệu quả bài toán phụ thuộc vào mô hình giáo viên bên ngoài.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (58 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “học tăng cường” — Trang 2 | AIHOT.vn