DịchMeta Muse Spark đã nâng cấp từ bản 1.1 lên 1.3 với khả năng tái tạo hình học, cấu trúc và độ chân thực của mô hình 3D từ ảnh đơn lẻ vượt trội, trong khi chi phí vẫn giữ nguyên ở mức 0,6 USD.
DịchMeta vừa phát hành Muse Spark 1.3 với khả năng tạo mô hình 3D chi tiết hơn so với bản 1.2. Dù tiêu tốn nhiều token và chi phí hơn một chút, nhưng chất lượng đầu ra được đánh giá là có cải thiện rõ rệt.
VAST vừa ra mắt Tripo P2.0, bước tiến lớn trong AI 3D khi cho phép tạo mô hình với cấu trúc lưới tứ giác (quad topology) chuẩn xác, sẵn sàng cho việc làm phim và game mà không cần xử lý lại.
Được đồng sáng lập bởi Fei-Fei Li, Atlas cho phép tái tạo không gian 3D chân thực từ ít ảnh đầu vào, hỗ trợ xuất dữ liệu 3D chuyên sâu và video 1440p có thể điều khiển.
World Labs vừa giới thiệu Atlas, mô hình thế giới đa phương thức đầu tiên được huấn luyện từ đầu, có khả năng tái tạo không gian 3D, điều khiển camera chính xác và mô phỏng thời gian thực, mở ra ứng dụng tiềm năng từ kỹ xảo điện ảnh đến robot học.
World Labs giới thiệu Atlas, mô hình thế giới sử dụng kiến trúc Transformer khuếch tán tự hồi quy, có khả năng xử lý đồng thời văn bản, hình ảnh, video và 3D. Mô hình vượt trội trong việc tạo video có kiểm soát camera và tái tạo 3D, mở ra tiềm năng lớn cho mô phỏng không gian.
Omni models are the next frontier. Simply put it, this is the most exciting release I've seen this …
DịchWorld Labs giới thiệu Atlas, mô hình thế giới đa phương thức đầu tiên có khả năng tạo hình ảnh, video với độ chính xác cấp pixel và tái tạo không gian 3D, mở ra kỷ nguyên mới cho các mô hình AI toàn diện.
BLARM là phương pháp tiên phong cho phép tạo hoạt ảnh 3D từ video đơn lẻ và lưới vật thể tĩnh mà không cần khung xương hay gắn nhãn phức tạp. Công nghệ này sử dụng các thành phần chuyển động cứng tiềm ẩn để tạo ra chuyển động mượt mà, ổn định và chính xác về mặt hình học.
Everyone can generate a SPIDER-MAN with Hy4 preview
DịchTencent vừa ra mắt bản xem trước của mô hình Hunyuan Hy4, cho phép người dùng tạo ra trải nghiệm game 3D tương tác chỉ với chi phí 13 USD. Dự án này đã được mã nguồn mở để cộng đồng cùng khám phá.
1/ Spent the past few days testing Lux3D, a 3D generative model. You give it an image or a text prom…
DịchLux3D là mô hình AI mạnh mẽ cho phép tạo ra các tài sản 3D hoàn chỉnh và có thể chỉnh sửa trực tiếp từ ảnh hoặc văn bản mà không cần kỹ năng thiết kế chuyên sâu.
Procedura là khung tác nhân AI mới giúp chuyển đổi văn bản thành các mô hình 3D dưới dạng mã nguồn có cấu trúc, cho phép chỉnh sửa tham số và đảm bảo tính chính xác về kỹ thuật thay vì chỉ tạo lưới bề mặt đơn thuần.
Vì sao đáng đọc: Giải quyết được điểm yếu lớn nhất của AI tạo 3D hiện nay là tính chỉnh sửa và độ chính xác hình học, mở ra hướng đi thực tiễn cho thiết kế công nghiệp.
Block3D tối ưu hóa việc tạo mô hình 3D bằng cách chia nhỏ chuỗi token thành các khối, kết hợp giữa giải mã tự hồi quy và khử nhiễu đồng thời để tăng tốc độ và độ chính xác, đồng thời giảm thiểu lỗi tích lũy.
Nghiên cứu giới thiệu aDSL, ngôn ngữ chuyên dụng giúp AI chuyển đổi ý tưởng thành mã lập trình 3D chính xác thông qua cơ chế phản hồi lặp lại, vượt trội hơn các mô hình LLM hiện tại trong việc tạo hình khối và cấu trúc phức tạp.
AnyTalk giới thiệu phương pháp mới giúp tạo hoạt ảnh 3D từ video mà không cần dữ liệu mẫu, thông qua kỹ thuật tinh chỉnh chuyên biệt (CsF) để tối ưu hóa tham số khuôn mặt. Công nghệ này hỗ trợ đa dạng cấu hình nhân vật và có phiên bản thời gian thực hiệu quả.
MegaParts là khung tạo mô hình 3D tự hồi quy mới, sử dụng bộ mã hóa hình học nén để xử lý các vật thể phức tạp lên tới 300 bộ phận mà vẫn đảm bảo hiệu suất và độ chi tiết cao.
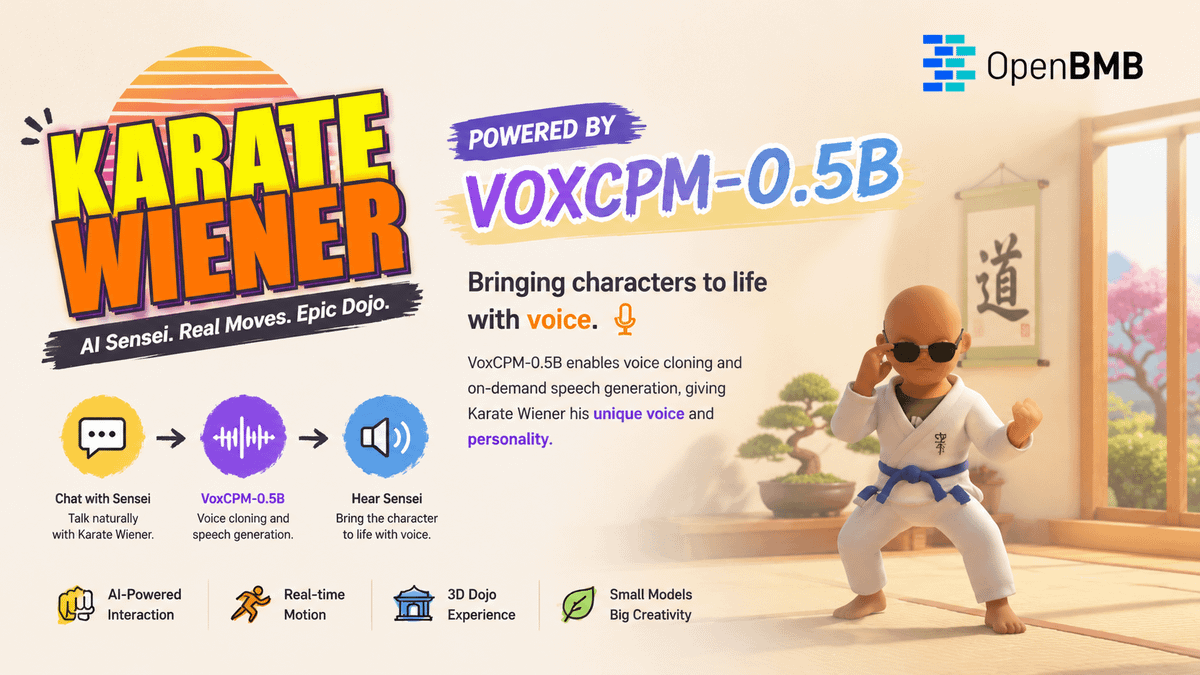
🥋 Karate Wiener is an interactive 3D character experience, featuring a hotdog sensei who teaches ka…
DịchOpenBMB giới thiệu Karate Wiener, nhân vật 3D tương tác hỗ trợ trò chuyện giọng nói và tạo hành động, được vận hành bởi mô hình siêu nhẹ VoxCPM-0.5B. Dự án này chứng minh tiềm năng ứng dụng của các mô hình AI nhỏ gọn trong lĩnh vực giải trí sáng tạo.
Nghiên cứu chỉ ra rằng hiện tượng nhiễu và giả ảnh trong Latent SDS xuất phát từ sự lệch pha của VAE. PixSDS khắc phục vấn đề này bằng cách tinh chỉnh gradient nhất quán mà không cần huấn luyện lại mô hình, giúp tạo 3D sắc nét và sạch hơn.
 Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang