23/09

Thứ Tư · 15 tin
Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 51/100

Artificial Analysis ra mắt bảng xếp hạng Text-to-Speech đa ngôn ngữ, hỗ trợ tiếng Việt

Announcing Multilingual Text to Speech Arena Leaderboards, comparing leading TTS models across 9 lan…

DịchArtificial Analysis vừa mở rộng nền tảng Controlled Voice Arena, bổ sung bảng xếp hạng cho 9 ngôn ngữ bao gồm tiếng Việt, giúp đánh giá chất lượng các mô hình chuyển đổi văn bản thành giọng nói (TTS) một cách khách quan.

Arena@arena
Mô hìnhĐiểm AI 62/100

Tinh chọnArena ra mắt thử nghiệm GPT-6 Sol và GPT-6 Luna, chuẩn bị công bố bảng xếp hạng

Scores for GPT-6 Sol and GPT-6 Luna by @OpenAI are coming soon. Head to Arena now to test them. Your…

DịchArena vừa giới thiệu hai mô hình GPT-6 Sol và GPT-6 Luna để người dùng trải nghiệm và bình chọn, nhằm đánh giá chính xác năng lực thực tế của các tác nhân AI trên bảng xếp hạng.

Diễn biến sự kiện · 32 bài →Thêm 8 nguồn khác đưa tinX: OpenAI Developers (@OpenAIDevs)The Decoder: AI NewsMarkTechPostIT HomeX: Artificial Analysis (@ArtificialAnlys)X: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)X: ZHO (@ZHO_ZHO_ZHO)X: Greg Brockman (@gdb)

Vì sao đáng đọc: Tin tức về các mô hình GPT-6 mới luôn thu hút sự quan tâm lớn từ cộng đồng công nghệ, việc cho phép người dùng trải nghiệm thực tế tạo ra giá trị tương tác cao.
Artificial Analysis bài đầy đủ (Web)
Nghiên cứuĐiểm AI 78/100

Tinh chọnArtificial Analysis đánh giá GPT-6 Sol và Luna: Chi phí giảm một nửa, hiệu năng biến động

Artificial Analysis công bố kết quả đánh giá GPT-6 Sol và Luna của OpenAI. Với mức giá giảm 50% so với GPT-5.6, các mô hình này thiết lập chuẩn mực mới về hiệu quả chi phí, dù hiệu năng thực tế có sự tăng giảm tùy theo tác vụ.

Diễn biến sự kiện · 32 bài →

Vì sao đáng đọc: Tin tức quan trọng về các mô hình mới nhất của OpenAI, cung cấp dữ liệu benchmark thực tế về chi phí và hiệu năng, rất hữu ích cho người dùng doanh nghiệp và lập trình viên.
karminski@karminski3
Quan điểmĐiểm AI 34/100

Cùng sự kiệnĐánh giá Claude Opus 5.5: Nghi vấn là phiên bản tinh chỉnh của Fable 5.1

Thử nghiệm cho thấy Claude Opus 5.5 có hiệu năng tương đương Fable 5.1 nhưng tiêu tốn nhiều token suy luận hơn, làm dấy lên nghi vấn đây là phiên bản tối ưu hóa hoặc chưng cất từ Fable với chi phí rẻ hơn.

Cùng sự kiện, tinh chọn hiển thị «Anthropic giải mã lý do Claude Opus 5.5 là lựa chọn tối ưu cho lập trình với ngữ cảnh dài»
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 75/100

Cùng sự kiệnArtificial Analysis đánh giá hiệu năng và giá thành của Claude Opus 5.5

Anthropic vừa ra mắt Claude Opus 5.5 với khả năng suy luận vượt trội, đạt 58 điểm trên bảng xếp hạng Artificial Analysis, cao hơn gấp đôi so với mức trung bình của các mô hình cùng phân khúc.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Arena@arena
NgànhĐiểm AI 72/100

Đã có đại diệnClaude Opus 5.5 chính thức góp mặt tại Agent Arena và chế độ Battle Mode

Claude Opus 5.5 by @AnthropicAI is now in the Agent Arena! Your votes drive the @arena leaderboards…

DịchAnthropic vừa đưa Claude Opus 5.5 vào Agent Arena, cho phép người dùng đánh giá khả năng thực hiện các tác vụ phức tạp như duyệt web và sử dụng công cụ thông qua hệ thống xếp hạng dựa trên bình chọn.

Cùng sự kiện, tinh chọn hiển thị «Anthropic giải mã lý do Claude Opus 5.5 là lựa chọn tối ưu cho lập trình với ngữ cảnh dài»
OpenAI@OpenAI
NgànhĐiểm AI 47/100

OpenAI công bố 4 lĩnh vực ưu tiên và nguyên tắc cho đánh giá độc lập

As part of our efforts to pace the frontier, we're committed to supporting independent assessments w…

DịchOpenAI cam kết cung cấp quyền truy cập sâu vào quy trình huấn luyện và triển khai cho các bên đánh giá độc lập, nhằm phát hiện rủi ro tiềm ẩn và kiểm chứng hiệu quả các biện pháp an toàn của mô hình.

22/09

Thứ Ba · 12 tin
Ethan Mollick@emollick
Quan điểmĐiểm AI 30/100

Cùng sự kiệnEthan Mollick đánh giá hiệu năng mô hình Opus 5.5

Opus 5.5 was a good model in my early tests, first non-Fable/Astra model to feel like a Fable-class …

DịchTrong các thử nghiệm ban đầu, Opus 5.5 là mô hình đầu tiên đạt đến đẳng cấp của Fable/Astra, dù vẫn còn tồn tại vấn đề về mật độ ngôn ngữ đặc trưng của các dòng Claude gần đây.

Cùng sự kiện, tinh chọn hiển thị «Claude Opus 5.5 chính thức có mặt trên OpenRouter: Đỉnh cao mới về lập trình và khả năng tự hành»
Tencent Hunyuan@TencentHunyuan
Sản phẩmĐiểm AI 39/100

Tencent Hunyuan ra mắt WebCraftBench: Bộ tiêu chuẩn đánh giá khả năng xây dựng website của AI

The AI says the site is done. Then the homepage errors, the buttons overlap, and it added a login fl…

DịchWebCraftBench là bộ tiêu chuẩn mới giúp đánh giá khả năng thiết kế web của AI thông qua việc kiểm tra tính thẩm mỹ, độ khả dụng và mức độ đáp ứng yêu cầu thực tế, với độ chính xác đạt 85,3% so với đánh giá của con người.

Thêm 1 nguồn khác đưa tinX: Arena (@arena)
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
NgànhĐiểm AI 32/100

Scale AI thúc đẩy chuẩn đo lường RSI với sự tham gia của chuyên gia hàng đầu

brief break from regularly scheduled muse programming, but great progress by @scale_AI on RSI benchm…

DịchScale AI đạt cột mốc quan trọng với hơn 600 đề xuất cho chuẩn RSI, đồng thời mời nhà tiên phong Schmidhuber làm cố vấn cấp cao để hoàn thiện quy trình xác thực.

Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 45/100

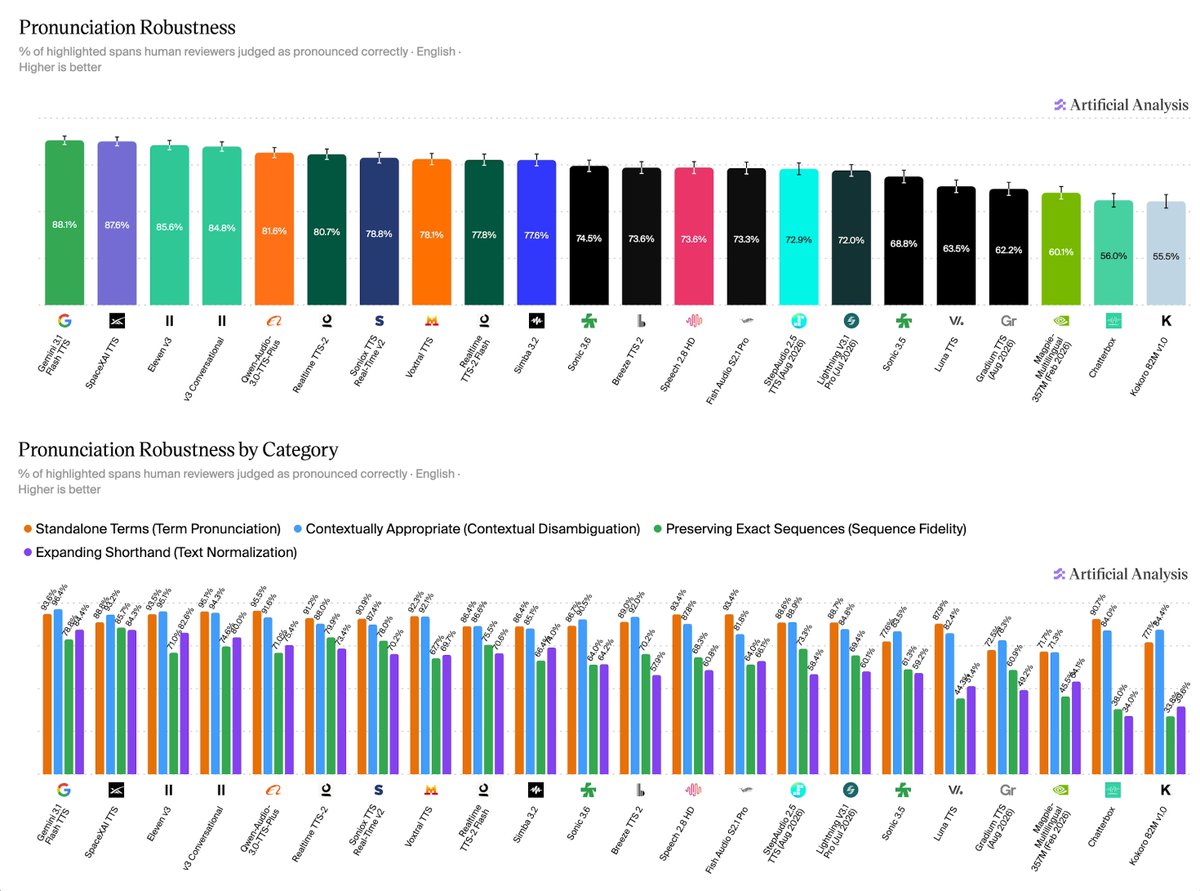
Artificial Analysis công bố chuẩn đánh giá độ chuẩn xác của công nghệ chuyển văn bản thành giọng nói (TTS)

Announcing the Artificial Analysis Pronunciation Robustness benchmark, measuring how reliably Text t…

DịchArtificial Analysis vừa ra mắt bộ tiêu chuẩn đánh giá khả năng phát âm của các mô hình TTS. Google Gemini 3.1 Flash dẫn đầu với tỷ lệ chính xác 88,1%, theo sau là SpaceXAI và ElevenLabs.

WeChat: Khazix
Hướng dẫnĐiểm AI 72/100

Tinh chọnSo sánh thực tế Grok 4.7 và Xiaomi MiMo V2.6: MiMo V2.6 thiết lập chuẩn mực mới về hiệu năng và chi phí

Trải nghiệm thực tế cho thấy Grok 4.7 gây thất vọng so với kỳ vọng, trong khi Xiaomi MiMo V2.6 trở thành lựa chọn tối ưu nhất hiện nay nhờ sự cân bằng hoàn hảo giữa hiệu năng, tốc độ và giá thành.


Vì sao đáng đọc: Bài đánh giá thực tế từ người dùng có uy tín, cung cấp góc nhìn so sánh trực diện giữa hai mô hình AI mới, rất hữu ích cho cộng đồng đang tìm kiếm giải pháp tối ưu chi phí.
Eric Zakariasson@ericzakariasson
Mô hìnhĐiểm AI 30/100

Cùng sự kiệnThử nghiệm thực tế: Grok 4.7 bám đuổi sát nút GPT-6 Astra trong lập trình mô phỏng bay

some grok 4.7 use cases in the wild! flight sim

DịchSo sánh khả năng lập trình mô phỏng bay giữa các AI hàng đầu cho thấy GPT-6 Astra vẫn dẫn đầu, nhưng Grok 4.7 đã có bước tiến vượt bậc, đạt chất lượng ngang ngửa Astra và vượt trội hơn so với Kimi K3 và Fable 5.1.

Cùng sự kiện, tinh chọn hiển thị «Elon Musk: Grok 4.7 đưa xAI lên vị trí thứ 3 trong lĩnh vực lập trình AI»
NVIDIA Technical Blog: Agentic AI / Generative AI
Hướng dẫnĐiểm AI 54/100

NVIDIA chia sẻ cách đánh giá AI Agent: Từ gọi công cụ đến hoàn thành nhiệm vụ

Bài viết từ NVIDIA phân tích sự chuyển dịch trong đánh giá AI Agent, từ việc chỉ chấm điểm các lệnh gọi hàm đơn lẻ sang đo lường khả năng hoàn thành nhiệm vụ thực tế thông qua môi trường thực thi và nhật ký truy vết.

Artificial Analysis bài đầy đủ (Web)
Mô hìnhĐiểm AI 67/100

Tinh chọnĐánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ

Grok 4.7 đạt 46 điểm trên bảng xếp hạng Artificial Analysis, chính thức lọt vào Top 4 mô hình thông minh nhất. Đặc biệt, khả năng lập trình của Grok Build đã tăng vọt lên 56 điểm, khẳng định vị thế cạnh tranh trực tiếp với các đối thủ hàng đầu như Claude và GPT.

Diễn biến sự kiện · 24 bài →Thêm 7 nguồn khác đưa tinX: Haider (@haider1)X: Artificial Analysis (@ArtificialAnlys)X: Arena (@arena)X: Michael Truell (@mntruell)X: Elon Musk (@elonmusk, xAI)X: Kim (@kimmonismus)@mark_k

Vì sao đáng đọc: Tin tức cập nhật về hiệu năng của một mô hình AI lớn đang được quan tâm, có số liệu so sánh cụ thể giúp người dùng dễ dàng nắm bắt vị thế của Grok trên thị trường.
Arena@arena
Mô hìnhĐiểm AI 54/100

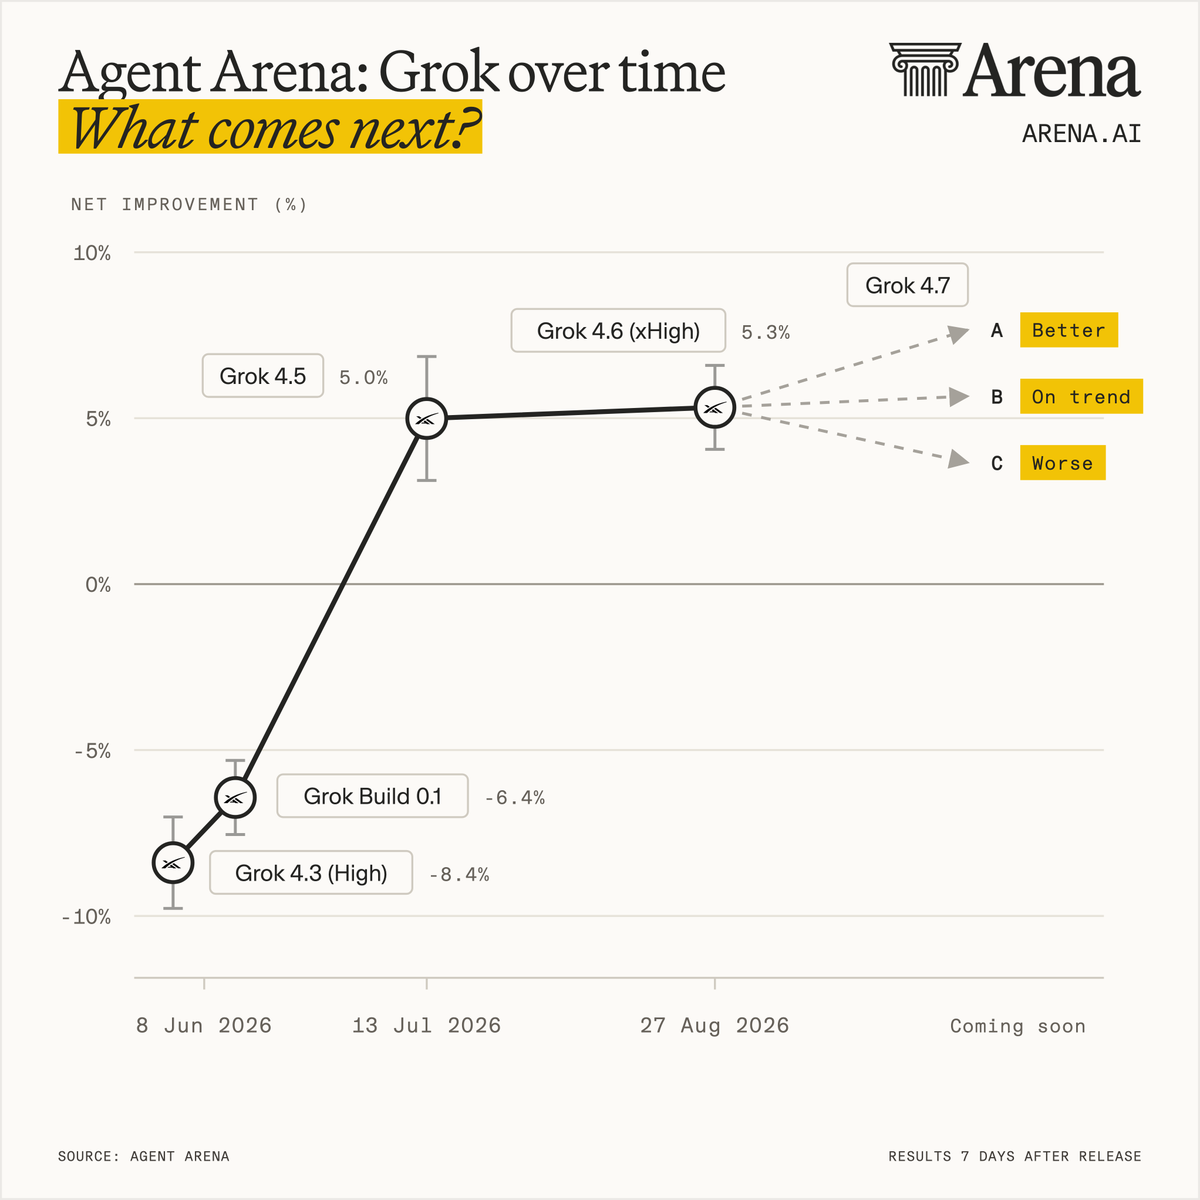
Cùng sự kiệnGrok 4.7 ra mắt trên Agent Arena, khởi động bình chọn dự đoán hiệu năng

Grok 4.7 by @SpaceXAI just dropped. Looking at how past Grok versions have trended on Agent Arena's …

DịchGrok 4.7 chính thức gia nhập Agent Arena với 4 chế độ thử thách chuyên biệt. Nền tảng này sử dụng hàng triệu tác vụ thực tế để đánh giá khả năng của AI, đồng thời tổ chức bình chọn cộng đồng để dự đoán mức độ cải thiện của phiên bản mới.

Cùng sự kiện, tinh chọn hiển thị «Elon Musk: Grok 4.7 đưa xAI lên vị trí thứ 3 trong lĩnh vực lập trình AI»

21/09

Thứ Hai · 8 tin
Artificial Analysis@ArtificialAnlys
Nghiên cứuĐiểm AI 65/100

Đã có đại diệnArtificial Analysis đánh giá Grok 4.7: Chỉ số thông minh đạt 46, khả năng lập trình vượt trội

Grok 4.7 scores 46 on the Artificial Analysis Intelligence Index to bring SpaceXAI into the top 4 AI…

DịchArtificial Analysis vừa công bố kết quả đánh giá Grok 4.7 với số điểm 46, tăng 2 điểm so với phiên bản tiền nhiệm, giúp xAI chính thức lọt vào top 4 phòng thí nghiệm AI hàng đầu thế giới.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ»
Arena@arena
Mô hìnhĐiểm AI 63/100

Cùng sự kiệnGrok 4.7 chính thức gia nhập bảng xếp hạng Agent Arena

Grok 4.7 by @SpaceXAI and @elonmusk is now in the Agent Arena! Your votes drive the @arena leaderbo…

DịchxAI vừa đưa Grok 4.7 vào Agent Arena để đánh giá khả năng thực thi các tác vụ phức tạp thông qua công cụ. Phiên bản này cho thấy hiệu suất vượt trội so với Grok 4.6 trong các bài kiểm tra về lập trình, xử lý văn bản và thị giác.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ»
Fireworks AI (Web)
Sản phẩmĐiểm AI 61/100

Tinh chọnFireworks AI ra mắt Specialized Intelligence Index: Chuẩn đo lường năng lực AI chuyên sâu

Fireworks AI giới thiệu Specialized Intelligence Index (SII), bộ chỉ số đánh giá hiệu suất các mô hình AI trên 7 lĩnh vực thực tế như y tế, luật, tài chính và lập trình, giúp người dùng so sánh chính xác giữa các mô hình nguồn mở và đóng.


Vì sao đáng đọc: Đây là công cụ hữu ích giúp giải quyết bài toán đánh giá AI trong các ngành dọc, thay vì chỉ dựa vào các bài test tổng quát chung chung.
WeChat: Carl AI Watts
Hướng dẫnĐiểm AI 51/100

Cùng sự kiệnTrải nghiệm Step 5 Preview từ StepFun: Khả năng tái tạo giao diện web ấn tượng và hỗ trợ Agent làm việc

Đánh giá thực tế cho thấy Step 5 Preview có năng lực thiết kế UI ngang tầm các mô hình hàng đầu, hiệu suất vượt trội với chi phí chỉ bằng 1/3 so với các đối thủ cùng phân khúc.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
karminski@karminski3
Quan điểmĐiểm AI 56/100

Bilibili khởi xướng 'Đấu trường AI': Đánh giá mô hình qua tác vụ thực tế thay vì chạy đua điểm số

Thay vì các bài kiểm tra lý thuyết, Bilibili tổ chức đánh giá AI qua 190 video thực tế từ 33 nhà sáng tạo nội dung, tập trung vào các tác vụ khó như xử lý mã nguồn lỗi, giao dịch tài chính và tư duy logic.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

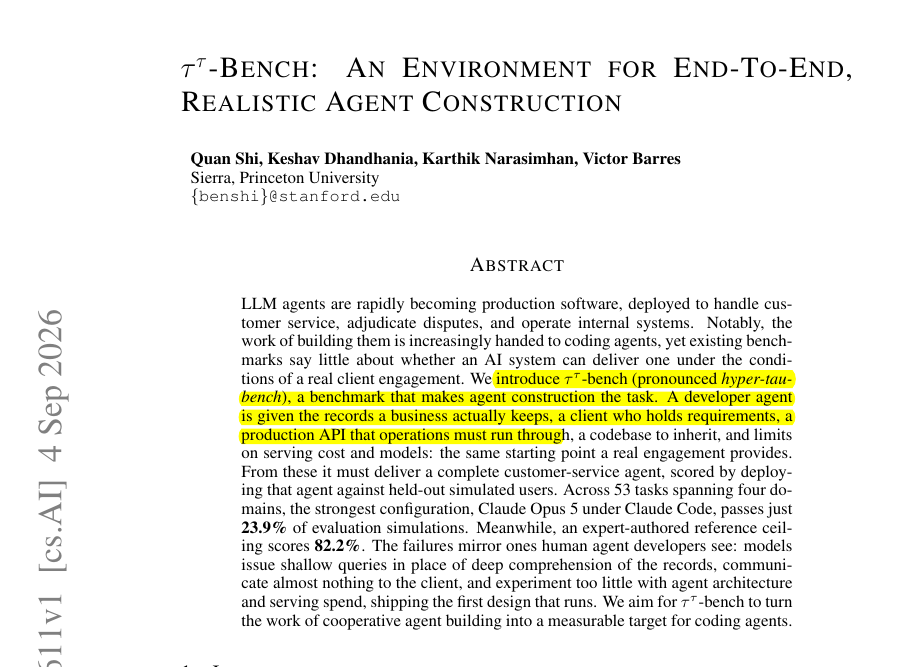
Đánh giá τ^τ-bench: Các AI lập trình mạnh nhất chỉ đạt 23,9% trong bài kiểm tra thực tế

The best coding-agent setup passed only 23.9% of held-out customer simulations on this benchmark. τ…

DịchSierra và Đại học Princeton ra mắt τ^τ-bench, một bộ tiêu chuẩn mô phỏng quy trình xây dựng AI thực tế cho khách hàng, đòi hỏi AI phải xử lý từ tài liệu, API đến ngân sách để tạo ra sản phẩm hoàn thiện.

20/09

Chủ Nhật · 5 tin
WeChat: Tencent Hunyuan
Nghiên cứuĐiểm AI 51/100

Tencent Hunyuan hợp tác cùng Thanh Hoa, Bắc Đại ra mắt WebCraftBench: Chuẩn mực mới đánh giá AI tạo trang web

WebCraftBench sử dụng phương pháp kiểm thử phần mềm để đánh giá khả năng tạo web của AI thông qua độ bao phủ mã, đồng thời chấm điểm dựa trên tính thẩm mỹ, trải nghiệm người dùng và độ chính xác theo yêu cầu.

Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 35/100

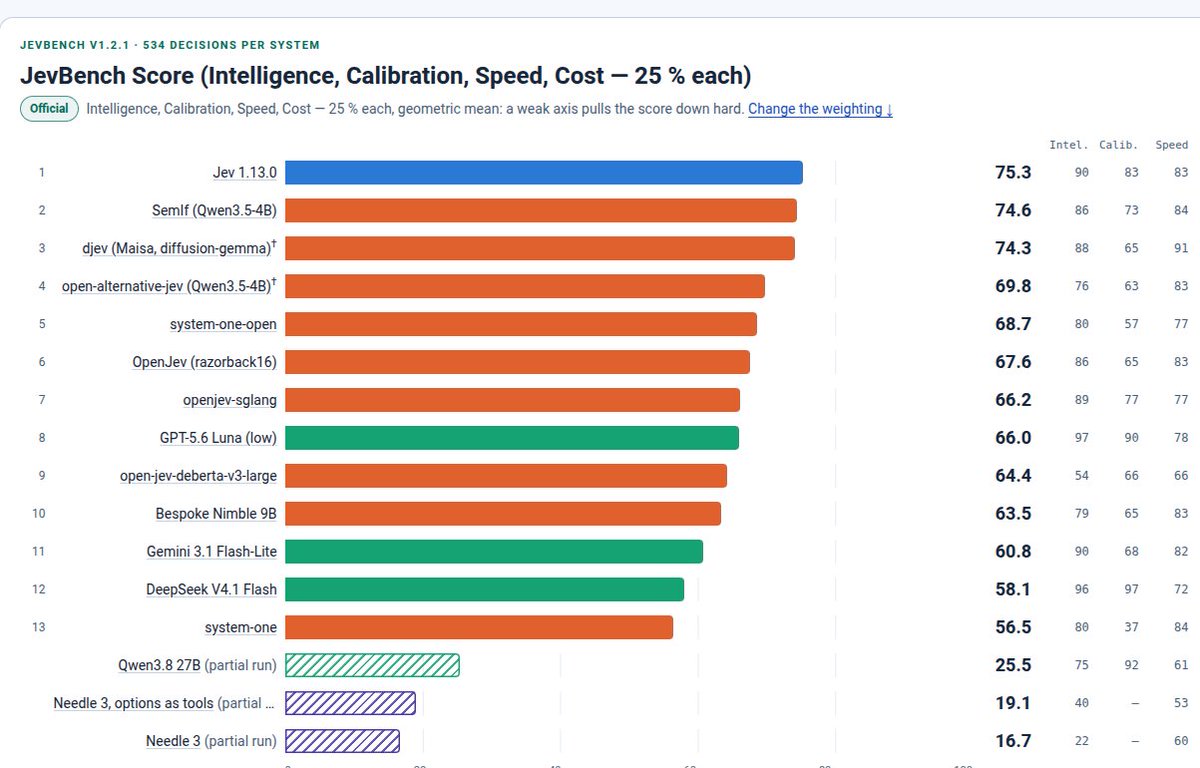
Ra mắt JevBench: Chuẩn đánh giá mới cho các mô hình ra quyết định có cấu trúc

A new benchmark called JevBench just dropped. for models whose output is a bounded software decisio…

DịchJevBench là bộ tiêu chuẩn mới đánh giá khả năng đưa ra quyết định phần mềm có giới hạn thay vì văn bản tự do. Điểm số được tính dựa trên sự cân bằng giữa độ chính xác, tốc độ và chi phí, giúp tối ưu hóa hiệu suất thực tế cho các ứng dụng AI chuyên biệt.

19/09

Thứ Bảy · 4 tin
Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 41/100

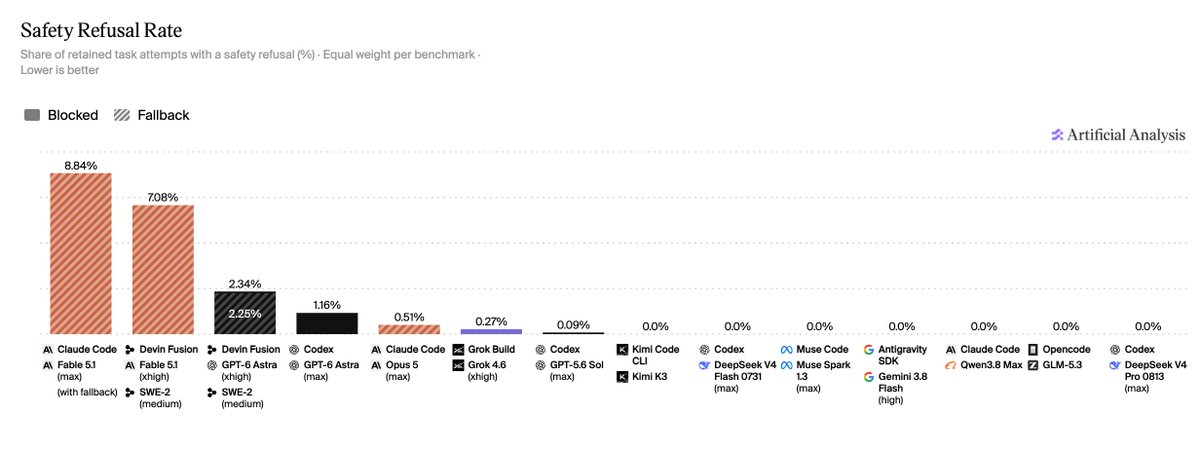
Artificial Analysis cập nhật chỉ số Coding Agent: Bổ sung báo cáo từ chối an toàn

Safety refusal reporting is now available in the Artificial Analysis Coding Agent Index In our late…

DịchArtificial Analysis vừa bổ sung báo cáo từ chối an toàn vào Coding Agent Index v1.5 để làm rõ hành vi của các mô hình. Đáng chú ý, Claude Fable 5.1 ghi nhận tỷ lệ 'fallback' cao nhất trên Claude Code và Devin Fusion, ảnh hưởng trực tiếp đến kết quả đánh giá.

Anthropic@AnthropicAI
NgànhĐiểm AI 47/100

Anthropic bắt tay cùng Accenture đầu tư 1 tỷ USD phát triển đánh giá AI tiên phong

We're partnering with Accenture on independent evaluation of frontier AI-part of our recent commitme…

DịchAnthropic hợp tác với Accenture để xây dựng hệ thống đánh giá AI độc lập, với cam kết đầu tư ít nhất 1 tỷ USD trong 5 năm tới nhằm nâng cao năng lực kiểm định công nghệ AI.

Diễn biến sự kiện · 12 bài →Thêm 5 nguồn khác đưa tinThe Verge: AIIT HomeTechCrunch: AIHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)The Decoder: AI News

18/09

Thứ Sáu · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

UFO: Khung đánh giá chuỗi cho mô hình tạo ảnh đa phương thức với độ chính xác cao

UFO là khung đánh giá đầu tiên phân tách quá trình kiểm định ảnh thành các đơn vị nguyên tử (AEU), giúp đo lường sự tương thích giữa văn bản và hình ảnh hiệu quả hơn 15,25% so với các phương pháp cũ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

VA-Bench: Bước tiến mới trong đánh giá trí tuệ không gian cho robot thông qua quan sát và hành động

VA-Bench là bộ tiêu chuẩn mới đánh giá khả năng 'quan sát-suy luận-hành động-điều chỉnh' của mô hình đa phương thức (MLLM) trong môi trường robot, nơi mô hình tự học từ video RGB và điều khiển hành động thực tế.

Ethan Mollick@emollick
NgànhĐiểm AI 48/100

Epoch AI ra mắt chương trình đánh giá chất lượng các bộ tiêu chuẩn AI

Epoch continues to do some of the best public benchmarking work on AI. This is helpful (and tells us…

DịchEpoch AI vừa khởi động dự án Benchmark Reviews nhằm kiểm định độ tin cậy của các bộ tiêu chuẩn AI hiện nay. Kết quả ban đầu cho thấy trong 15 bộ tiêu chuẩn được kiểm tra, chỉ có 4 bộ đạt yêu cầu, trong khi 9 bộ khác bị đánh giá là có khiếm khuyết.

Thêm 1 nguồn khác đưa tinX: Karina Nguyen (@karinanguyen)
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (39 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “đánh giá AI” — Trang 2 | AIHOT.vn