Meta Connect 2026: Kính Muse, đột phá về giọng nói, video và trợ lý Charm
Đội ngũ của Mark Zuckerberg tiếp tục gây bão với hàng loạt công nghệ mới tại Meta Connect 2026, từ kính thông minh Muse đến các tính năng AI đa phương thức đầy ấn tượng.
Tiến triển âm thanh AI: Tổng hợp giọng nói, trò chuyện thời gian thực, tạo nhạc và mô hình hiểu âm thanh.
726 bài thu thập36 tinh chọncập nhật đến 27/09 18:01
Đội ngũ của Mark Zuckerberg tiếp tục gây bão với hàng loạt công nghệ mới tại Meta Connect 2026, từ kính thông minh Muse đến các tính năng AI đa phương thức đầy ấn tượng.
OpenAI@OpenAIWe heard you loud and clear. ChatGPT Voice can now: - Use plugins like your email, calendar, and Sl…
DịchChatGPT Voice cập nhật tính năng hỗ trợ plugin như Email, Lịch và Slack, vận hành bởi bộ ba mô hình GPT-6 Astra, Sol và Luna, cho phép người dùng thực hiện các tác vụ phức tạp chỉ bằng giọng nói.

Greg Brockman@gdbmega upgrade for GPT Voice, which can now use tools and is available in Work:
DịchGPT Voice được nâng cấp mạnh mẽ với khả năng sử dụng công cụ như email, lịch, Slack và được vận hành bởi bộ ba GPT-6 Astra, Sol và Luna. Tính năng này hiện đã hỗ trợ trên ChatGPT Work, cho phép người dùng tạo tài liệu, website và xử lý tác vụ phức tạp chỉ bằng giọng nói.
ChatGPT Voice nay vận hành trên các mô hình GPT-6 Astra, Sol và Luna, cho phép người dùng quản lý công việc, gửi email và xây dựng website thông qua giọng nói, hiện thực hóa tầm nhìn về một trợ lý AI cá nhân toàn năng.
Google DeepMind giới thiệu hai mô hình Gemini 3.8 Flash TTS và Flash-Lite TTS, hỗ trợ tạo giọng nói từ mô tả tự nhiên, sao chép mẫu âm thanh 30 giây và xử lý đa ngôn ngữ với khả năng điều khiển biểu cảm chuyên sâu.
Diễn biến sự kiện · 16 bài →Thêm 12 nguồn khác đưa tinArtificial Intelligence News (Web)X: Testing Catalog (@testingcatalog)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)The Decoder: AI NewsSimon Willison BlogX: Logan Kilpatrick (@OfficialLoganK)X: Artificial Analysis (@ArtificialAnlys)X: Ammaar Reshi (@ammaar)IT HomeX: Google AI (@GoogleAI)X: Google DeepMind (@GoogleDeepMind)MarkTechPost
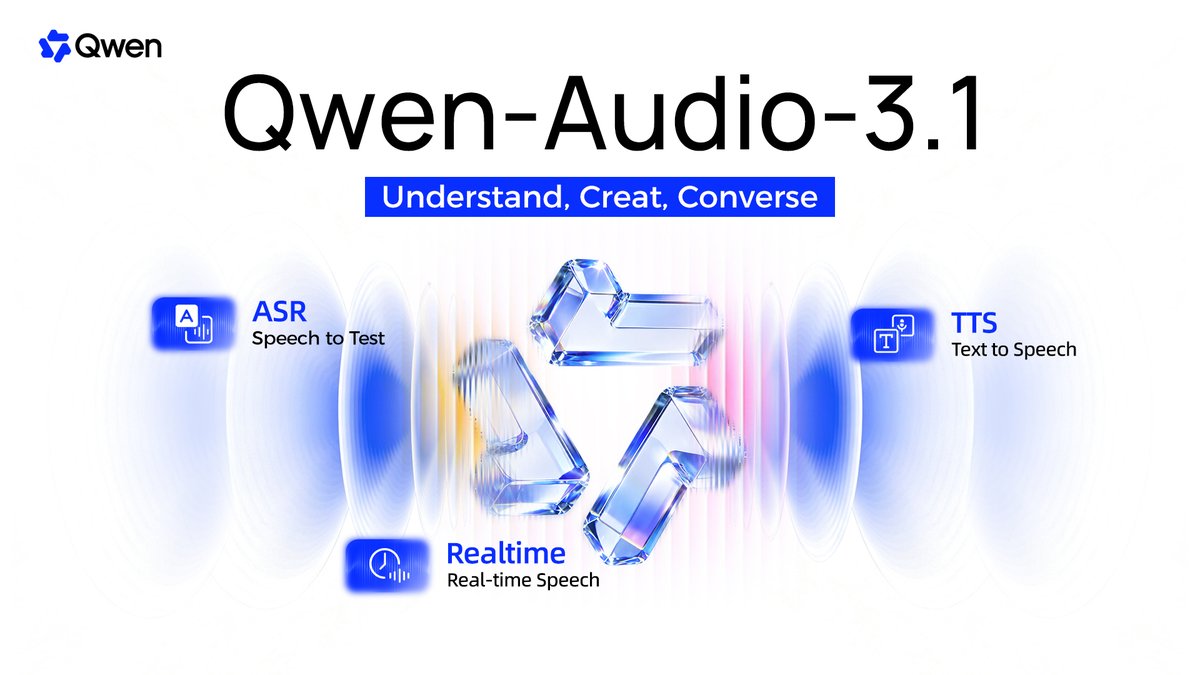
Qwen@Alibaba_Qwen⚡ Meet Qwen-Audio-3.1! ASR, TTS & Realtime are fully upgraded, joined by two new models: TTS-Next fo…
DịchQwen giới thiệu Qwen-Audio-3.1 với 5 mô hình mới, bổ sung TTS-Next và ASR-Next cùng khả năng tương tác thời gian thực thông minh. Đặc biệt, chi phí sử dụng được cắt giảm mạnh tới 95%, hỗ trợ nhận diện cảm xúc và phản hồi tự nhiên hơn.

SteerDuplex là mô hình hội thoại song công (full-duplex) đột phá, cho phép người dùng điều chỉnh linh hoạt tông giọng, phong cách và tốc độ nói thông qua các hướng dẫn trực tiếp, giúp tương tác tự nhiên và thông minh hơn.
xAI vừa giới thiệu Grok Voice Transcribe 2.0, cải thiện độ chính xác gấp đôi so với bản tiền nhiệm trong khi giữ nguyên giá. Mô hình này hiện dẫn đầu bảng xếp hạng của Artificial Analysis về khả năng nhận diện đa ngôn ngữ và giảm đáng kể tỷ lệ lỗi từ ngữ.
Diễn biến sự kiện · 9 bài →Ant Group và Đại học Thanh Hoa vừa công bố Realtime-Venus, hệ thống hỗ trợ đối thoại song công (full-duplex) và xử lý tác vụ bất đồng bộ, bao gồm các mô hình 9B chuyên biệt cho âm thanh và video.
Thêm 1 nguồn khác đưa tinAnt Group inclusionAI: HuggingFace mô hình mớiStepAudio 3 giới thiệu cơ chế 'Think-While-Speaking' cho phép AI suy luận chuyên sâu song song với việc phản hồi bằng giọng nói, tạo ra trải nghiệm hội thoại tự nhiên, mượt mà và có độ trễ cực thấp.
Thêm 1 nguồn khác đưa tinX: Google AI (@GoogleAI)Google DeepMind vừa giới thiệu Gemini 3.8 Live và bản Extended Thinking, tập trung vào khả năng đối thoại giọng nói thời gian thực và xử lý các tác vụ phức tạp.
Diễn biến sự kiện · 18 bài →StepAI vừa trình làng bộ 5 mô hình StepAudio 3 bao gồm Realtime, ASR, TTS, Gen và Music, hiện đã sẵn sàng trải nghiệm trên nền tảng mở của hãng.
Diễn biến sự kiện · 6 bài →
Artificial Analysis@ArtificialAnlysOpenAI's GPT-Live-1 debuts at #1 on the Artificial Analysis Speech to Speech Index at a score of 81….
DịchArtificial Analysis vừa công bố bảng xếp hạng Speech-to-Speech, trong đó GPT-Live-1 (backend Astra) dẫn đầu với 81,5 điểm, vượt qua Grok Voice Think Fast 2.0 High để chiếm vị trí số 1.

Suno trình làng thế hệ mô hình âm nhạc v6 hợp tác cùng các ông lớn ngành âm nhạc, cung cấp ba tùy chọn từ cao cấp đến tối ưu tốc độ cho người dùng.
OpenAI vừa giới thiệu GPT-Live-1, mô hình giọng nói cho phép tương tác hai chiều thời gian thực, hỗ trợ tích hợp các mô hình mạnh mẽ như GPT-6 Astra với mức giá 0,05 USD mỗi phút.
Diễn biến sự kiện · 12 bài →JD.com vừa công bố và mã nguồn mở JoyAI-EchoWM, mô hình thế giới tiên phong tích hợp âm thanh và hình ảnh, cho phép người dùng khám phá không gian 3D với độ nhất quán cao và phản hồi thời gian thực.
Suno@sunoSuno v6 is here. Turn images, videos, and voice memos into music. Make precise changes to songs you…
DịchSuno v6 nâng cấp khả năng chuyển đổi đa phương tiện thành nhạc và cho phép người dùng chỉnh sửa chi tiết các bản nhạc đã tạo. Phiên bản v6-wild cũng được giới thiệu để mở rộng khả năng sáng tạo âm nhạc.
OpenRouter đánh giá mô hình video Seedance 2.5 của ByteDance, nổi bật với khả năng tạo video 4-30 giây, hỗ trợ điều khiển khung hình và tích hợp âm thanh không phát sinh thêm phí.
VoiceMem giới thiệu hệ thống bộ nhớ đa phương thức giúp AI không chỉ hiểu ngữ cảnh mà còn ghi nhớ cảm xúc và âm thanh, biến trợ lý ảo thành người bạn đồng hành thực thụ thay vì chỉ là công cụ vô tri.
TFO là giải pháp plug-and-play cho phép tích hợp khả năng hiểu âm thanh vào các mô hình VLM đóng băng mà không cần thay đổi kiến trúc hay huấn luyện lại, giúp bảo toàn nguyên vẹn năng lực suy luận thị giác ban đầu.
Voice Arena và Hugging Face vừa tích hợp bộ dữ liệu Monsoon cho tiếng Hindi và tiếng Anh Ấn Độ vào bảng xếp hạng Open ASR, đánh dấu cột mốc ngôn ngữ phi châu Âu đầu tiên được đưa vào hệ thống đánh giá này.
Google ra mắt Gemini 3.5 Transcribe, mô hình chuyên biệt cho chuyển đổi giọng nói với độ chính xác cao, hỗ trợ hơn 85 ngôn ngữ, tách lời người nói và tùy chỉnh từ vựng chuyên ngành.
Diễn biến sự kiện · 6 bài →MAVIN là mô hình tiên phong cho phép AI tạo video đa góc quay với khả năng kiểm soát chặt chẽ về thời gian, đồng bộ âm thanh và nhất quán nhân vật, giải quyết bài toán khó trong việc kể chuyện bằng video dài.
JoyAI-Echo-1.5 là hệ thống tạo video và âm thanh đột phá, giúp duy trì tính nhất quán của nhân vật trong các video dài và cho phép tương tác thời gian thực trong môi trường 3D.
Google DeepMind vừa trình làng Gemini 3.5 Transcribe, mô hình chuyển đổi giọng nói thành văn bản với độ chính xác vượt trội, hỗ trợ hơn 85 ngôn ngữ, nhận diện đa người nói và tùy chỉnh từ vựng linh hoạt.
Diễn biến sự kiện · 8 bài →TLive-Omni là mô hình AI đột phá giúp phân tích livestream bán hàng bằng cách hợp nhất dữ liệu từ video, âm thanh, hình ảnh và văn bản. Với cơ chế Per-vGrid và kỹ thuật tinh chỉnh Faithful-RFT, mô hình giúp AI hiểu ngữ cảnh và phản hồi chính xác các thông tin sản phẩm trong thời gian thực.
Nghiên cứu mới từ Hugging Face chỉ ra nhiều mô hình ASR đạt điểm cao nhờ học thuộc lòng dữ liệu kiểm thử thay vì cải thiện khả năng nhận dạng thực tế, dẫn đến kết quả đánh giá bị thổi phồng.
FireRedTTS3 tích hợp khả năng sao chép giọng nói zero-shot, thiết kế âm thanh qua mô tả văn bản và chỉnh sửa giọng nói chính xác trong một mô hình duy nhất, đạt hiệu suất dẫn đầu ngành trên nhiều bảng xếp hạng.
Các nhà khoa học tại EPFL đã phát triển robot siêu nhỏ (tàu và thiết bị bay) sử dụng buồng cộng hưởng 3D để chuyển đổi sóng âm thành lực đẩy, loại bỏ hoàn toàn nhu cầu về động cơ hay linh kiện cơ khí phức tạp.
Công nghệ mô hình thế giới vừa đạt cột mốc mới khi hỗ trợ tạo video đồng bộ âm thanh chất lượng cao theo thời gian thực và sắp sửa được công bố mã nguồn mở hoàn toàn.