Tất cả chủ đề
CHỦ ĐỀ

Đánh giá & So sánh

Đo lường sức mạnh mô hình: Kết quả Benchmark tranh cãi, phương pháp đánh giá và biến động bảng xếp hạng.

1.006 bài thu thập72 tinh chọncập nhật đến 28/09 00:12

Tiêu điểm gần đây

14 ngày qua, xếp theo số nguồn độc lập cùng đưa tin
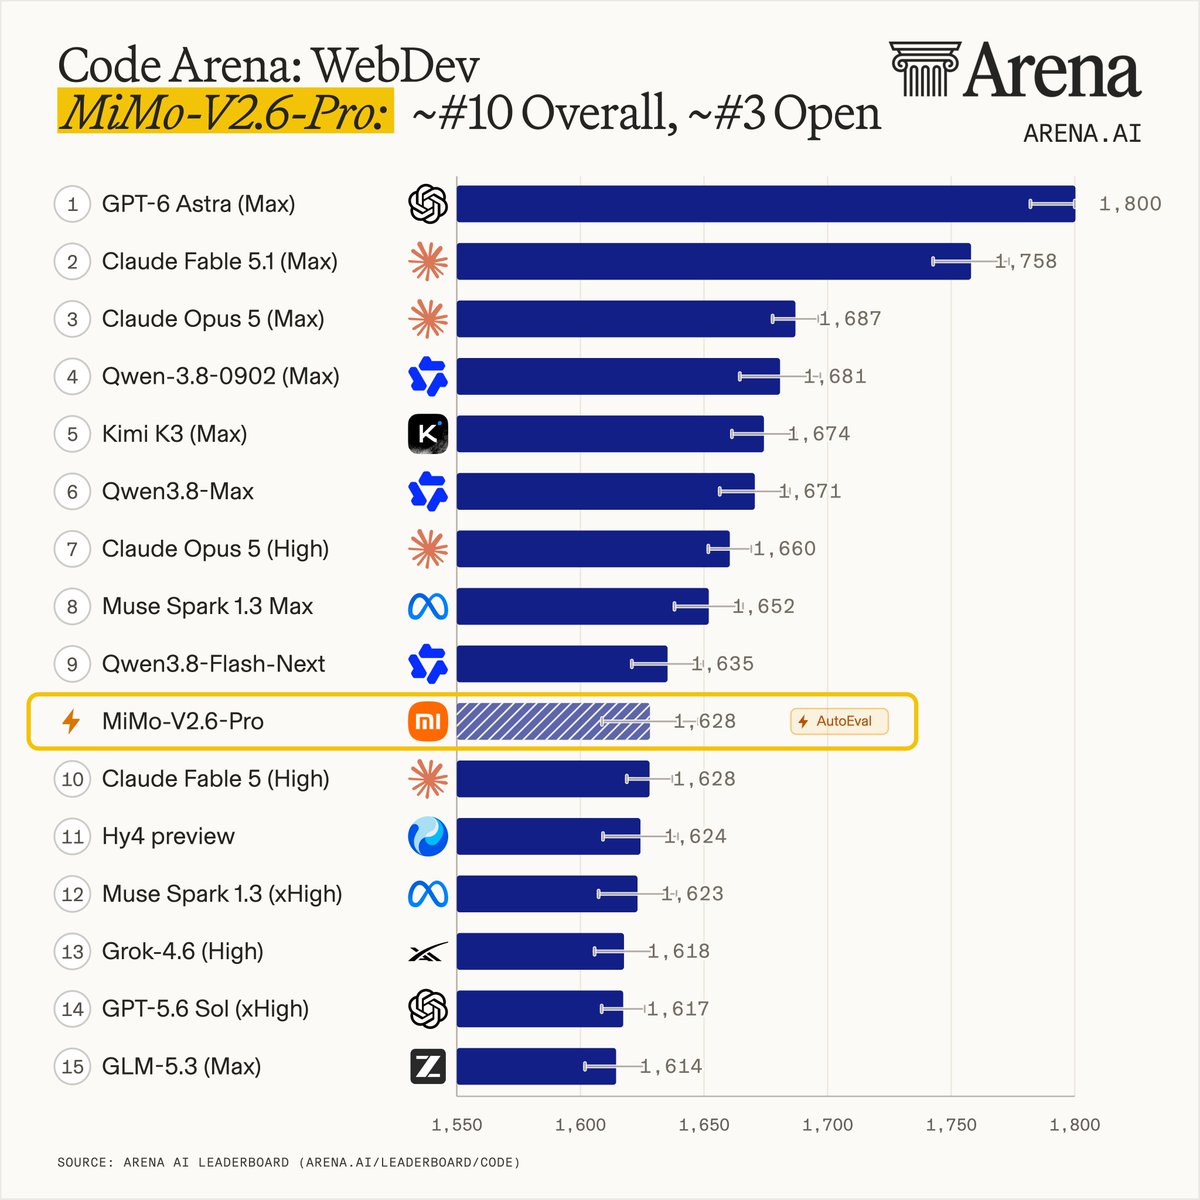
  1. Xiaomi ra mắt MiMo-V2.6-Pro: Lọt Top 10 bảng xếp hạng lập trình WebDev14 nguồn · 22-09
  2. MiMo-V2.6-Pro bứt phá trên bảng xếp hạng Code Arena: Top 10 toàn cầu về lập trình web11 nguồn · 22-09
  3. METR công bố báo cáo đánh giá tiền triển khai cho Claude Opus 5.57 nguồn · 25-09
  4. Google ra mắt Gemini 3.8 Live: Đỉnh cao mới trong công nghệ hội thoại giọng nói6 nguồn · 16-09
  5. Grok 4.7 bám đuổi sát nút Opus 5 với chi phí chỉ bằng một nửa5 nguồn · 22-09

24/09

Thứ Năm · 2 tin
Hugging Face Daily Papers
Điểm AI 92/100

Kho mã nguồn Schrödinger: Liệu LLM thực sự hiểu lập trình hay chỉ đang học vẹt SWE-bench?

Nghiên cứu giới thiệu SchrodingerRepo, một khung đánh giá mới giúp loại bỏ tình trạng 'học vẹt' bằng cách thay đổi cấu trúc mã nguồn động, buộc các tác nhân AI phải thực sự tư duy thay vì dựa vào dữ liệu đã ghi nhớ từ trước.


Vì sao đáng đọc: Đề tài rất quan trọng trong bối cảnh các benchmark lập trình hiện nay đang bị bão hòa do dữ liệu rò rỉ, ảnh hưởng trực tiếp đến độ tin cậy của các mô hình coding AI.
OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Điểm AI 62/100

OpenAI hợp tác cùng hơn 80 chuyên gia ra mắt MentalHealthBench: Chuẩn mực mới đánh giá AI trong tâm lý học

OpenAI công bố MentalHealthBench, bộ tiêu chuẩn đánh giá khả năng hỗ trợ tâm lý của AI, được xây dựng bởi hơn 80 chuyên gia từ 22 quốc gia và hỗ trợ 19 ngôn ngữ.

Thêm 3 nguồn khác đưa tinX: OpenAI (@OpenAI)IT HomeX: Rohan Paul (@rohanpaul_ai)
Vì sao đáng đọc: Bài viết cung cấp phương pháp xây dựng tiêu chuẩn, thiết kế trọng số chấm điểm và cách thức phát hành mở, giúp các nhà nghiên cứu tái hiện hoặc mở rộng việc đánh giá mô hình trong lĩnh vực sức khỏe tâm thần.

23/09

Thứ Tư · 3 tin
JiQiZhiXin
Điểm AI 88/100

Laya: 'Bản sao mã nguồn mở' của Jev gây sốt trên Hugging Face nhờ tốc độ xử lý siêu nhanh

Laya, mô hình ra quyết định System 1 mã nguồn mở, đang thống trị bảng xếp hạng Hugging Face nhờ khả năng chạy cục bộ với độ trễ cực thấp, vượt xa Jev 1.13.0 trong các tác vụ tương tác thời gian thực.


Vì sao đáng đọc: Tin tức cập nhật xu hướng công nghệ mới, phân tích kỹ thuật thú vị về mô hình System 1 và sự chuyển dịch từ cloud sang local, rất hữu ích cho cộng đồng AI.
Qwen@Alibaba_Qwen
Điểm AI 64/100

Qwen-Image-2.1 dẫn đầu bảng xếp hạng mã nguồn mở về chỉnh sửa và tạo ảnh trên Arena

Thanks @arena for the recognition! 🏆 Qwen-Image-2.1 is now the #1 open-source model in both the Ima…

DịchAlibaba thông báo Qwen-Image-2.1 đã vươn lên vị trí số 1 trong các mô hình mã nguồn mở trên bảng xếp hạng Arena cho cả hai hạng mục chỉnh sửa ảnh và tạo ảnh từ văn bản.


Vì sao đáng đọc: Bài viết cung cấp thứ hạng số 1 về mã nguồn mở và điểm số cụ thể từ hai bảng xếp hạng Arena, giúp độc giả so sánh trình độ hiện tại của các mô hình hình ảnh mã nguồn mở.
Artificial Analysis bài đầy đủ (Web)
Điểm AI 78/100

Artificial Analysis đánh giá GPT-6 Sol và Luna: Chi phí giảm một nửa, hiệu năng biến động

Artificial Analysis công bố kết quả đánh giá GPT-6 Sol và Luna của OpenAI. Với mức giá giảm 50% so với GPT-5.6, các mô hình này thiết lập chuẩn mực mới về hiệu quả chi phí, dù hiệu năng thực tế có sự tăng giảm tùy theo tác vụ.

Diễn biến sự kiện · 32 bài →
Vì sao đáng đọc: Tin tức quan trọng về các mô hình mới nhất của OpenAI, cung cấp dữ liệu benchmark thực tế về chi phí và hiệu năng, rất hữu ích cho người dùng doanh nghiệp và lập trình viên.

22/09

Thứ Ba · 6 tin
QbitAI
Điểm AI 92/100

Xiaomi lập kỷ lục 'livestream luyện AI': Đốt 20 triệu trong 6 ngày để thống trị bảng xếp hạng mã nguồn mở

Xiaomi vừa kết thúc buổi livestream 'luyện' mô hình AI đầy ấn tượng, thu hút sự chú ý lớn từ cộng đồng công nghệ và nhận được lời khen ngợi từ CEO Hugging Face.


Vì sao đáng đọc: Sự kiện livestream luyện mô hình AI công khai của Xiaomi là một bước đi táo bạo, minh bạch và thu hút sự quan tâm lớn từ giới chuyên môn lẫn cộng đồng mã nguồn mở.
WeChat: Khazix
Điểm AI 72/100

So sánh thực tế Grok 4.7 và Xiaomi MiMo V2.6: MiMo V2.6 thiết lập chuẩn mực mới về hiệu năng và chi phí

Trải nghiệm thực tế cho thấy Grok 4.7 gây thất vọng so với kỳ vọng, trong khi Xiaomi MiMo V2.6 trở thành lựa chọn tối ưu nhất hiện nay nhờ sự cân bằng hoàn hảo giữa hiệu năng, tốc độ và giá thành.


Vì sao đáng đọc: Bài đánh giá thực tế từ người dùng có uy tín, cung cấp góc nhìn so sánh trực diện giữa hai mô hình AI mới, rất hữu ích cho cộng đồng đang tìm kiếm giải pháp tối ưu chi phí.
Artificial Analysis@ArtificialAnlys
Điểm AI 65/100

Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần

StepFun's Step 5 Preview scores 44 on the Artificial Analysis Intelligence Index, matching Kimi K3 (…

DịchMô hình Step 5 Preview của StepFun đạt 44 điểm trên bảng xếp hạng Artificial Analysis, ngang hàng với Kimi K3. Điểm nhấn là chi phí vận hành chỉ khoảng 0.72 USD mỗi tác vụ, tối ưu hơn gần 3 lần so với các mô hình cùng phân khúc.

Diễn biến sự kiện · 10 bài →Thêm 2 nguồn khác đưa tinX: StepFun (@StepFun_ai)WeChat: StepFun (Step)
Vì sao đáng đọc: Thông tin cập nhật về hiệu suất và chi phí của mô hình AI mới, rất hữu ích cho người dùng doanh nghiệp và giới công nghệ đang tìm kiếm giải pháp tối ưu chi phí.
Arena@arena
Điểm AI 66/100

Xiaomi ra mắt MiMo-V2.6-Pro: Lọt Top 10 bảng xếp hạng lập trình WebDev

MiMo-V2.6-Pro just landed @XiaomiMiMo back in the top 10 on Code Arena: WebDev, debuting at ~#10 ove…

DịchXiaomi vừa trình làng hai mô hình toàn năng MiMo-V2.6-Pro và Flash. Trong đó, MiMo-V2.6-Pro đạt 1628 điểm trên bảng xếp hạng Code Arena, đứng thứ 10 chung cuộc và thứ 3 trong nhóm mô hình mã nguồn mở.

Diễn biến sự kiện · 15 bài →Thêm 12 nguồn khác đưa tinX: karminski (@karminski3)X: Elvis Saravia (@omarsar0, DAIR.AI)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)IT HomeX: Luo Fuli (@_LuoFuli)X: Testing Catalog (@testingcatalog)X: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)Latent SpacePandailyXiaomi MiMo: Phát hành và blog chính thứcX: Xiaomi MiMo (@XiaomiMiMo)X: Ma Dongxi NLP (@dongxi_nlp)
Vì sao đáng đọc: Tin tức quan trọng về bước tiến của Xiaomi trong lĩnh vực mô hình ngôn ngữ lớn, đặc biệt là khả năng lập trình được cộng đồng quốc tế ghi nhận.
Clément Delangue (Hugging Face CEO)@ClementDelangue
Điểm AI 69/100

Xiaomi ra mắt mô hình MiMo-V2.6-Pro: Đứng đầu bảng xếp hạng Artificial Analysis

Banger! https://huggingface.co/collections/XiaomiMiMo/mimo-v26

DịchXiaomi vừa trình làng MiMo-V2.6-Pro, mô hình mã nguồn mở đạt 46 điểm trên bảng xếp hạng Artificial Analysis, chính thức soán ngôi vị dẫn đầu trong phân khúc mô hình mở.


Vì sao đáng đọc: Đây là cột mốc quan trọng của Xiaomi trong lĩnh vực AI, cho thấy sự tiến bộ vượt bậc về hiệu năng của các mô hình mở so với các đối thủ cạnh tranh.
Artificial Analysis bài đầy đủ (Web)
Điểm AI 67/100

Đánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ

Grok 4.7 đạt 46 điểm trên bảng xếp hạng Artificial Analysis, chính thức lọt vào Top 4 mô hình thông minh nhất. Đặc biệt, khả năng lập trình của Grok Build đã tăng vọt lên 56 điểm, khẳng định vị thế cạnh tranh trực tiếp với các đối thủ hàng đầu như Claude và GPT.

Diễn biến sự kiện · 24 bài →Thêm 1 nguồn khác đưa tinX: Artificial Analysis (@ArtificialAnlys)
Vì sao đáng đọc: Tin tức cập nhật về hiệu năng của một mô hình AI lớn đang được quan tâm, có số liệu so sánh cụ thể giúp người dùng dễ dàng nắm bắt vị thế của Grok trên thị trường.

21/09

Thứ Hai · 1 tin
Fireworks AI (Web)
Điểm AI 61/100

Fireworks AI ra mắt Specialized Intelligence Index: Chuẩn đo lường năng lực AI chuyên sâu

Fireworks AI giới thiệu Specialized Intelligence Index (SII), bộ chỉ số đánh giá hiệu suất các mô hình AI trên 7 lĩnh vực thực tế như y tế, luật, tài chính và lập trình, giúp người dùng so sánh chính xác giữa các mô hình nguồn mở và đóng.


Vì sao đáng đọc: Đây là công cụ hữu ích giúp giải quyết bài toán đánh giá AI trong các ngành dọc, thay vì chỉ dựa vào các bài test tổng quát chung chung.

20/09

Chủ Nhật · 1 tin
JiQiZhiXin
Điểm AI 92/100

CausalWM: Khi 'Chuỗi tư duy nhân quả' giúp mô hình thế giới đạt đỉnh cao mới

Aether AI ra mắt CausalWM, mô hình thế giới 16B tham số sử dụng 'Chuỗi tư duy nhân quả' để hiểu cơ chế vận động vật lý thay vì chỉ dự đoán hình ảnh, xuất sắc dẫn đầu bảng xếp hạng TriWorldBench.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc giải quyết bài toán 'hộp đen' của mô hình thế giới, chuyển từ dự đoán bề mặt sang hiểu bản chất vật lý, có tính ứng dụng cao trong robot học.

19/09

Thứ Bảy · 2 tin
OpenRouter: Announcements
Điểm AI 63/100

OpenRouter thử nghiệm Jev: Khi nào nên dùng mô hình ra quyết định thay vì LLM tạo văn bản?

OpenRouter so sánh mô hình Jev 1.13 với GPT và Claude trong việc phân loại yêu cầu. Kết quả cho thấy Jev tối ưu hơn hẳn về chi phí và tốc độ, đạt độ chính xác tương đương LLM trong các tác vụ logic cụ thể.

Diễn biến sự kiện · 10 bài →
Vì sao đáng đọc: Bài viết cung cấp góc nhìn thực tế về tối ưu hóa chi phí và hiệu năng, rất hữu ích cho các kỹ sư đang tìm cách thay thế LLM bằng các mô hình chuyên biệt.
xAI: News (Web)
Điểm AI 63/100

xAI ra mắt mô hình chuyển đổi giọng nói Grok Voice Transcribe 2.0 với độ chính xác vượt trội

xAI vừa giới thiệu Grok Voice Transcribe 2.0, cải thiện độ chính xác gấp đôi so với bản tiền nhiệm trong khi giữ nguyên giá. Mô hình này hiện dẫn đầu bảng xếp hạng của Artificial Analysis về khả năng nhận diện đa ngôn ngữ và giảm đáng kể tỷ lệ lỗi từ ngữ.

Diễn biến sự kiện · 9 bài →
Vì sao đáng đọc: Đây là bước tiến quan trọng của xAI trong lĩnh vực xử lý âm thanh, có tính ứng dụng thực tế cao và hiệu suất vượt trội so với các đối thủ cạnh tranh.

18/09

Thứ Sáu · 1 tin
JiQiZhiXin
Điểm AI 92/100

EMNLP 2026: Tại sao LLM lại trả lời sai dù thực tế đã 'biết' đáp án?

Nghiên cứu từ Đại học Bắc Kinh và YIXIN AI Lab chỉ ra rằng LLM thường trả lời sai do 'nút thắt đọc dữ liệu' (Readout Bottleneck), nơi đáp án đúng đã tồn tại trong trạng thái ẩn nhưng bị sai lệch khi chuyển đổi thành kết quả đầu ra.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi trong đánh giá năng lực LLM, thách thức cách đo lường benchmark hiện nay và cung cấp góc nhìn mới về cơ chế suy luận của mô hình.

17/09

Thứ Năm · 2 tin
JiQiZhiXin
Điểm AI 92/100

ZDTaichu 5.0-9B: Mô hình mã nguồn mở 9B mạnh nhất cho trí tuệ nhân tạo hiện thân

ZDTaichu 5.0-9B thiết lập tiêu chuẩn mới cho các mô hình dưới 10B, dẫn đầu 8/9 bảng xếp hạng về trí tuệ nhân tạo không gian và vượt mặt nhiều đối thủ lớn nhờ công nghệ suy luận vòng lặp thích ứng.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong lĩnh vực mô hình nhỏ (SLM) với khả năng ứng dụng thực tế cao trong robot và AI hiện thân, đồng thời cung cấp lộ trình kỹ thuật minh bạch.
Pandaily
Điểm AI 88/100

Light Origins ra mắt mã nguồn mở LightNav-0: Bộ não điều hướng đa năng cho robot

LightNav-0 là mô hình điều hướng dựa trên Qwen3-VL-4B, được huấn luyện qua quy trình Real2Sim2Real với hơn 4.000 giờ dữ liệu VLA, đạt hiệu suất dẫn đầu trên 10 bảng xếp hạng điều hướng đơn thị giác.


Vì sao đáng đọc: Bước tiến quan trọng trong điều hướng robot với khả năng zero-shot ấn tượng, mã nguồn mở giúp thúc đẩy nghiên cứu thực tiễn trong cộng đồng AI.

16/09

Thứ Tư · 3 tin
JiQiZhiXin
Điểm AI 92/100

DM0.5 thống trị RoboColiseum: 'Vua' mới của các bảng xếp hạng robot thông minh

Mô hình DM0.5 tiếp tục khẳng định vị thế dẫn đầu khi quét sạch 4 bảng xếp hạng tại RoboColiseum, nâng tổng số chiến thắng lên 6 trên 6 cuộc thi đánh giá robot khác nhau, chứng minh khả năng thích nghi vượt trội trong mọi môi trường.


Vì sao đáng đọc: Tin tức cập nhật về bước tiến quan trọng trong lĩnh vực robot thông minh (Embodied AI), cho thấy sự tiến bộ vượt bậc của mô hình DM0.5 qua nhiều bài kiểm tra khắt khe.
Pandaily
Điểm AI 88/100

Xiaomi mã nguồn mở mô hình thế giới Robotics-U0 cho robot thông minh

Xiaomi vừa công bố mã nguồn mở Robotics-U0, mô hình nền tảng thế giới tự hồi quy với quy mô lên tới 38 tỷ tham số, giúp tăng tốc độ xử lý gấp 83 lần và dẫn đầu bảng xếp hạng WorldArena về khả năng mô phỏng cảnh quan robot.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong lĩnh vực robot học (embodied AI) từ một tập đoàn lớn, việc mở mã nguồn sẽ thúc đẩy mạnh mẽ cộng đồng nghiên cứu và phát triển robot tự hành.
Arena@arena
Điểm AI 68/100

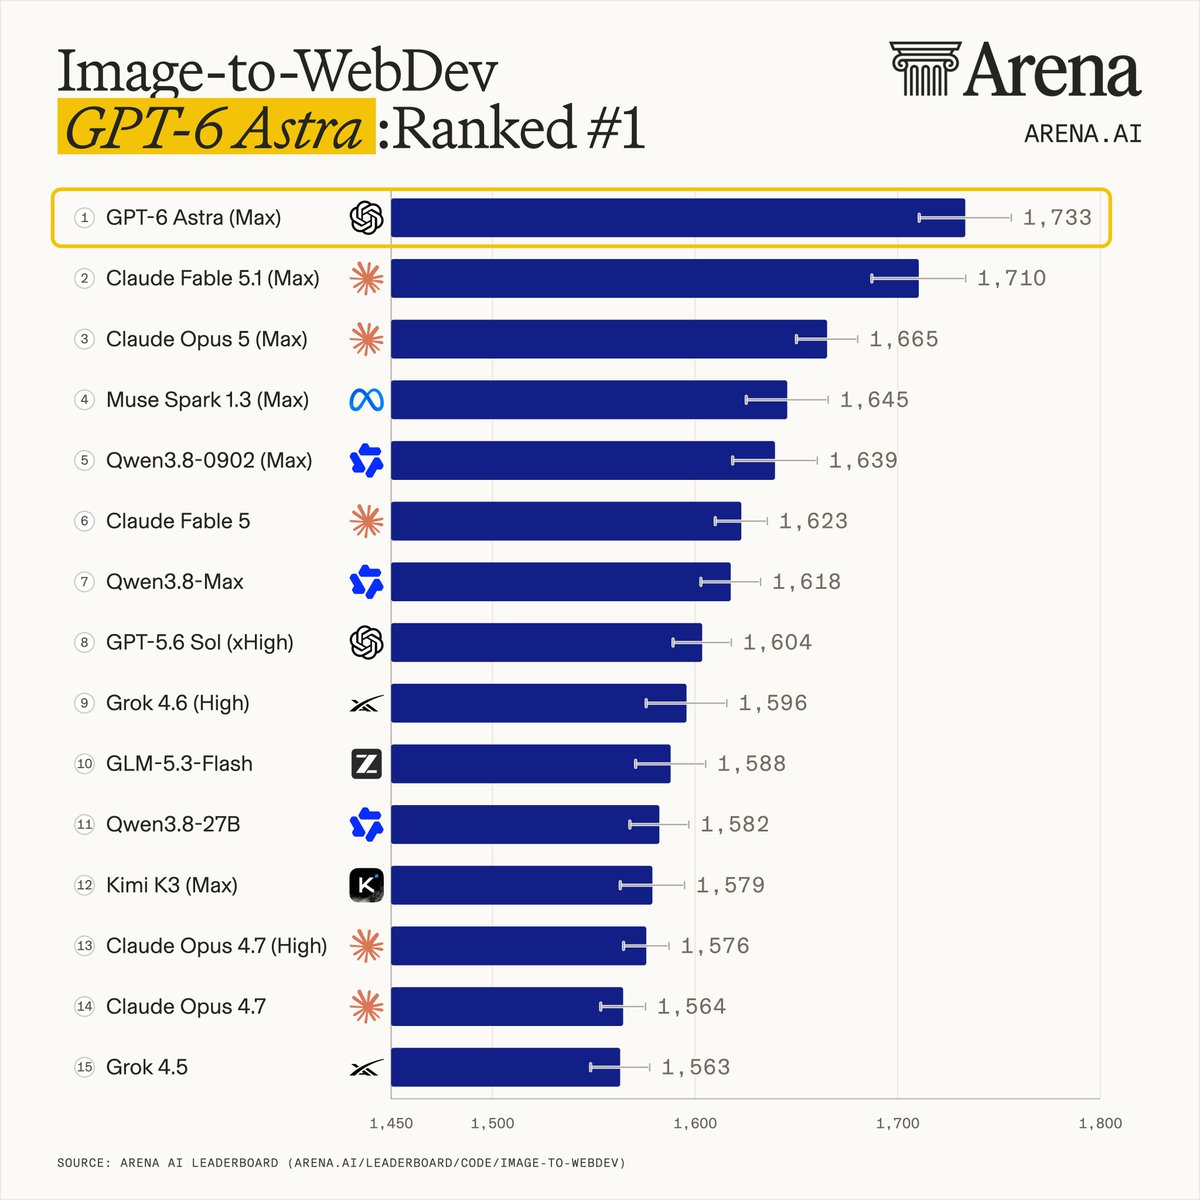
Bảng xếp hạng Image-to-WebDev cập nhật: GPT-6 Astra dẫn đầu với 1733 điểm

Image-to-WebDev Arena update: four newly evaluated model releases have landed! - #1 GPT-6 Astra (Ma…

DịchArena vừa cập nhật bảng xếp hạng Image-to-WebDev với sự góp mặt của 4 mô hình mới. GPT-6 Astra (Max) xuất sắc giành vị trí quán quân với 1733 điểm, vượt xa các đối thủ như Claude Fable 5.1 và Muse Spark 1.3.


Vì sao đáng đọc: Thông tin cập nhật về các mô hình AI tạo mã nguồn từ hình ảnh rất được cộng đồng lập trình viên và người dùng AI quan tâm, có tính thời sự cao.

15/09

Thứ Ba · 4 tin
Trail of Bits: Nghiên cứu an toàn AI
Điểm AI 60/100

Trail of Bits chỉ trích báo cáo AI của 1Password là gây hiểu lầm, công bố bộ kiểm chứng mới

Trail of Bits cho rằng báo cáo của 1Password về khả năng tự sửa lỗi của AI bị sai lệch do thiết kế thử nghiệm thiếu khách quan. Họ đã công bố hai bản vá mới để đánh giá chính xác hơn năng lực thực tế của các tác nhân AI.


Vì sao đáng đọc: Tin tức chuyên sâu về kiểm chứng AI, vạch trần các lỗ hổng trong phương pháp luận của doanh nghiệp lớn, có giá trị cao cho cộng đồng kỹ thuật.
WeChat: StepFun (Step)
Điểm AI 65/100

StepAI ra mắt dòng mô hình âm thanh StepAudio 3: Thống trị bảng xếp hạng toàn cầu của Artificial Analysis

StepAI vừa trình làng bộ 5 mô hình StepAudio 3 bao gồm Realtime, ASR, TTS, Gen và Music, hiện đã sẵn sàng trải nghiệm trên nền tảng mở của hãng.

Diễn biến sự kiện · 6 bài →
Vì sao đáng đọc: Sự kiện quan trọng khi một mô hình AI nội địa đạt thứ hạng cao trên bảng xếp hạng quốc tế uy tín, thu hút sự quan tâm lớn từ cộng đồng công nghệ.
Artificial Analysis@ArtificialAnlys
Điểm AI 66/100

GPT-Live-1 của OpenAI soán ngôi đầu bảng xếp hạng Speech-to-Speech của Artificial Analysis

OpenAI's GPT-Live-1 debuts at #1 on the Artificial Analysis Speech to Speech Index at a score of 81….

DịchArtificial Analysis vừa công bố bảng xếp hạng Speech-to-Speech, trong đó GPT-Live-1 (backend Astra) dẫn đầu với 81,5 điểm, vượt qua Grok Voice Think Fast 2.0 High để chiếm vị trí số 1.


Vì sao đáng đọc: Tin tức cập nhật về hiệu năng mô hình AI mới nhất từ nguồn uy tín, cung cấp dữ liệu so sánh thực tế hữu ích cho người dùng và giới công nghệ.
Arena@arena
Điểm AI 66/100

DeepSeek-V4.1-Flash (Max) vươn lên vị trí thứ 3 trên bảng xếp hạng Agent Arena

Exciting news: DeepSeek-V4.1-Flash (Max) by @deepseek_ai just landed in Agent Arena at #3 among open…

DịchDeepSeek-V4.1-Flash (Max) đạt vị trí thứ 3 trong nhóm mô hình mã nguồn mở trên Agent Arena với hiệu suất tăng 4,87% và chi phí tối ưu chỉ 0,07 USD mỗi tác vụ, vượt xa các đối thủ về hiệu quả kinh tế.


Vì sao đáng đọc: Tin tức quan trọng về hiệu suất và tối ưu chi phí của mô hình DeepSeek, thu hút sự quan tâm lớn từ cộng đồng AI và các nhà phát triển ứng dụng Agent.

14/09

Thứ Hai · 2 tin
QbitAI
Điểm AI 92/100

Đột phá AI vật lý từ Trung Quốc: PhysBrain 1.5 dẫn đầu bảng xếp hạng mã nguồn mở toàn cầu

PhysBrain 1.5 vừa thiết lập cột mốc mới trong lĩnh vực trí tuệ không gian, khẳng định vị thế ngang hàng với các mô hình tiên tiến như GPT-6 Astra bằng cách giải quyết thành công bài toán vòng lặp vật lý phức tạp.


Vì sao đáng đọc: Tin tức quan trọng về bước tiến công nghệ của Trung Quốc trong lĩnh vực AI vật lý, có tác động lớn đến cộng đồng nghiên cứu và cạnh tranh toàn cầu.
OpenRouter: Announcements
Điểm AI 61/100

Hướng dẫn OpenRouter: Tự động đánh giá đầu ra của AI Agent bằng phương pháp LLM-as-a-judge

OpenRouter chia sẻ cách sử dụng mô hình AI làm giám khảo để chấm điểm tự động cho các phản hồi của AI Agent, giúp kiểm soát chất lượng các câu trả lời mở mà phương pháp kiểm thử truyền thống không làm được.


Vì sao đáng đọc: Đây là kỹ thuật thực tiễn cao cho các nhà phát triển AI, giúp tối ưu hóa quy trình kiểm thử và nâng cao chất lượng phản hồi của Agent một cách tự động.

13/09

Chủ Nhật · 1 tin
Dario Amodei@DarioAmodei
Điểm AI 61/100

CEO Anthropic kêu gọi làm chậm tốc độ phát triển AI và đề xuất lộ trình 3 bước

We Must Pace the Frontier: I've written a new essay on why the AI industry should slow down, with a …

DịchDario Amodei, CEO của Anthropic, vừa công bố bài viết kêu gọi ngành AI cần giảm tốc độ phát triển. Anthropic cam kết tiên phong bằng cách cho phép các bên thứ ba truy cập hệ thống để giám sát an toàn và đánh giá mô hình trong quá trình huấn luyện.

Diễn biến sự kiện · 33 bài →Thêm 1 nguồn khác đưa tinX: Peter McCrory (Anthropic Kinh tế trưởng, @PeterMcCrory)
Vì sao đáng đọc: Đây là tuyên bố quan trọng từ lãnh đạo một công ty AI hàng đầu về đạo đức và an toàn, có tác động lớn đến định hướng phát triển của toàn ngành.

12/09

Thứ Bảy · 2 tin
JiQiZhiXin
Điểm AI 95/100

Chấn động: 25 chủ nhân giải Fields, bao gồm Terence Tao, cảnh báo AI đang hủy hoại toán học

25 nhà toán học hàng đầu thế giới đã ký tên vào bức thư ngỏ chỉ trích các công ty AI vì ưu tiên chạy đua benchmark thay vì tuân thủ quy trình nghiên cứu khoa học chuẩn mực, gây ra sự lệch lạc nghiêm trọng trong cộng đồng toán học.


Vì sao đáng đọc: Sự kiện có tầm ảnh hưởng lớn với sự tham gia của các tên tuổi hàng đầu giới toán học, đặt ra vấn đề đạo đức và phương pháp luận quan trọng trong phát triển AI.
Epoch AI: Nghiên cứu, dữ liệu và đánh giá
Điểm AI 60/100

Epoch AI đánh giá ExploitBench v0.1: Bộ tiêu chuẩn kiểm thử khả năng khai thác lỗ hổng V8

Epoch AI công bố đánh giá về ExploitBench v0.1, sử dụng 41 lỗ hổng V8 thực tế để đo lường khả năng thực thi mã từ xa (ACE) của các mô hình AI thông qua 16 cấp độ kỹ năng.


Vì sao đáng đọc: Đây là tài liệu quan trọng về an ninh mạng trong AI, cung cấp phương pháp đo lường thực tế cho khả năng tấn công của mô hình, rất có giá trị cho giới chuyên môn.
Đánh giá & So sánh — Chủ Đề AI | AIHOT.vn