Hướng dẫn
Trước thềm BrainGPT: Khi AI bắt đầu giải mã trực tiếp não bộ con người
(giờ Việt Nam)
Tóm tắt AI
Một bài viết ngắn từ Monolith Capital đặt ra giả thuyết về tương lai của BrainGPT, nơi AI có khả năng thấu hiểu và tương tác trực tiếp với não bộ, dù chưa có thông tin kỹ thuật cụ thể.
Chính văn · Bản dịch AI
Năm 2006, một bệnh nhân bị liệt do chấn thương tủy sống đã được cấy một mảng vi điện cực vào vỏ não vận động. Bằng cách tưởng tượng các chuyển động của bàn tay, anh ấy có thể điều khiển con trỏ máy tính, mở email, điều chỉnh TV và thậm chí thực hiện các cử động cánh tay robot đơn giản. Bài báo có tiêu đề "Neuronal Ensemble Control of Prosthetic Devices by a Human with Tetraplegia" là nghiên cứu đầu tiên chứng minh trực tiếp rằng ý định vận động trong não bộ có thể bỏ qua hoàn toàn cơ thể để tác động đến máy móc.
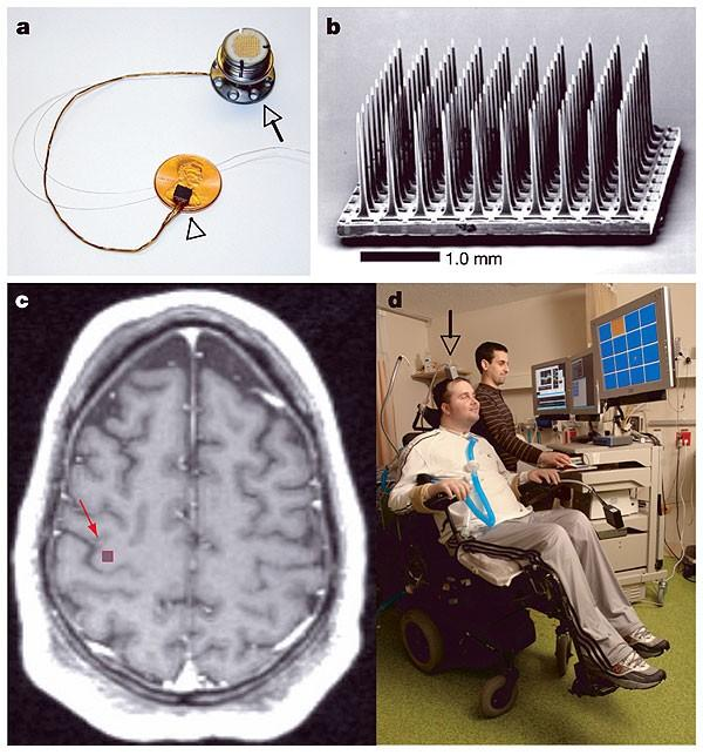
Năm 2006, Hochberg và cộng sự đã trình bày một phương pháp cấy ghép BCI xâm lấn BrainGate thời kỳ đầu trong bài báo "Neuronal Ensemble Control of Prosthetic Devices by a Human with Tetraplegia".
Mười lăm năm sau, một bệnh nhân liệt khác đã tưởng tượng việc viết chữ bằng tay và tạo ra văn bản với tốc độ 90 ký tự mỗi phút. Đến năm 2023, các BCI ngôn ngữ đã đạt tốc độ 62 và 78 từ mỗi phút, thậm chí có thể điều khiển một avatar kỹ thuật số để nói chuyện.
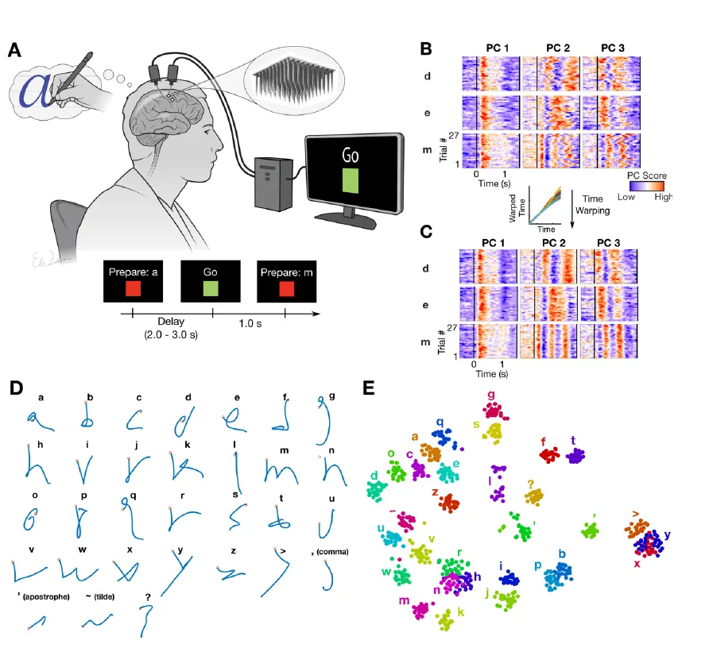
Mã hóa hoạt động thần kinh của việc viết tay tưởng tượng, như được trình bày trong bài báo năm 2021 của Willett và cộng sự: "High-Performance Brain-to-Text Communication via Handwriting".
Neuralink vẫn tiếp tục thúc đẩy các thử nghiệm trên người, và các công ty AI cũng đang gia nhập lĩnh vực này. OpenAI đã tham gia vào vòng gọi vốn hạt giống của Merge Labs với một luận điểm đơn giản: những tiến bộ trong phương thức tương tác sẽ thúc đẩy những tiến bộ trong sức mạnh tính toán. Theo tầm nhìn này, BCI cung cấp một kênh truyền dẫn ý định trực tiếp hơn, trong khi AI đảm nhận nhiệm vụ diễn giải các tín hiệu thần kinh hạn chế và đầy nhiễu đó.
Đây là lý do tại sao chúng tôi theo dõi sát sao các giao diện não-máy (BCI).
Nhìn lại quá trình tiến hóa của máy tính, khoảng cách giữa con người và máy móc đã dần thu hẹp: từ bàn phím và chuột, màn hình cảm ứng, giọng nói, và giờ là ngôn ngữ tự nhiên cùng các AI agent. Khi máy móc ngày càng thông minh hơn, một câu hỏi tự nhiên được đặt ra: Liệu con người có còn cần đến ngón tay và ngôn ngữ để nói cho máy móc biết họ muốn gì không?
Vào ngày 29 tháng 8, Monolith đã tổ chức buổi tọa đàm kín về Giao diện Não-Máy MonoX (MonoX Brain-Computer Interface Salon), quy tụ những tiếng nói từ các lĩnh vực BCI xâm lấn, mô hình nền tảng não bộ, thiết bị hỗ trợ thần kinh bằng ngôn ngữ và hình ảnh, da điện tử và siêu âm. Chúng tôi muốn trả lời hai câu hỏi:
BCI hiện đang ở đâu? Và điều gì còn thiếu để tạo ra một bước nhảy vọt thực sự cho sản phẩm?
Sau vài giờ thảo luận với hơn một trăm người tham gia, dưới đây là một vài quan sát mà chúng tôi thấy đáng để chia sẻ.
MonoX: Tọa đàm kín về Giao diện Não-Máy
Ý nghĩa của "BCI" phụ thuộc hoàn toàn vào người sử dụng nó
Ngày nay, thật dễ dàng để đưa tất cả các công ty BCI vào một bảng tính và so sánh. Nhưng đối với một bệnh nhân liệt so với một người bình thường, đề xuất giá trị là hoàn toàn khác biệt.
Người bệnh có thể sử dụng BCI để gõ phím, nói chuyện hoặc điều khiển lại cánh tay robot. Nếu hiệu quả đủ ấn tượng, các quy trình lâm sàng phức tạp hơn, chi phí cao hơn, thậm chí là một số rủi ro phẫu thuật — tất cả đều trở nên có thể thương lượng.
Người bình thường lại có yêu cầu khắt khe hơn nhiều. Điện thoại, giọng nói và cử chỉ hiện đã hoạt động rất tốt. Một thiết bị BCI chỉ đơn thuần cho phép tôi "nhấp chuột bằng suy nghĩ" là một sản phẩm khó bán vì những phiền toái khi phải đeo nó, chưa kể đến phẫu thuật cấy ghép.
Do đó, các phương pháp tiếp cận kỹ thuật đã hình thành nên những phân khúc riêng biệt.
Các điện cực xâm lấn nằm gần các neuron, thu được tín hiệu rõ ràng và có băng thông cao hơn, nhưng phải đánh đổi bằng phẫu thuật và rủi ro cấy ghép lâu dài. EEG (điện não đồ) an toàn và có khả năng mở rộng hơn nhiều, nhưng tín hiệu phải đi qua da đầu và hộp sọ, gây ra nhiều nhiễu hơn đáng kể. ECoG (điện vỏ não), nội mạch, da điện tử và siêu âm đều tạo ra sự cân bằng riêng giữa chất lượng tín hiệu, mức độ xâm lấn, thời gian sử dụng và chi phí.
Càng gần não bộ, chất lượng tín hiệu càng cao và mức độ xâm lấn phẫu thuật càng lớn.
Nguồn: Saha và cộng sự, Frontiers in Human Neuroscience, 2026
Vì vậy, việc chỉ hỏi "Phương pháp nào tốt nhất?" không còn hữu ích nữa. Câu hỏi tốt hơn là: Ứng dụng này có xứng đáng với những gì người dùng phải đánh đổi hay không?
Hiện tại, những câu trả lời rõ ràng nhất đến từ khía cạnh y tế. Việc nâng cấp con người ở mức độ tiêu dùng vẫn còn là một chặng đường dài.
Đây là lý do đầu tiên khiến BCI chưa có khoảnh khắc "iPhone 4" của riêng mình: công nghệ đã phân mảnh thành nhiều hướng đi, nhưng thị trường vẫn chưa hội tụ.
BCI vẫn chưa tìm ra "công thức dữ liệu" của mình
AI là biến số lớn nhất trong làn sóng hào hứng với BCI này.
Ngôn ngữ, hình ảnh và video hiện đều đã có các mô hình nền tảng, vì vậy tự nhiên mọi người đặt câu hỏi: Liệu chúng ta có thể huấn luyện một mô hình tổng quát cho não bộ hay không?
Vấn đề là, dữ liệu não bộ khó xử lý hơn nhiều so với dữ liệu internet.
Lấy EEG làm ví dụ: dữ liệu não bộ trước tiên phải được thu thập thông qua các điện cực trên da đầu, sau đó được khuếch đại và xử lý trước khi có thể sử dụng để phân tích.
Nguồn: Nagel & Spüler, Scientific Reports, 2019
Văn bản là thông tin có tỷ lệ tín hiệu trên nhiễu cao mà con người đã cấu trúc sẵn; tín hiệu não bộ lại bị nhiễm bởi việc chớp mắt, nghiến răng, nói chuyện, cử động cơ thể và nhiễu môi trường. Vấn đề sâu xa hơn là phần lớn dữ liệu vẫn đến từ các bệnh viện và phòng thí nghiệm: ai đó ngồi ghi lại trong vài giờ, thí nghiệm kết thúc và luồng dữ liệu bị cắt đứt.
Một người tham dự gọi đây là "bức tường dữ liệu": chất lượng, quy mô và sự đa dạng là những yếu tố cực kỳ khó để thỏa mãn cùng một lúc.
Các tập dữ liệu EEG công khai đã tích lũy lên đến hàng chục terabyte, nhưng phần lớn đến từ các thiết bị khác nhau, bệnh viện khác nhau, nhiệm vụ khác nhau, với siêu dữ liệu không nhất quán. Hàng chục terabyte tệp tin và hàng chục terabyte dữ liệu thực sự có thể huấn luyện được là hai khái niệm hoàn toàn khác nhau.
Thú vị là, không có sự đồng thuận nào về điểm này tại sự kiện.
Một nhóm tin rằng ưu tiên hàng đầu là thu thập dữ liệu tốt hơn. Tín hiệu não bộ thay đổi liên tục: điện cực dịch chuyển, trở kháng thay đổi, người dùng đổ mồ hôi hoặc nói chuyện, và đầu vào của mô hình cũng thay đổi theo. Nếu không có dữ liệu thực tế ổn định và lâu dài, ngay cả những mô hình lớn nhất cũng gặp khó khăn trong việc học hỏi.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ elsewhere: Bài viết. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.