Nghiên cứu
Epoch AI phân tích độ trễ khi xử lý ngữ cảnh dài trên GPT-5.6 và Claude 5
(giờ Việt Nam)
Tóm tắt AI
Nghiên cứu từ Epoch AI cho thấy GPT-5.6 có độ trễ TTFT tăng theo đường cong bậc hai khi ngữ cảnh dài, trong khi dòng Claude 5 duy trì hiệu suất gần như tuyến tính.
Chính văn · Bản dịch AI
Giới thiệu
OpenAI và Anthropic định giá các prompt dài theo những cách rất khác nhau. Cả hai đều có cửa sổ ngữ cảnh (context window) tương đương: các mô hình GPT-5.6 có tối đa 1,05 triệu token, trong khi các mô hình Claude có tối đa 1 triệu token. Tuy nhiên, các yêu cầu gửi đến mô hình OpenAI với hơn 272.000 token đầu vào sẽ bị tính phí gấp đôi giá đầu vào thông thường và giá đầu vào được lưu trong bộ nhớ đệm (cached-input), cùng với mức phí gấp 1,5 lần giá đầu ra thông thường. Ngược lại, các mô hình Claude giữ mức giá cố định bất kể độ dài đầu vào. Mặc dù giá cả không nhất thiết phản ánh chi phí suy luận (inference cost) thực tế, nhưng sự khác biệt về giá này đã thúc đẩy chúng tôi kiểm tra xem liệu hai dòng mô hình này có cho thấy sự thay đổi về độ trễ (latency scaling) khác nhau theo độ dài ngữ cảnh hay không.
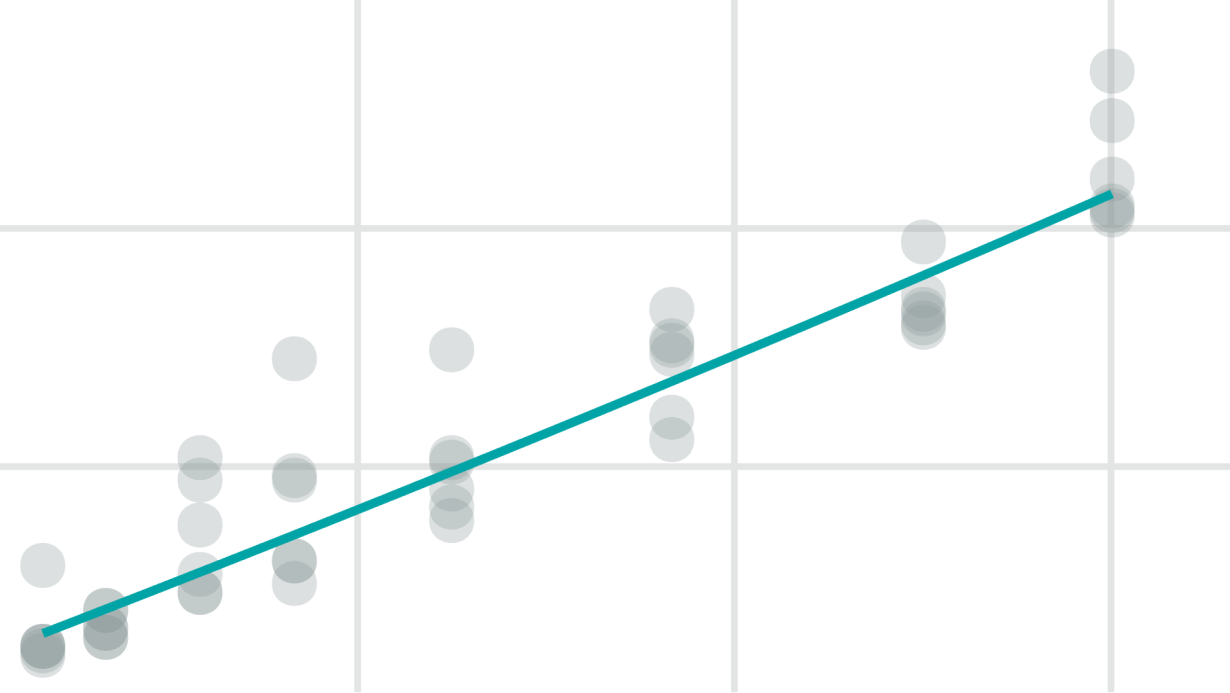
Chúng tôi đã đo lường cách thời gian tạo token đầu tiên (TTFT) thay đổi theo độ dài ngữ cảnh đối với các mô hình GPT-5.6 Terra và Sol của OpenAI, cùng Claude Sonnet 5 và Opus 5 của Anthropic. Chúng tôi nhận thấy hai dòng mô hình này hoạt động rất khác biệt. Terra và Sol cho thấy độ cong hướng lên rõ rệt khi các prompt dài hơn, nhất quán với một thành phần bậc hai đáng kể. Sonnet 5 duy trì mức độ thay đổi gần như tuyến tính mà không có độ cong quan sát được, trong khi Opus có dữ liệu nhiễu hơn nhưng vẫn nhất quán với sự thay đổi tuyến tính. Để kiểm tra ảnh hưởng của nhiễu trong các phép đo, chúng tôi đã áp dụng ba bộ ước lượng với các giả định khác nhau về nhiễu độ trễ và nhận thấy cả ba đều cho ra độ cong tương tự đối với GPT-5.6, trong khi vẫn giữ các kết quả khớp (fits) của Claude gần với đường tuyến tính hơn.
Kết quả này cho thấy OpenAI và Anthropic đã đưa ra những lựa chọn kiến trúc rất khác nhau trong cách các mô hình tương ứng của họ xử lý các prompt có ngữ cảnh dài. Sự thay đổi gần như tuyến tính của Claude cho thấy cơ chế full-attention (trong đó mỗi token chú ý đến toàn bộ độ dài ngữ cảnh và chi phí tính toán tăng theo bậc hai so với độ dài ngữ cảnh) đóng góp ít hơn nhiều vào quá trình xử lý ngữ cảnh dài so với GPT.
GPT và Claude cho thấy sự thay đổi độ trễ theo ngữ cảnh dài khác nhau
Chúng tôi đã đo lường TTFT khi tắt tính năng suy luận (reasoning) trên các độ dài ngữ cảnh khác nhau cho bốn mô hình: GPT-5.6 Terra, GPT-5.6 Sol, Claude Sonnet 5 và Claude Opus 5. Chi tiết về thiết lập đo lường được cung cấp trong phần phụ lục.
Chúng tôi khớp một đường cong bậc hai cho mỗi mô hình bằng cách sử dụng bộ ước lượng Student-t. Phân tích trên cả bốn tập dữ liệu đều sử dụng cùng một đặc tả bậc hai:
Terra và Sol cho thấy độ cong đáng kể. Sonnet có biểu đồ tuyến tính trực quan. Opus có dữ liệu nhiễu hơn Sonnet nhưng cũng gần với đường tuyến tính tương tự. Nói cách khác, đối với GPT-5.6, việc thêm cùng một số lượng token dẫn đến sự gia tăng TTFT ngày càng lớn khi ngữ cảnh tăng lên, trong khi đối với Claude, độ trễ tăng thêm vẫn gần như không đổi.
Sự khác biệt này vẫn ổn định trước các cách xử lý nhiễu độ trễ API khác nhau
Các điểm chuẩn (benchmark) TTFT có thể bị nhiễu. Chúng tôi đã thiết kế các thí nghiệm để giảm thiểu điều này, nhưng rõ ràng vẫn còn nhiễu đáng kể trong kết quả, đặc biệt là đối với Opus. Một số biến động TTFT có khả năng xuất phát từ chính quá trình thực thi mô hình, nhưng giả thuyết của chúng tôi là phần lớn nhiễu phát sinh từ các độ trễ phục vụ cấp cao hơn, chẳng hạn như xếp hàng và định tuyến. Điều này thúc đẩy chúng tôi sử dụng các bộ ước lượng coi một phần đáng kể nhiễu độ trễ là độ trễ cộng dồn dương thay vì sai số đo lường đối xứng.
Để kiểm tra tính ổn định đối với nhiễu này, chúng tôi lặp lại phân tích bằng cách sử dụng hai bộ ước lượng mới xử lý nhiễu độ trễ theo cách khác: hồi quy biên ngẫu nhiên (stochastic-frontier regression) và mô hình spike-plus-contention. Cả hai đều mô hình hóa rõ ràng độ trễ dương bổ sung từ sự tranh chấp (contention), trong khi hồi quy Student-t làm giảm ảnh hưởng của các quan sát cực đoan. Vì các bộ ước lượng nhắm vào các khái niệm hơi khác nhau về độ trễ cơ bản, các mức khớp của chúng không nhất thiết phải trùng khớp; bài kiểm tra phù hợp ở đây là liệu chúng có đồng ý về hình dạng của mối quan hệ với độ dài ngữ cảnh hay không. Các đặc tả mô hình đầy đủ được đưa ra trong phụ lục.
Như mong đợi, các bộ ước lượng khớp với các đường cong hơi khác nhau, nhưng cả ba vẫn đồng ý về độ cong. Do đó, chúng ta có thể nói rằng hành vi thay đổi bậc hai khó có khả năng là do các giá trị ngoại lai (outliers) kéo đường cong lên trên.
Sonnet có kết quả sạch nhất. Dữ liệu cho thấy độ khớp rất gần với đường tuyến tính trên cả ba bộ ước lượng. Opus nhiễu hơn nhiều, nhưng cả ba bộ ước lượng vẫn tạo ra các đường khớp với độ cong tối thiểu. Các hình 1–3 cùng cho thấy các mô hình GPT và Claude được thử nghiệm có các đường cong thay đổi rõ ràng khác nhau.
Hiệu quả ngữ cảnh dài đã trở thành một lựa chọn thiết kế
Theo truyền thống, các LLM dựa trên kiến trúc transformer đã sử dụng các lớp full-attention, nơi mỗi token chú ý đến tất cả các token đứng trước nó. Do đó, tổng chi phí tính toán attention để xử lý một prompt tăng theo bậc hai so với độ dài prompt. Nhiều dòng mô hình mã nguồn mở đã chuyển sang hướng thay đổi ngữ cảnh dài hiệu quả hơn. Các mô hình lai như Kimi K3 và Qwen3.5 kết hợp các lớp linear attention với số lượng lớp full-attention ít hơn nhiều, cụ thể là tỷ lệ 3:1. Điều này làm giảm số lượng lớp full-attention xuống bốn lần, và do đó giảm số hạng bậc hai theo cùng một tỷ lệ. Qwen3.8-Flash-Next và GLM-5.3-Flash đã tiến xa hơn theo hướng này bằng cách thay thế các lớp full-attention bằng sparse attention. Các lớp sparse attention có thành phần bậc hai nhỏ hơn so với full-attention trong khi vẫn có thể chú ý đến toàn bộ độ dài ngữ cảnh. Sliding-window attention là một kỹ thuật nổi tiếng khác; nó đã xuất hiện trong các mô hình gpt-oss mã nguồn mở của OpenAI. Với kích thước cửa sổ cố định, sliding-window attention có chi phí attention trên mỗi token gần như không đổi và tổng chi phí tuyến tính theo độ dài chuỗi. Hướng đi chung của tất cả các mô hình này là giảm lượng tính toán bậc hai cần thiết ở các ngữ cảnh dài.
Kết quả của chúng tôi cho thấy Anthropic cũng đã tiếp cận việc thay đổi độ trễ theo cách này, ít nhất là đối với các mô hình mà chúng tôi đã đánh giá. Cả Sonnet và Opus đều có độ cong bậc hai nhỏ hơn nhiều so với các mô hình GPT. Điều này cũng phù hợp với thực tế là tất cả các mô hình thế hệ Claude 5 trong Claude Code đều hỗ trợ cửa sổ ngữ cảnh 1 triệu token theo mặc định. Ngược lại, OpenAI dường như đang thực hiện một sự đánh đổi khác. Mặc dù dòng mô hình GPT-5.6 hỗ trợ cửa sổ ngữ cảnh 1,05 triệu token, Codex mặc định tự động nén (autocompacting) trước ngưỡng 272.000 token. OpenAI đã mô tả việc tránh tình trạng quá tải ngữ cảnh (context bloat) là mục tiêu thiết kế chính cho Codex. Các nhân viên cấp cao của OpenAI đã công khai tuyên bố rằng họ không khuyến nghị tăng cửa sổ ngữ cảnh mặc định 272.000 token của Codex, mặc dù hỗ trợ chính thức lên tới 1,05 triệu.
Ý nghĩa về chi phí của các kiến trúc khác nhau
Dưới đây là một ví dụ minh họa sử dụng bảng giá API của Anthropic cho Opus 5 đối với một yêu cầu 100.000 token:
Bảng 1. Chi phí API giả định cho một yêu cầu Opus 5 với 100.000 token ngữ cảnh được lưu trong bộ nhớ đệm, 1.000 token đầu vào mới và 1.000 token đầu ra.
Nếu ngữ cảnh là 900.000 token, riêng phần đầu vào được lưu trong bộ nhớ đệm sẽ có giá 0,45 USD. Nếu giá đầu vào được lưu trong bộ nhớ đệm tăng gấp đôi, như với các mô hình GPT-5.6, chi phí đầu vào được lưu sẽ tăng 18 lần thay vì 9 lần khi tăng từ 100.000 lên 900.000 token ngữ cảnh.
Vì vậy, trong khi giá của Claude giữ nguyên, việc tăng ngữ cảnh dẫn đến sự gia tăng đáng kể về chi phí. Ngược lại, Codex mặc định tự động nén trước ngưỡng 272.000 token, giúp giữ cho ngữ cảnh bị giới hạn về kích thước và chi phí thấp hơn. Có khả năng OpenAI đang đặt cược rằng ngữ cảnh 1 triệu token thường là không cần thiết, hoặc việc tiết kiệm chi phí sẽ bù đắp cho bất kỳ sự sụt giảm hiệu suất nào từ các ngữ cảnh ngắn hơn.
A.1 Xây dựng yêu cầu và bộ nhớ đệm tiền tố chia sẻ (shared-prefix caching)
Đối với mỗi mô hình, các prompt được tạo như sau.
Nonce 16 chữ số là một số duy nhất thay đổi cho mỗi yêu cầu. Văn bản cụ thể theo độ dài mục tiêu là một đoạn văn bản từ văn bản Project Gutenberg kết hợp. Điểm ngắt (breakpoint) được đặt trước nonce để nonce đóng vai trò là điểm ngắt bộ nhớ đệm chính xác. Nonce thay đổi đảm bảo rằng không có khả năng khớp bộ nhớ đệm tiền tố (prefix cache hit) sau nó. Chỉ dẫn tác vụ được cố định: “Do not think or analyze. Respond immediately with exactly one word: OK”. Đối với các yêu cầu gửi đến cùng một mô hình ở độ dài ngữ cảnh cố định, chỉ phần nonce của prompt thay đổi.
Các yêu cầu của OpenAI sử dụng điểm ngắt bộ nhớ đệm prompt rõ ràng, chế độ bộ nhớ đệm rõ ràng và một prompt_cache_key dành riêng cho phiên. Các yêu cầu của Anthropic sử dụng điểm ngắt bộ nhớ đệm rõ ràng với TTL (thời gian tồn tại) là năm phút. Các prompt cho các mô hình GPT là giống hệt nhau (ngoại trừ nonce thay đổi theo từng yêu cầu). Điều tương tự cũng áp dụng cho các mô hình Claude. Điều này là do các mô hình được thử nghiệm có cùng số lượng token cho các prompt của chúng tôi trong mỗi dòng.
Chúng tôi nhắm mục tiêu kích thước 2048 cho tiền tố được lưu trong bộ nhớ đệm. Kích thước thực tế là 2051 cho các mô hình GPT và 2052 cho các mô hình Claude. Văn bản còn lại dao động từ khoảng 48.000 đến 898.000 token. Một yêu cầu khởi động bộ nhớ đệm (cache warmup) được gửi trước với chỉ tiền tố ổn định và một nonce không được lưu trong bộ nhớ đệm. Chúng tôi xác nhận rằng mọi yêu cầu được đo lường đều báo cáo chính xác số lượng token được lưu trong bộ nhớ đệm như mong đợi (lần lượt là 2051 và 2052 cho các mô hình GPT và Claude).
Các phép hồi quy của chúng tôi sử dụng độ dài ngữ cảnh danh nghĩa được tính toán trước đó bằng cách sử dụng nonce giữ chỗ và phần kết thúc hơi khác. Độ dài đầu vào thực tế do nhà cung cấp báo cáo ngắn hơn chính xác 2 token đối với OpenAI và ngắn hơn 6 token đối với Anthropic khi so sánh với danh nghĩa.
A.2 Tại sao TTFT lại có ý nghĩa ở ngữ cảnh dài
Suy luận được chia thành các giai đoạn riêng biệt là prefill (tiền xử lý) và decode (giải mã). Prefill là quá trình xử lý các token đầu vào, trong khi decode là quá trình xử lý các token đầu ra. Các token đầu vào có thể được xử lý song song trong quá trình prefill, trong khi các token decode phải được tạo tự hồi quy (autoregressively) từng cái một. Ở các ngữ cảnh đủ dài, điều này có thể khiến prefill bị giới hạn bởi khả năng tính toán (compute-bound) khi có đủ token đầu vào để làm bão hòa các tài nguyên tính toán sẵn có. TTFT bao gồm prefill, tạo token đầu ra đầu tiên và các chi phí phục vụ và mạng khác. Ở độ dài ngữ cảnh dài, prefill có thể mất nhiều giây, nghĩa là thời gian prefill chiếm một phần lớn hơn trong TTFT đo được. Do đó, chúng tôi kỳ vọng TTFT sẽ cung cấp thông tin về thời gian cần thiết cho prefill và cách nó thay đổi theo độ dài ngữ cảnh, đồng thời thừa nhận rằng nó cũng bao gồm các chi phí hệ thống phục vụ.
A.3 Thời gian TTFT và thực thi yêu cầu
Các yêu cầu được gửi tuần tự. Mỗi mô hình sử dụng một kết nối HTTP bền vững. Chúng tôi đợi mỗi yêu cầu kết thúc trước khi gửi yêu cầu tiếp theo. Tính năng suy luận và tư duy (reasoning and thinking) đã bị tắt, và các phản hồi được xác nhận là không sử dụng các token suy luận.
TTFT được đo bằng đồng hồ đơn điệu từ ngay trước khi gửi yêu cầu HTTP đến delta văn bản không trống đầu tiên được truyền phát. Việc lắp ráp prompt, đếm token, tuần tự hóa và xây dựng yêu cầu diễn ra trước khi bộ đếm thời gian bắt đầu; TTFT đo được bao gồm tải lên yêu cầu, thời gian mạng, định tuyến và xếp hàng, tra cứu bộ nhớ đệm, prefill, tạo token đầu tiên và đường dẫn trả về.
A.4 Các khối thời gian ngẫu nhiên
Các yêu cầu được gửi theo khối, với một yêu cầu tại mỗi độ dài ngữ cảnh được thử nghiệm trong mỗi khối. Vòng lặp nhắm mục tiêu bốn giây giữa các lần gửi yêu cầu. Khoảng thời gian bắt đầu yêu cầu trung bình được ghi lại là 4,01 giây cho Terra, 4,75 cho Sol, 4,39 cho Sonnet và 9,00 cho Opus. Các yêu cầu dài hơn đã đẩy khoảng thời gian vượt quá bốn giây.
Bảng A1.
Chúng tôi đã xáo trộn thứ tự ngữ cảnh trong mỗi khối để xen kẽ các prompt ngắn và dài theo thời gian và giảm sự gây nhiễu giữa độ dài ngữ cảnh và các điều kiện phục vụ thay đổi.
Mỗi phép hồi quy cũng bao gồm một hiệu ứng cố định tổng bằng không (sum-to-zero fixed effect) cho mỗi khối để tính đến các thay đổi về độ trễ cơ sở giữa các khối, chẳng hạn như thay đổi điều kiện mạng hoặc phục vụ. Việc loại bỏ các hiệu ứng khối khiến các ước tính độ cong của Terra, Sol và Sonnet gần như không thay đổi. Ước tính điểm của Opus nhạy cảm hơn với đặc tả khối, nhưng kết luận tuyến tính so với bậc hai vẫn không thay đổi.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Epoch AI: Nghiên cứu, dữ liệu và đánh giá. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.