Mô hình
Claude Opus 5.5 bất ngờ ra mắt: Di chuyển 680.000 dòng code trong một ngày, giảm giá API 20%
(giờ Việt Nam)
Tóm tắt AI
Anthropic vừa tung ra bản cập nhật Claude Opus 5.5 với hiệu suất vượt trội, cho phép xử lý khối lượng code khổng lồ chỉ trong 24 giờ và giảm 60% chi phí đọc bộ nhớ đệm.
Chính văn · Bản dịch AI
< img id="wx_img" src="https://www.qbitai.com/wp-content/uploads/imgs/qbitai-logo-1.png" width="400" height="400">
23/09/2026 12:59:29 Nguồn: QbitAI
Giá đọc bộ nhớ đệm (cache) giảm 60%
Meng Chen, Ting Yu, đưa tin từ Aofeisi, QbitAI | Tài khoản chính thức QbitAI
Flagship mới nhất Claude Opus 5.5 đã đứng đầu bảng xếp hạng benchmark!
Không chỉ giành vị trí số 1 trong nhiều bài kiểm tra tiêu chuẩn như lập trình, công việc tri thức và thao tác máy tính, tốc độ xuất dữ liệu của nó còn nhanh hơn Opus 5 hơn 30%.

Cái đà "tạm dừng" đang tốt thế này, sao chưa đầy hai tuần đã bị đẩy tới rồi.

Vậy bức thư ngỏ "làm chậm sự phát triển biên giới" của CEO Dario Amodei thì tính là gì?
Tính là ông ấy giỏi viết thư thôi.

Thế hệ mô hình này bắt đầu dùng code làm bút vẽ
Thử nghiệm mới lạ nhất hiện nay là sử dụng code thuần để tạo hình ảnh. Hình ảnh chú bồ nông cưỡi xe đạp bằng SVG đã gây bão, lần này là kết xuất (render) bằng Python phức tạp hơn.

Khả năng tương tự có thể mở rộng sang việc sử dụng code JS thuần để tạo video render.
Đứng đầu nhiều bảng xếp hạng, giá API giảm 20%
Họ nói chi phí tác vụ giảm 40%, nhưng giá API không trực tiếp giảm 40%.
Giá đầu vào và đầu ra của Opus 5.5 lần lượt là 4 USD và 20 USD cho mỗi triệu Token, giảm 20% so với Opus 5.
Cộng thêm việc cần ít bước và ít Token hơn để hoàn thành cùng một tác vụ, Anthropic tính toán rằng tổng chi phí cho các tác vụ điển hình có thể giảm 40%.
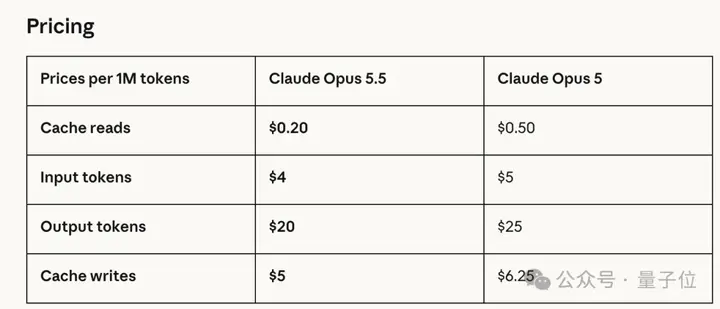
Phần giảm mạnh tay thực sự nằm ở giá đọc bộ nhớ đệm (cache). Hạng mục này đã giảm từ 0,50 USD/triệu Token của Opus 5 xuống còn 0,20 USD, tức giảm 60%.
Những ai làm lập trình Agent đều biết, các cuộc hội thoại dài và tác vụ code quy mô lớn cần đọc đi đọc lại ngữ cảnh, nên việc đọc bộ nhớ đệm thường chiếm phần lớn chi phí. So với đơn giá API trên sổ sách, cú giảm này có lẽ mang lại cảm nhận thực tế hơn.
Ngoài ra còn có chế độ Fast mode, tốc độ xuất dữ liệu nhanh gấp 2,5 lần chế độ tiêu chuẩn, giá cũng tăng gấp đôi lên 8 USD cho đầu vào và 40 USD cho đầu ra mỗi triệu Token, phù hợp với các tình huống đặc biệt nhạy cảm về độ trễ.
Người dùng đăng ký cũng được tăng hạn mức; các gói Pro, Max, Team và phiên bản doanh nghiệp tính phí theo ghế đều được tăng hạn mức sử dụng trong 5 giờ; Anthropic còn cung cấp tính năng reset hạn mức (rate limit) để người dùng tự chọn thời điểm sử dụng.
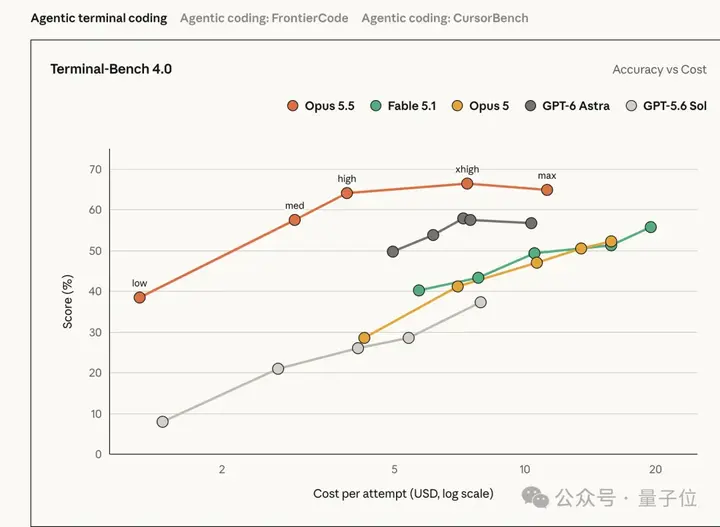
Xét cụ thể về điểm benchmark, bảng xếp hạng mới nhất hiện nay là Terminal-Bench 4.0, dùng để đo lường khả năng xử lý các tác vụ dòng lệnh phức tạp của mô hình.
Opus 5.5 đạt 66,4%, trong khi Opus 5 thế hệ trước là 52,3%, GPT-6 Astra của OpenAI là 57,9% và Fable 5.1 của chính Claude là 55,8%.
Khoảng cách đã được nới rộng rõ rệt.
Trong một bài kiểm tra lập trình khác là FrontierCode v1.1, Opus 5.5 đạt 54,4%, vượt qua mức 53,3% của GPT-6 Astra, khoảng cách không quá rõ rệt.
Hơn nữa, để mức effort (nỗ lực suy luận) ở mức trung bình lại cho kết quả tốt hơn.
Ở mức effort mặc định, tức là cài đặt trung bình, Opus 5.5 đạt 54,6%, vượt qua thành tích cao nhất của các mô hình khác trong bảng và cũng cao hơn một chút so với mức 54,4% khi bật lên mức cao nhất.
Ở trình độ năng lực này, 0,2 điểm phần trăm về cơ bản đã nằm trong phạm vi sai số.
Bản thân Anthropic cũng thừa nhận rằng khoảng cách điểm số ngày càng khó phản ánh chính xác trải nghiệm sử dụng thực tế. Trong nội bộ họ, khoảng cách giữa Opus 5.5 và Fable 5.1 không lớn như trên bảng xếp hạng.
Một bài kiểm tra khác là CursorBench 4.0, đo lường các tác vụ mơ hồ trên nhiều tệp tin từ các phiên làm việc thực tế trên Cursor.
Ở mức effort cao nhất, Opus 5.5 đạt 57,8%, cao hơn 6 điểm so với 51,8% của Fable 5.1 và cao hơn 16,1 điểm so với 41,7% của GPT-5.6 Sol.
Nếu xét về hiệu năng trên giá thành, Opus 5.5 ở mức cài đặt trung bình mặc định đạt 52,5%, vẫn dẫn trước thành tích cao nhất của GPT-5.6 Sol khoảng 11 điểm, trong khi chi phí cho mỗi tác vụ chỉ bằng khoảng 1/3 so với đối thủ.
Opus 5.5 đặc biệt nhấn mạnh sự cải thiện rõ rệt trong các tác vụ ở cấp độ cơ sở mã (codebase) quy mô lớn.
Những người thử nghiệm sớm từng dùng nó để di chuyển 680.000 dòng code và hoàn thành trong chưa đầy một ngày. Nếu là đội ngũ kỹ sư con người, dự kiến sẽ mất ít nhất vài tuần.
Một người thử nghiệm khác đã dùng nó để kiểm toán và sửa lỗi một cơ sở mã 200.000 dòng, mất chưa đầy 3 giờ. Với cùng tác vụ đó, Opus 5 đã mất hơn 20 giờ và số lượng Token sử dụng gấp 2,5 lần.
Bài viết được AI dịch và tổng hợp tự động từ QbitAI. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.