Quan điểm
StepFun: Cần bước ra ánh sáng thay vì ẩn mình dưới gầm bàn
(giờ Việt Nam)
Tóm tắt AI
Bài viết phân tích về chiến lược truyền thông và vị thế hiện tại của StepFun, đặt câu hỏi tại sao một công ty AI tiềm năng lại chọn cách tiếp cận kín tiếng thay vì khẳng định vị thế trên thị trường.
Chính văn · Bản dịch AI
"Hãy dựng bàn ăn của bạn lên" (Lower Your Tray Table) — tôi cứ ngỡ mọi người đã không còn quan tâm đến StepFun nữa, và giả định chung là họ đã từ bỏ việc cạnh tranh với các phòng thí nghiệm mô hình hàng đầu để tập trung vào các mảng phụ trợ phần cứng như điện thoại AI và mô hình trên xe hơi.
Hóa ra, ở một góc khuất không ai để ý, StepFun đã bất ngờ tung ra một mô hình mới — Step 5 Preview, tuyên bố đạt mức tăng 44 điểm trên Artificial Analysis và giành một vị trí trong top 3 mã nguồn mở toàn cầu.
Bối cảnh mô hình nội địa thực sự đang rất mạnh mẽ, với các mô hình mới thay phiên nhau "cày" Opus 5 như thể đang đánh boss. Các mô hình Trung Quốc thực sự đã có thể bay cao.
Tuy nhiên, điểm chuẩn vẫn chỉ là điểm chuẩn. Bạn tôi, @kk, cho rằng trọng số của AA không thực sự có ý nghĩa, vì việc nhồi nhét quá nhiều câu hỏi vào một chỉ số duy nhất sẽ che giấu nhiều thứ hơn là làm sáng tỏ.
Trải nghiệm thực tế của anh ấy cho thấy Step 5 Preview ngang ngửa với DeepSeek V4 Pro, mặc dù khoảng cách với Opus 5 chắc chắn lớn hơn con số một điểm.
Tôi và Xianyu cũng đã chạy một vài bài kiểm tra. Về trực quan hóa dữ liệu và tài chính, Step 5 Preview cho thấy khả năng hiểu và truy xuất dữ liệu rất vững chắc.
Nhưng với các bài kiểm tra chuyên biệt — ví dụ như hiểu biết về thế giới vật lý — Step 5 Preview lại thể hiện không tốt. Kết luận: khả năng khái quát hóa / học trong ngữ cảnh (in-context learning) còn yếu, việc áp dụng và hiểu biết kiến thức chuyên ngành còn rời rạc. Các công cụ lạ thường bị sử dụng sai cách; nó không biết cách học những gì nó chưa biết.
Ngoài ra, quá trình suy luận của mô hình này chạy quá lâu, làm kéo dài thời gian hoàn thành các tác vụ mở rộng. Khi bạn kết hợp ngữ cảnh dài với việc suy luận lê thê, nó thường bị lỗi.
@kk đã thử nghiệm cụ thể độ dài suy luận của Step 5 Preview qua các tác vụ có độ khó khác nhau và nhận thấy rằng các tác vụ có ràng buộc khắt khe về độ dài đầu ra tạo ra các chuỗi suy luận dài bất thường — tỷ lệ giữa suy nghĩ và đầu ra thường đạt mức 1:1 hoặc cao hơn:
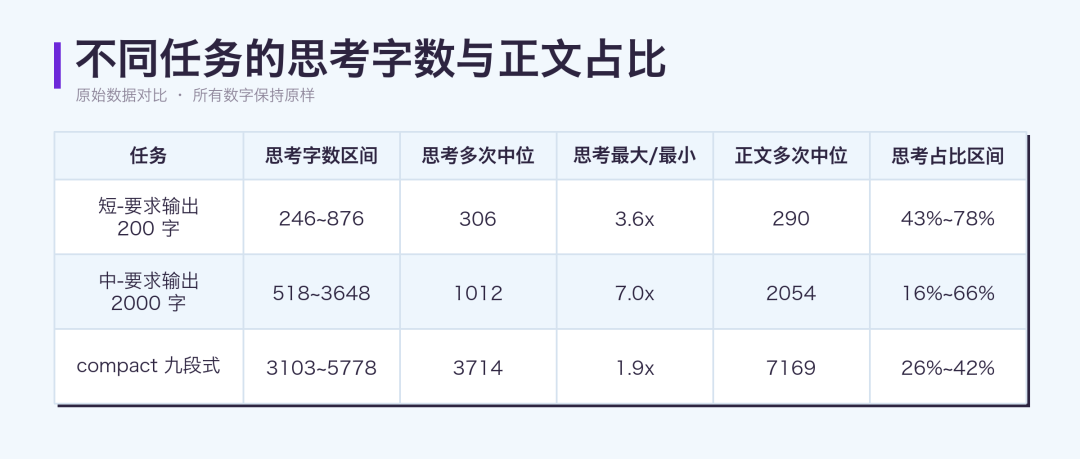
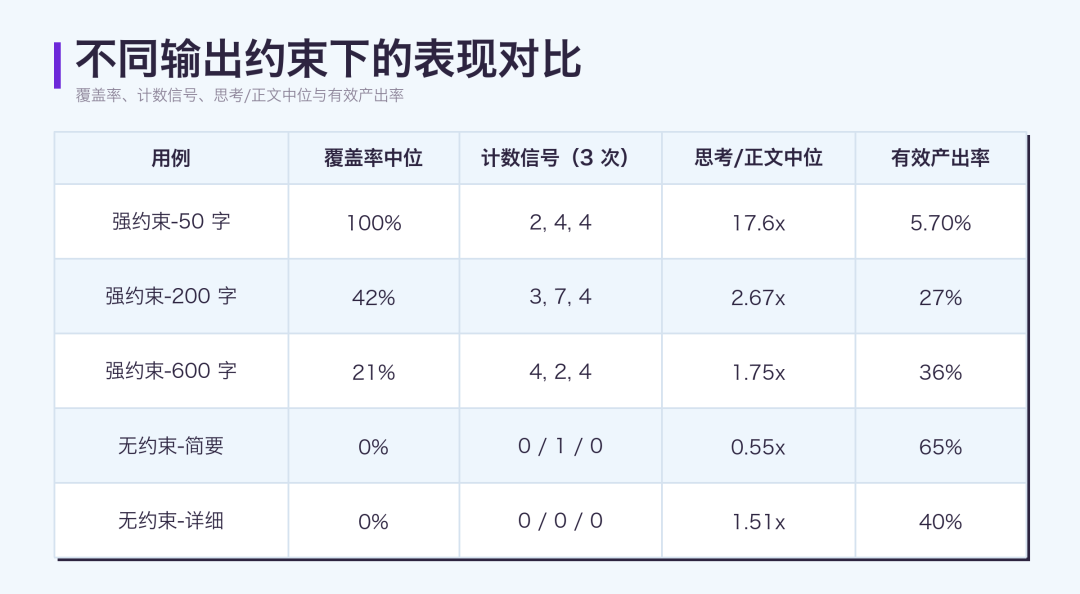
Các thử nghiệm sâu hơn cho thấy các ràng buộc ảnh hưởng đáng kể đến kết quả đầu ra cuối cùng, với mức phạt tăng lên khi các ràng buộc trở nên chặt chẽ hơn. Mô hình thường suy ngẫm một hoặc nhiều lần trong quá trình suy luận về việc liệu đầu ra dự kiến của nó có đáp ứng yêu cầu về độ dài hay không.
Gạt bỏ những vấn đề đó sang một bên, lần này StepFun đã thực sự phát hành một mô hình tối thiểu là đạt chuẩn và vượt trên kỳ vọng.
Dưới đây là kết quả thử nghiệm thực tế của @kk, sử dụng bộ công cụ Claude Code:
Trực quan hóa dữ liệu: Biểu đồ Sankey
Truy vấn: Vui lòng tạo một biểu đồ Sankey (biểu đồ phân rã dòng chảy sử dụng các dải có độ rộng thay đổi để đại diện cho dòng chảy và phân bổ số lượng) của báo cáo kết quả kinh doanh sử dụng báo cáo thu nhập gốc của NVIDIA trong Quý 2 năm tài chính 2026, bằng tiếng Trung.
Kết quả của Step 5 Preview:
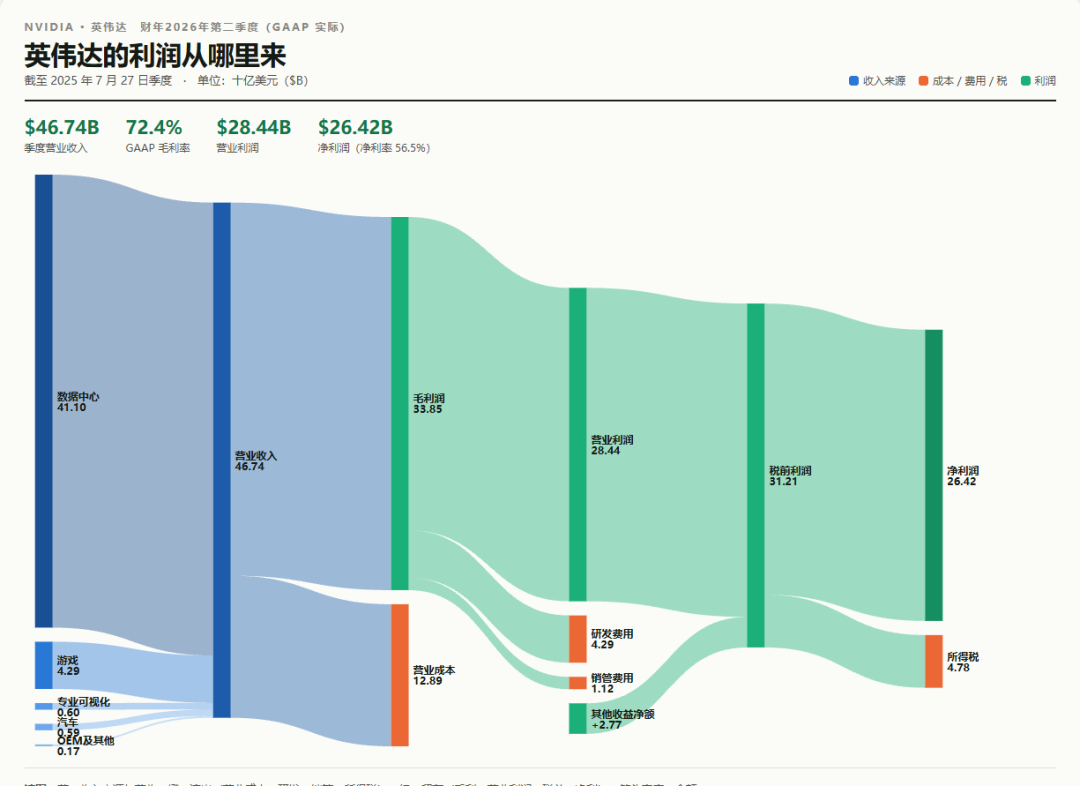
Tác vụ trực quan hóa này chủ yếu kiểm tra khả năng truy xuất dữ liệu, xử lý và trích xuất thông tin chính xác, và trực quan hóa dữ liệu cuối cùng.
Trong trường hợp này, việc truy xuất thông tin yêu cầu mô hình phải định vị được báo cáo thu nhập liên quan, trích xuất dữ liệu báo cáo kết quả kinh doanh từ tài liệu gốc, và dựa trên hiểu biết của chính nó về báo cáo thu nhập, phân tách thông tin thành doanh thu và giá vốn hàng bán theo phân khúc kinh doanh, chi phí, và sự liên kết của chúng với lợi nhuận cuối cùng — nói một cách đơn giản là làm cho các con số khớp nhau.
Khi sử dụng ECharts (một thư viện biểu đồ mã nguồn mở) để tạo biểu đồ Sankey, cần chú ý đến việc giảm thiểu sự chồng chéo của các phần tử, làm rõ mối quan hệ phân cấp và dòng chảy giữa các mục, cũng như lựa chọn màu sắc.
Để so sánh, tôi cũng đã yêu cầu GPT-6 tạo một phiên bản:
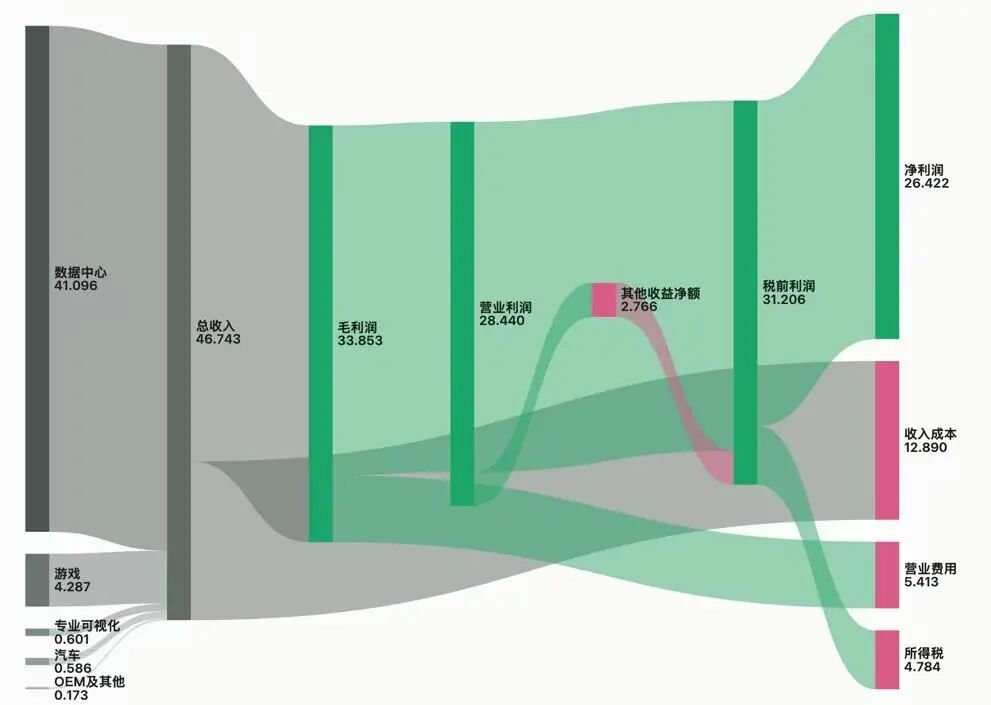
Như bạn có thể thấy, so với GPT-6, Step 5 Preview phân tách mọi thứ chi tiết hơn, liệt kê các danh mục chi phí khác nhau một cách cụ thể và tạo ra kết quả hình ảnh tốt hơn — với ít sự chồng chéo hơn giữa thu nhập ròng khác và lợi nhuận trước thuế chảy vào thuế thu nhập, tạo ra trải nghiệm xem mạch lạc và logic hơn.
Điều này cho thấy các mô hình nội địa có khả năng hiểu các yêu cầu kinh doanh tốt hơn và trình bày biểu đồ đẹp hơn. Những "nô lệ làm công ăn lương" bẩm sinh này thực sự được sinh ra để làm PowerPoint.
Phân tích tài chính toàn diện (End-to-End)
Truy vấn: Sử dụng https://github.com/Zacklinkk/trading_agent, hãy cung cấp cho tôi một phân tích đa chiều toàn diện về ngành công nghiệp AI của Trung Quốc.
Kết quả của Step 5 Preview:
Vì tác vụ này sử dụng một Skill (kỹ năng), nó chủ yếu kiểm tra khả năng tuân thủ hướng dẫn của mô hình đối với các Skill, khả năng truy xuất dữ liệu tài chính, khả năng kiểm chứng chéo và phân tích, cũng như trình bày báo cáo HTML cuối cùng.
Khi tìm kiếm thông tin, mô hình đã sử dụng cả các nguồn chính thống bao gồm Cục Thống kê Quốc gia Trung Quốc và Quốc vụ viện, cũng như các báo cáo tổ chức thứ cấp từ Discovery Reports và China Report Network, trước khi chuyển sang các trang web tài chính như Securities Times và Cailian Press.
Điều này cho thấy Step 5 Preview có khả năng truy xuất dữ liệu tài chính khá tốt — ngay cả khi không được cung cấp trước các nguồn cụ thể hoặc khóa liên quan, nó vẫn chủ động tìm kiếm các nguồn có thẩm quyền và kiểm chứng chéo.
Phát triển trò chơi Godot
Lời nhắc yêu cầu mô hình tạo một trò chơi nhỏ thu hút người dùng tương tự như Zombie Siege; nó quá dài để đưa vào đây.
Kết quả của Step 5 Preview:
Tác vụ này đã kiểm tra ba khả năng chính.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ elsewhere: Bài viết. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.