Nghiên cứu
UTF-8000: Giải pháp mã hóa mở rộng không giới hạn cho UTF-8
(giờ Việt Nam)
Tóm tắt AI
UTF-8000 là phương thức mã hóa mới cho phép biểu diễn các điểm mã (code point) có kích thước tùy ý bằng cách tối ưu hóa cấu trúc byte, đồng thời vẫn giữ nguyên khả năng tự đồng bộ và tương thích với ASCII của UTF-8 truyền thống.
Chính văn · Bản dịch AI
UTF-8 không giới hạn! ASCII ⊆ UTF-8 ⊆ UTF-8000.
Không có trường hợp đặc biệt nào được thêm vào. Mọi thuộc tính đều được bảo toàn.
Hãy thử nghiệm bản cài đặt tham chiếu với $ pipx install UTF-8000.
UTF-8000 không được xác nhận bởi hoặc đại diện cho Unicode Consortium dưới bất kỳ hình thức nào. Đây là một dự án/đề xuất độc lập mang tính giải trí.
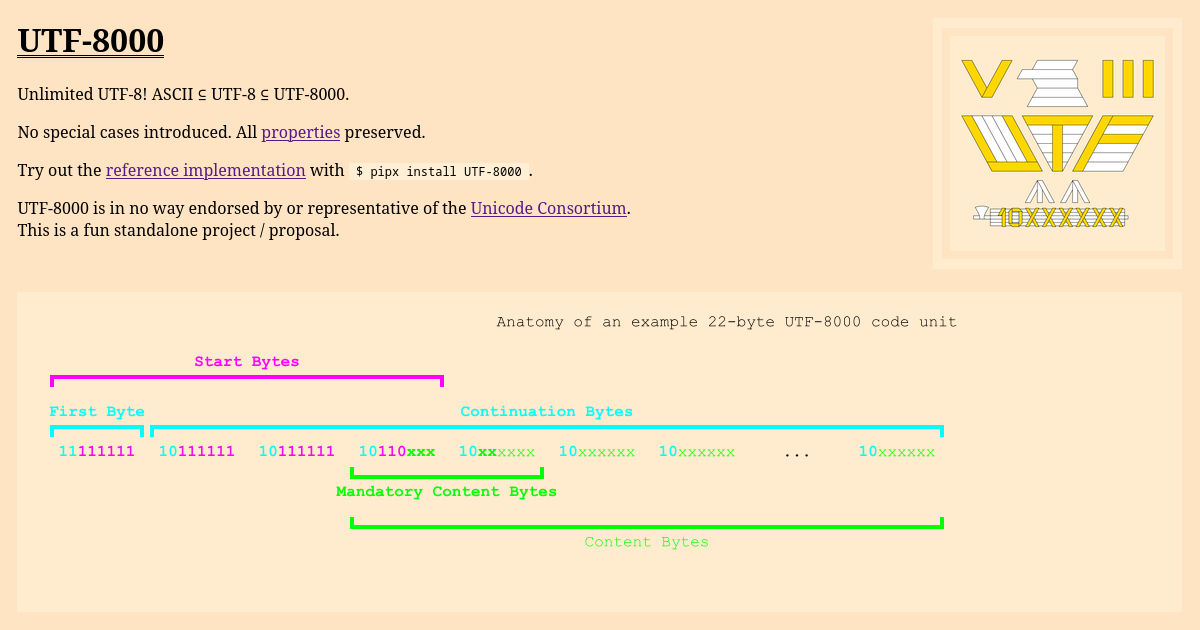
Không có gì là trường hợp đặc biệt về đơn vị mã 22-byte trong ví dụ này. Đây chỉ là một ví dụ nguyên mẫu điển hình, minh chứng cho sức mạnh của UTF-8000 với nhiều byte bắt đầu (start byte).
Chỉ có hai trường hợp đặc biệt, cả hai đều được kế thừa từ UTF-8: ASCII giữ nguyên, và UTF-8 2-byte có 4 bit nội dung bắt buộc để kiểm tra mã hóa quá dài (overlong encoding), trái ngược với 5 bit cho tất cả các đơn vị mã có độ dài lớn hơn.
Đây là sơ đồ giải phẫu của đơn vị mã 22-byte trong ví dụ từ phần tldr.
Xem bảng thuật ngữ để biết thêm thông tin về định nghĩa của các thuật ngữ.
Byte thứ tư rất thú vị! Nó vừa là byte tiếp nối (continuation byte), vừa là byte bắt đầu (start byte), là byte bắt đầu cuối cùng, chứa các bit nội dung, và chỉ có một số bit nội dung bắt buộc, vốn nằm rải rác giữa byte bắt đầu cuối cùng và byte không phải bắt đầu đầu tiên.
Đóng góp chính của đặc tả UTF-8000 là sự rõ ràng trong việc tách các bit cao nhất của byte đầu tiên trong các đơn vị mã UTF-8 thành các bit tự đồng bộ hóa (self-synchronization bits) và các bit bắt đầu (start bits), sau đó làm rõ cách phân bổ các bit bắt đầu trên các byte tiếp nối nếu cần, nhằm đạt được các đơn vị mã lớn tùy ý.
Các thuật ngữ này được sắp xếp theo trình tự thời gian xuất hiện yêu cầu đầu tiên, thay vì theo bảng chữ cái, để thuận tiện cho việc tra cứu.
Các thuật ngữ được sử dụng trong định nghĩa là các siêu liên kết có thể nhấp vào và được gạch chân.
Codepoint (Điểm mã)
Một số nguyên không âm, hay còn gọi là số nguyên không dấu.
Code Unit (Đơn vị mã)
Một chuỗi các byte UTF-8000 mã hóa cho một codepoint duy nhất.
First Byte (Byte đầu tiên)
Byte đầu tiên, duy nhất, bắt đầu một đơn vị mã UTF-8000.
Tiền tố tự đồng bộ hóa của một byte đầu tiên là 0 đối với ASCII hoặc 11 đối với các đơn vị mã đa byte.
Thuật ngữ này không đồng nghĩa với start byte. Một first byte chắc chắn là một start byte, nhưng ngược lại thì không. Chính vì lý do này mà first byte đôi khi còn được gọi là first start byte.
Quan sát thú vị: do tiền tố tự đồng bộ hóa là 0, nên nibble hex phía trên của các byte ASCII chỉ có thể là 0, 1, 2, 3, 4, 5, 6, 7.
Thuật ngữ này loại trừ lẫn nhau với continuation byte do tính tự đồng bộ hóa.
Continuation Byte (Byte tiếp nối)
Một byte nằm sau byte đầu tiên của một đơn vị mã UTF-8000 đa byte.
Tiền tố tự đồng bộ hóa của một continuation byte là 10, còn được gọi là các bit tiền tố tiếp nối.
Quan sát thú vị: do tiền tố tự đồng bộ hóa là 10, nên nibble hex phía trên của các continuation byte chỉ có thể là 8, 9, A, B.
Thuật ngữ này loại trừ lẫn nhau với first byte do tính tự đồng bộ hóa.
Self-Synchronization Prefix (Tiền tố tự đồng bộ hóa)
Các bit cao nhất của mọi byte UTF-8000 cho biết đó là first byte hay continuation byte.
Các tiền tố tự đồng bộ hóa khả thi tạo thành một cây không chứa tiền tố (prefix-free tree):
Phần kiến trúc thông minh này của UTF-8, mà UTF-8000 kế thừa, cung cấp thuộc tính tự đồng bộ hóa ở cấp độ byte: chúng ta có thể nhận biết ngay lập tức loại byte mà mình đang xem xét, và vị trí của nó trong một đơn vị mã, chỉ bằng cách nhìn vào các bit cao nhất này.
Điều này hữu ích nhất khi giải mã một phần của tệp được mã hóa bằng UTF-8000. Nếu chúng ta tìm kiếm ngẫu nhiên trong tệp đến một byte bất kỳ, chúng ta có thể xác định rõ ràng liệu mình đang ở first byte để bắt đầu giải mã một đơn vị mã mới ngay lập tức, hay đang ở continuation byte để cần tìm kiếm thêm một chút nhằm tìm ra first byte tiếp theo. Chúng ta cũng không cần phải xử lý bất kỳ byte nào trước vị trí tìm kiếm để khám phá trạng thái toàn cục hoặc ngữ cảnh của byte mà chúng ta đã tìm đến; một first byte luôn là first byte một cách rõ ràng ở bất cứ nơi nào nó xuất hiện, điều mà chúng ta có thể suy ra từ tiền tố tự đồng bộ hóa của nó là 0 hoặc 11.
Điều này không chỉ hữu ích cho việc truy cập ngẫu nhiên mà còn cho việc khôi phục lỗi. Giả sử chúng ta đang giải mã một luồng byte UTF-8000 dễ xảy ra lỗi và bất cứ khi nào gặp lỗi (ví dụ: byte 0xC0 lạ), chúng ta muốn giữ bình tĩnh và tiếp tục thay vì thoát ngay lập tức. Chúng ta có thể xuất ra các ký tự thay thế Unicode U+FFFD và sau đó chờ đợi first byte tiếp theo, loại bỏ mọi thứ ở giữa.
Xem bài viết trên Wikipedia về mã tự đồng bộ hóa (self-synchronizing code) để biết thêm thông tin chung.
Các bit này được làm nổi bật bằng màu lục lam sáng.
Start Byte (Byte bắt đầu)
Một byte chứa một hoặc nhiều bit bắt đầu (start bits). Các start byte tồn tại liên tục ở phần đầu của một đơn vị mã UTF-8000. Sức mạnh của UTF-8000 là chúng ta có thể có nhiều start byte để đạt được độ dài đơn vị mã tùy ý, nhằm mã hóa các codepoint lớn tùy ý.
Đôi khi, việc gọi ASCII là một start byte trong giao tiếp thông thường cũng hợp lý khi chúng ta đang nói về các byte hướng tới phần đầu của một đơn vị mã, mặc dù các byte ASCII không có bit bắt đầu nào.
Mọi đơn vị mã không phải ASCII đều có ít nhất một start byte. Start byte đầu tiên chính là first byte, và theo sau nó là không hoặc nhiều continuation byte cũng là các start byte. Do đó, vì một đơn vị mã UTF-8000 có thể có nhiều start byte, thuật ngữ này không đồng nghĩa với first byte.
Bài viết được AI dịch và tổng hợp tự động từ Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung). Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.