Ngành
GitHub công bố báo cáo khả dụng tháng 8/2026: Nhìn lại các sự cố lớn và tiến độ chuyển đổi sang Azure
(giờ Việt Nam)
Tóm tắt AI
GitHub vừa phát hành báo cáo chi tiết về 5 sự cố kỹ thuật trong tháng 8/2026, ảnh hưởng đến các dịch vụ như Actions, Issues và Copilot, đồng thời cập nhật tiến độ chuyển đổi hạ tầng lên Azure.
Chính văn · Bản dịch AI

Trong tháng 8, chúng tôi đã trải qua năm sự cố dẫn đến hiệu suất bị suy giảm trên các dịch vụ của GitHub.
Ngày 9 tháng 9 năm 2026
16 phút
Mặc dù chúng tôi vẫn đang tiếp tục đạt được những tiến bộ, tháng 8 là một tháng đầy thách thức về tính khả dụng. Bạn có thể đọc thêm về các sự cố này trong bài viết trên blog mà chúng tôi đã đăng vào tháng trước. Chúng tôi đang tích cực đầu tư vào cả việc cải thiện kiến trúc lẫn chuyển đổi sang Azure, điều này sẽ mang lại cho chúng tôi nhiều năng lực xử lý hơn. Trong khi đó, nền tảng của chúng tôi vẫn tiếp tục tăng trưởng đáng kể. Chúng tôi đang ưu tiên các công việc có tác động lớn nhất trong khi vẫn giảm thiểu rủi ro, nhưng như các sự cố trong tháng 8 cho thấy, chúng tôi không thể loại bỏ hoàn toàn rủi ro.
Suy cho cùng, mọi công việc đều cần phải được thực hiện và các sự cố mang đến cho chúng tôi cơ hội để điều chỉnh các ưu tiên. Với tư cách là các hạng mục khắc phục từ những sự cố này, chúng tôi đã thực hiện những cải tiến đáng kể đối với việc giám sát và quản lý năng lực, các chính sách thử lại (retry policies) vốn gây ra tác động lớn hơn, và cải thiện khả năng phục hồi cho các dịch vụ cốt lõi. Chúng tôi cũng tiếp tục đạt được những tiến bộ vượt bậc trong nhiều luồng công việc bền vững.
Vào ngày 11 tháng 8, GitHub đã vận hành một MySQL primary trong môi trường production từ Azure lần đầu tiên. Tác động ghi nhận được từ phía khách hàng là tối thiểu và không có ảnh hưởng nào đến khách hàng trong quá trình chuyển đổi. Chúng tôi đã lặp lại mô hình này với hai primary nữa vào ngày 27 tháng 8. Chúng tôi đã lên lịch cho các primary tiếp theo trong những tuần tới, với độ phức tạp tăng dần khi chúng tôi rút kinh nghiệm từ mỗi lần chuyển đổi dự phòng (failover).
Lưu lượng đọc cũng đạt mức cao mới. Các lượt đọc từ các dịch vụ đã di chuyển đạt đỉnh 60,4%, trong khi các lượt đọc từ monolith của GitHub đạt đỉnh 64,3% trên Azure. Lượt đọc Git đạt 54%.
Ngoài việc di chuyển theo khu vực, nhóm 24 bảng authentication-core đã được chuyển khỏi cơ sở dữ liệu chia sẻ lâu đời nhất của GitHub là mysql1, giúp loại bỏ khoảng một triệu truy vấn mỗi giây khỏi các bản sao (replicas) của nó. Các thay đổi riêng biệt về vệ sinh truy vấn (query-hygiene) đã loại bỏ thêm 120.000 truy vấn mỗi giây và loại bỏ khoảng 59.000 giây công việc cơ sở dữ liệu lãng phí mỗi giờ.
GitHub Actions đã có thêm năng lực xử lý trong khi công việc cô lập dài hạn vẫn tiếp tục. Các thay đổi về định tuyến công việc (job-routing) đã chuyển 33% công việc từ một cụm production bị hạn chế sang năng lực dự phòng, giúp giảm mức sử dụng CPU bộ nhớ đệm cao điểm từ 98% xuống 80% và bổ sung thêm khoảng ba tháng dư địa hoạt động. Đây là biện pháp ngăn chặn trong ngắn hạn, không phải là đích đến cuối cùng; sự cố tháng 8 đã củng cố nhu cầu về năng lực và sự cô lập bền vững hơn, vốn vẫn đang được tiếp tục.
Công việc cô lập pull request vẫn tiếp tục. Ngoài lưu lượng truy cập không xác thực đã được phục vụ, giờ đây các lượt đọc đã xác thực cho nhóm production đầu tiên đã đạt 100%.
Các khoản đầu tư vào bảo vệ quá tải Git đã phục vụ thêm 6,4% lưu lượng truy cập, đồng thời cải thiện thời gian phản hồi ở phân vị thứ 95 thêm 24% và độ trễ tối đa thêm 78%. Các biện pháp bảo vệ giảm tải rộng hơn tại biên cũng đạt được tiến bộ, cho phép các đòn bẩy có thể bảo vệ GitHub dưới tải trọng bất ngờ—thực tế, các biện pháp bảo vệ này đã được sử dụng để giảm thiểu các sự cố nêu trên trong tháng 8.
Chúng tôi cũng đã cải thiện việc giám sát và đo lường từ xa (telemetry). Việc giám sát pull request hiện đo lường các lỗi hợp nhất, đánh giá và bình luận một cách độc lập, nơi mà khối lượng đọc cao có thể che giấu một đường dẫn ghi bị lỗi. Vào ngày 21 tháng 8, tính năng phát hiện sự cố tác động cao tự động đã bắt đầu kết hợp các tín hiệu hỗ trợ khách hàng với dữ liệu đo lường từ xa của dịch vụ. Việc giám sát API cũng được hiệu chỉnh lại và xác thực trong 30 ngày, giúp giảm nhiễu và cải thiện chất lượng tín hiệu. Những thay đổi này giúp cải thiện khả năng phát hiện và phản hồi.
Tháng làm việc tiếp theo bao gồm việc di chuyển các database primary tiếp theo, tiếp tục di chuyển các dịch vụ và lưu lượng truy cập tương ứng sang Azure, cải thiện dần sức khỏe cơ sở dữ liệu đặc biệt là trên các cơ sở dữ liệu chia sẻ, bổ sung thêm tự động hóa xung quanh việc quản lý năng lực và tự động mở rộng (auto-scaling), cũng như mở rộng khả năng xử lý lỗi phụ thuộc trên nhiều phần hơn của trải nghiệm pull request.
Nguyên tắc này tiếp tục dẫn dắt chúng tôi: tính khả dụng, sau đó là năng lực, rồi mới đến các tính năng.
Ngày 06 tháng 8 lúc 15:22 UTC (kéo dài 10 giờ 42 phút)
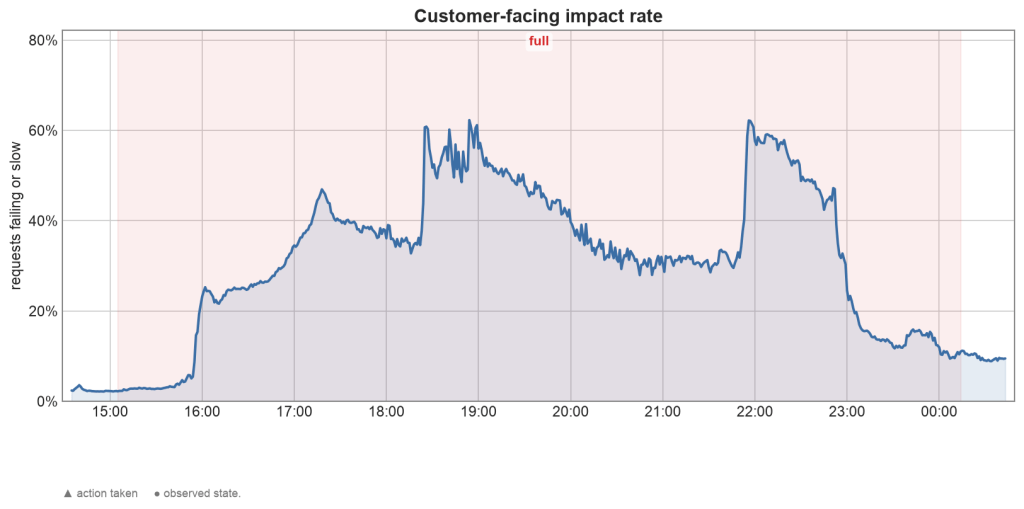
Chuyện gì đã xảy ra?
Sự cố bắt đầu với một đợt triển khai định kỳ vào một dịch vụ GitHub Actions nội bộ, dịch vụ này xử lý các sự kiện đến và biến chúng thành các công việc (jobs) hành động. Nội dung của đợt triển khai không phải là nguyên nhân (chúng tôi đã hoàn tác để xác nhận điều này); thay vào đó, việc thay thế các pod trong quá trình triển khai đã làm giảm năng lực trong giây lát tại một site và đẩy các site còn lại vượt quá giới hạn khi lưu lượng truy cập chuyển sang chúng. Tác động nặng nề nhất là trong những giờ giữa của sự cố, khi một phần lớn các lượt chạy quy trình làm việc (workflow runs) của actions không thể bắt đầu hoặc hoàn thành.
Điều gì đã sai và tại sao?
Các dịch vụ actions bị ảnh hưởng đang chạy gần với giới hạn năng lực và đồng thời của chúng. Một đợt triển khai định kỳ làm giảm số lượng pod đang chạy trong giây lát là đủ để làm cạn kiệt dư địa sẵn có. Điều này khiến các sidecar của service mesh gặp phải tình trạng điều tiết CPU và khởi động lại do hết bộ nhớ, sau đó dẫn đến lỗi bộ nhớ đệm, DNS và API trên nhiều cụm. Service mesh đầu vào cho các dịch vụ này có dư địa hạn chế nên không thể hấp thụ sự mất mát năng lực tạm thời trong quá trình triển khai.
Khi các dịch vụ cốt lõi phục hồi, một lỗi tiềm ẩn trong đường dẫn gán công việc đã làm cho quá trình phục hồi chậm hơn: các runner được giao những công việc đã bị thu hồi, sau đó bị kẹt trong việc thử lại chúng thay vì nhận công việc hợp lệ, điều này tạo ra một lượng tồn đọng tự khuếch đại.
Ngày 17 tháng 8 lúc 13:40 UTC (kéo dài 7 giờ 35 phút)
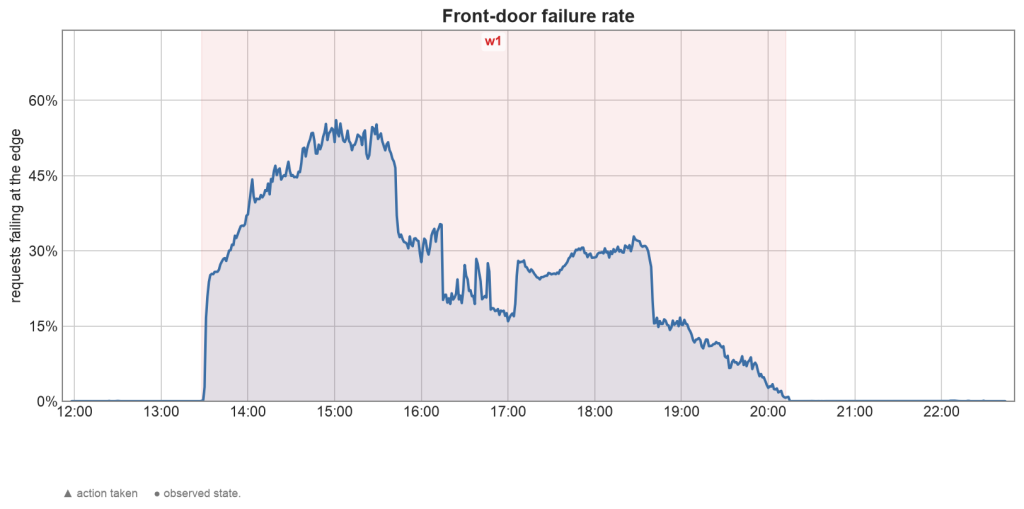
Điều gì đã sai và tại sao?
Một đỉnh lưu lượng truy cập mới đã đẩy các bộ cân bằng tải của một trung tâm dữ liệu vượt quá giới hạn của chúng. Một sidecar của service-mesh đã đạt đến giới hạn đồng thời và không tự động mở rộng.
Khi các yêu cầu bị dồn ứ, một số nút cân bằng tải của trung tâm dữ liệu đã cạn kiệt giới hạn lưu lượng mạng, làm suy giảm đường dẫn xác thực cổng chia sẻ và gây ra độ trễ cũng như lỗi xác thực trên diện rộng ở nhiều dịch vụ định tuyến qua trung tâm dữ liệu đó.
Một lỗi thử lại từ phía client tiềm ẩn đã khuếch đại mạnh lưu lượng truy cập đến một điểm cuối xác thực nội bộ, làm chậm quá trình phục hồi cho Copilot Token Service. Điểm yếu cốt lõi là sidecar service-mesh của chúng tôi không tự động mở rộng, cùng với hành vi thử lại của chúng tôi, và các client không bị giới hạn đủ chặt để ngăn chặn sự suy giảm cục bộ khuếch đại thành tình trạng quá tải rộng hơn.
Ngày 20 tháng 8 lúc 14:43 UTC (kéo dài 9 giờ 54 phút)
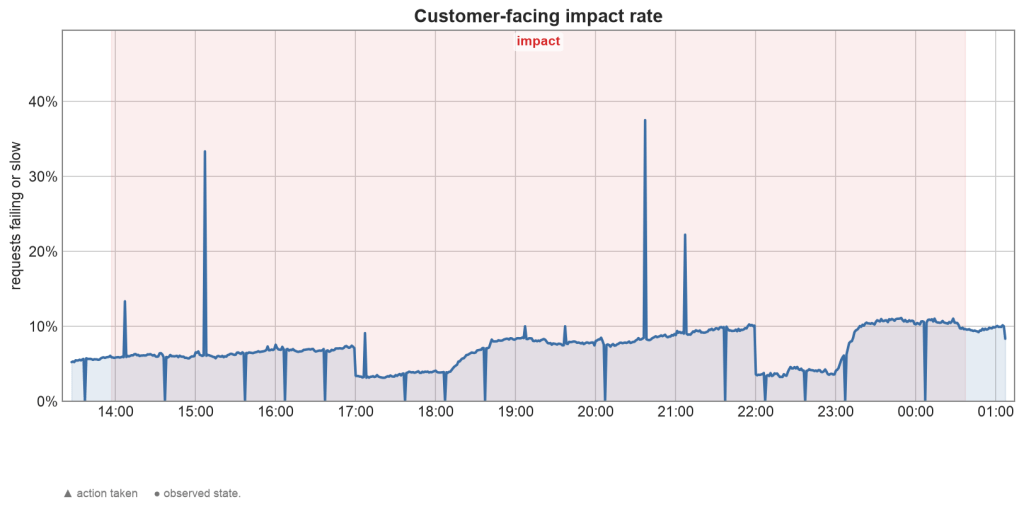
Chuyện gì đã xảy ra?
Trong khoảng thời gian xảy ra sự cố, tác vụ Copilot cloud agent đã bị ảnh hưởng. Bản thân các tác vụ vẫn chạy đến khi hoàn thành, vì vậy không có công việc nào bị mất. Khi quá trình xử lý bắt kịp, trạng thái và kết quả chính xác đã xuất hiện. Chờ đợi một thời gian ngắn hoặc kiểm tra lại sau đó một chút sẽ thấy trạng thái cập nhật.
Trong suốt sự cố, ít nhất 54 tổ chức đã gặp phải tình trạng trạng thái và kết quả tác vụ Copilot Cloud Agent bị trễ cao hơn nhiều so với mức bình thường của họ. Tác động đối với khách hàng theo từng phút đạt đỉnh ở mức 37,5% hoạt động trạng thái tác vụ được đo lường.
Điều gì đã sai và tại sao?
Copilot cloud agent lưu trữ trạng thái và kết quả của từng tác vụ agent trong một cơ sở dữ liệu đám mây được quản lý. Một khu vực của cơ sở dữ liệu đó đã gặp sự cố từ phía nhà cung cấp, và các lệnh gọi đọc và ghi trạng thái tác vụ trong khu vực bị ảnh hưởng bắt đầu thất bại và chạy chậm.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ GitHub Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.