Nghiên cứu
Xiaomi MiMo-V2.6: Khắc phục lỗi lặp lại lệnh gọi công cụ với chi phí tối ưu nhờ MOPD
(giờ Việt Nam)
Tóm tắt AI
Xiaomi phân tích lỗi lặp lại lệnh gọi công cụ trên MiMo-V2.6 và giới thiệu phương pháp MOPD, giúp giảm chi phí khắc phục xuống chỉ còn 4% so với giải pháp MixRL truyền thống.
Chính văn · Bản dịch AI
27 tháng 9, 2026
Bài học từ việc mở rộng RL: điểm mù về phần thưởng trong tối ưu hóa tính chính xác
Hugging Face ›Báo cáo kỹ thuật ›Tiếng Trung ›
Sau khi phát hành MiMo-V2.6, tình trạng lặp lại lệnh gọi công cụ (tool-call) đã trở thành một trong những vấn đề đáng chú ý nhất ảnh hưởng đến trải nghiệm người dùng. Trong MiMo Desktop, MiMo Code, OpenCode và các môi trường tác nhân (agentic settings) khác, mô hình đôi khi đưa ra các lệnh gọi công cụ giống hệt hoặc rất tương đồng nhau một cách lặp đi lặp lại, gây lãng phí đáng kể thời gian và ngữ cảnh mà không đạt được tiến triển có ý nghĩa.
Các đánh giá nội bộ của chúng tôi xác nhận mô hình này: tỷ lệ lặp lại ở cấp độ phản hồi vượt quá 0,05%. Bảng dưới đây phân tích tỷ lệ này cho MiMo-V2.6-Flash-RL và MiMo-V2.6-Pro-RL trên các bộ khung tác nhân (agent harnesses) khác nhau.
Tỷ lệ lặp lại lệnh gọi công cụ của MiMo-V2.6-Flash-RL và MiMo-V2.6-Pro-RL trên các bộ khung tác nhân
| Bộ khung | MiMo-V2.6-Flash-RL | MiMo-V2.6-Pro-RL |
|---|---|---|
| OpenCode | 1.02% | 0.54% |
| MiMo Desktop | 0.19% | 0.19% |
| Claude Code | 0.27% | 0.10% |
| OpenClaw | 0.17% | 0.08% |
| Codex | 0.23% | 0.07% |
| MiMo Code | 0.11% | 0.07% |
| DeepSeek Harness | 0.17% | 0.07% |
| Hermes | 0.16% | 0.05% |
| Zcode | 0.07% | 0.05% |
Truy tìm nguồn gốc của việc lặp lại lệnh gọi công cụ
Để hiểu vấn đề, trước tiên chúng ta cần phân biệt giữa gọi công cụ song song thông thường, tràn lệnh gọi công cụ (tool-call flooding) và lặp lại lệnh gọi công cụ.
Gọi công cụ song song là cách tiêu chuẩn để cải thiện hiệu suất tác nhân. Ví dụ, một tác nhân có thể đọc nhiều tệp liên quan cùng lúc hoặc chạy nhiều truy vấn độc lập song song. Ngay cả các lệnh gọi đến cùng một công cụ cũng không bị coi là lặp lại nếu chúng phục vụ các nhu cầu thông tin khác nhau. Tràn lệnh gọi công cụ xảy ra khi mô hình đưa ra số lượng lệnh gọi nhiều hơn đáng kể so với yêu cầu của tác vụ hoặc khả năng xử lý hiệu quả của môi trường thực thi, tạo ra các hàng đợi thực thi và tồn đọng các kết quả công cụ đang chờ xử lý.
Ngược lại, lặp lại lệnh gọi công cụ đề cập đến các hành động lặp đi lặp lại mà không có lý do chính đáng. Mô hình tiếp tục tạo ra các lệnh gọi giống hệt hoặc rất tương đồng về mặt ngữ nghĩa mặc dù thông tin sẵn có và trạng thái môi trường không thay đổi đáng kể, và không có lý do hợp lệ nào để thử lại hoặc xác minh kết quả. Điều này có thể xảy ra trong một phản hồi duy nhất, giữa các lượt sau khi có phản hồi từ công cụ, hoặc như một vòng lặp qua cùng một chuỗi thao tác. Việc thử lại hợp lý sau khi thất bại, thăm dò trạng thái cần thiết và chạy lại các bài kiểm tra sau khi sửa đổi mã không được tính là lặp lại ở đây.
Tràn lệnh và lặp lại có thể xảy ra độc lập, nhưng chúng cũng có thể củng cố lẫn nhau. Một mô hình có thể đưa ra nhiều lệnh gọi trùng lặp trong một phản hồi và tiếp tục hành vi tương tự trong các lượt sau, làm trầm trọng thêm sự lãng phí tính toán và sử dụng ngữ cảnh trong khi tiến triển rất ít. Từ góc độ người dùng, các công cụ liên tục chạy nhưng tác nhân bị đình trệ, dẫn đến thời gian chờ đợi lâu hơn, trải nghiệm không phản hồi hoặc thậm chí là thất bại tác vụ.
Mô tả trên định nghĩa sự lặp lại dựa trên hành vi. Vì sự tương đương về ngữ nghĩa rất khó phát hiện một cách đáng tin cậy trên quy mô lớn, chúng tôi sử dụng một thước đo hẹp hơn nhưng có thể tái lập trong bài viết này: lặp lại chính xác trong cùng một lượt (exact within-turn repetition). Chúng tôi coi tập hợp các lệnh gọi được phát ra trong một lượt của trợ lý trước khi có bất kỳ phản hồi công cụ nào là một đơn vị duy nhất. Hai lệnh gọi được coi là trùng lặp khi chúng gọi cùng một công cụ và các đối số của chúng giống hệt nhau sau khi chuẩn hóa JSON. Nếu một lượt chứa N lệnh gọi và U lệnh gọi duy nhất, tỷ lệ lặp lại chính xác trong lượt là:
(N − U) / N
Thước đo này có hai ưu điểm. Thứ nhất, vì không có phản hồi công cụ nào đến giữa các lệnh gọi trong cùng một lượt, các trùng lặp thường không thể được giải thích là do thử lại dựa trên kết quả. Thứ hai, đánh giá có thể được phát lại và tái lập trực tiếp từ một lượt duy nhất. Tuy nhiên, đây chỉ là giới hạn dưới của sự lặp lại có thể quan sát được, không phải là tỷ lệ lặp lại hoàn chỉnh hay thước đo của sự tràn lệnh. Nó loại trừ ba trường hợp quan trọng: lặp lại giữa các lượt sau khi có phản hồi công cụ; các lệnh gọi gần như trùng lặp có đối số khác biệt nhỏ dù phục vụ cùng một nhu cầu thông tin; và các lệnh gọi được thực hiện bên trong các bộ khung chế độ mã (code-mode harnesses), nơi mô hình chỉ hiển thị một lệnh gọi exec trong khi các lệnh gọi công cụ cơ bản vẫn được nhúng trong tập lệnh của nó.
Để xác định thời điểm vấn đề xuất hiện, chúng tôi đã phát lại một tập hợp cố định các ví dụ nội bộ từng thể hiện sự lặp lại đối với các điểm kiểm tra (checkpoints) từ các giai đoạn huấn luyện RL khác nhau (bước 0, 5, 10, 15 và 20). Việc đánh giá cùng các ví dụ tại mỗi điểm kiểm tra cho phép chúng tôi theo dõi hành vi đã phát triển như thế nào trong quá trình huấn luyện.
Đối với MiMo-V2.6-Flash-RL, tỷ lệ các ví dụ được phát lại vẫn thể hiện sự tràn lệnh (hơn mười lệnh gọi công cụ trong một lượt) đã là 11,1% ở bước RL 0, và tỷ lệ này tăng lên 24,6% vào bước 20. Xu hướng này đặc biệt rõ rệt trong MiMo Code, nơi tỷ lệ tràn lệnh đã là 30,6% ngay từ đầu và tăng lên 41,7% vào giai đoạn sau của quá trình huấn luyện.
| Bước RL | Tỷ lệ ví dụ được phát lại có ≥10 lệnh gọi công cụ trong một lượt | |||||
|---|---|---|---|---|---|---|
| MiMo Desktop | MiMo Code | OpenCode | Codex | Claude Code | Tất cả các bộ khung | |
| 0 | 11.1% | 30.6% | 5.6% | 5.6% | 8.3% | 11.1% |
| 5 | 16.7% | 22.2% | 0% | 5.6% | 8.3% | 8.7% |
| 10 | 25.0% | 44.4% | 0% | 11.1% | 5.6% | 16.7% |
| 15 | 33.3% | 38.9% | 25.0% | 8.3% | 2.8% | 22.5% |
| 20 | 33.3% | 41.7% | 27.8% | 16.7% | 5.6% | 24.6% |
Sự gia tăng này xảy ra bất chấp hình phạt tràn lệnh gọi công cụ đã tồn tại trong quy trình RL của chúng tôi. Trong quá trình triển khai (rollout), nếu mô hình đưa ra hơn 32 lệnh gọi công cụ trong một lượt, chúng tôi sẽ dừng sớm quá trình triển khai và đặt phần thưởng của nó về 0. Trong quá trình cập nhật gradient tiếp theo, các lượt trước đó bị che đi và hình phạt chỉ được áp dụng cho lượt kích hoạt quy tắc. Mọi token trong lượt đó, bao gồm cả các token chuỗi suy nghĩ (chain-of-thought), đều bị tính vào hình phạt.
Sau đó, chúng tôi kiểm tra các chỉ số huấn luyện tương ứng. Mô hình hầu như không bao giờ kích hoạt hình phạt tràn lệnh vào giai đoạn đầu huấn luyện. Tuy nhiên, bắt đầu từ khoảng bước 15, số lượng ví dụ có hơn 32 lệnh gọi công cụ trong một lượt bắt đầu tăng đáng kể và tiếp tục tăng khi quá trình huấn luyện tiến triển.
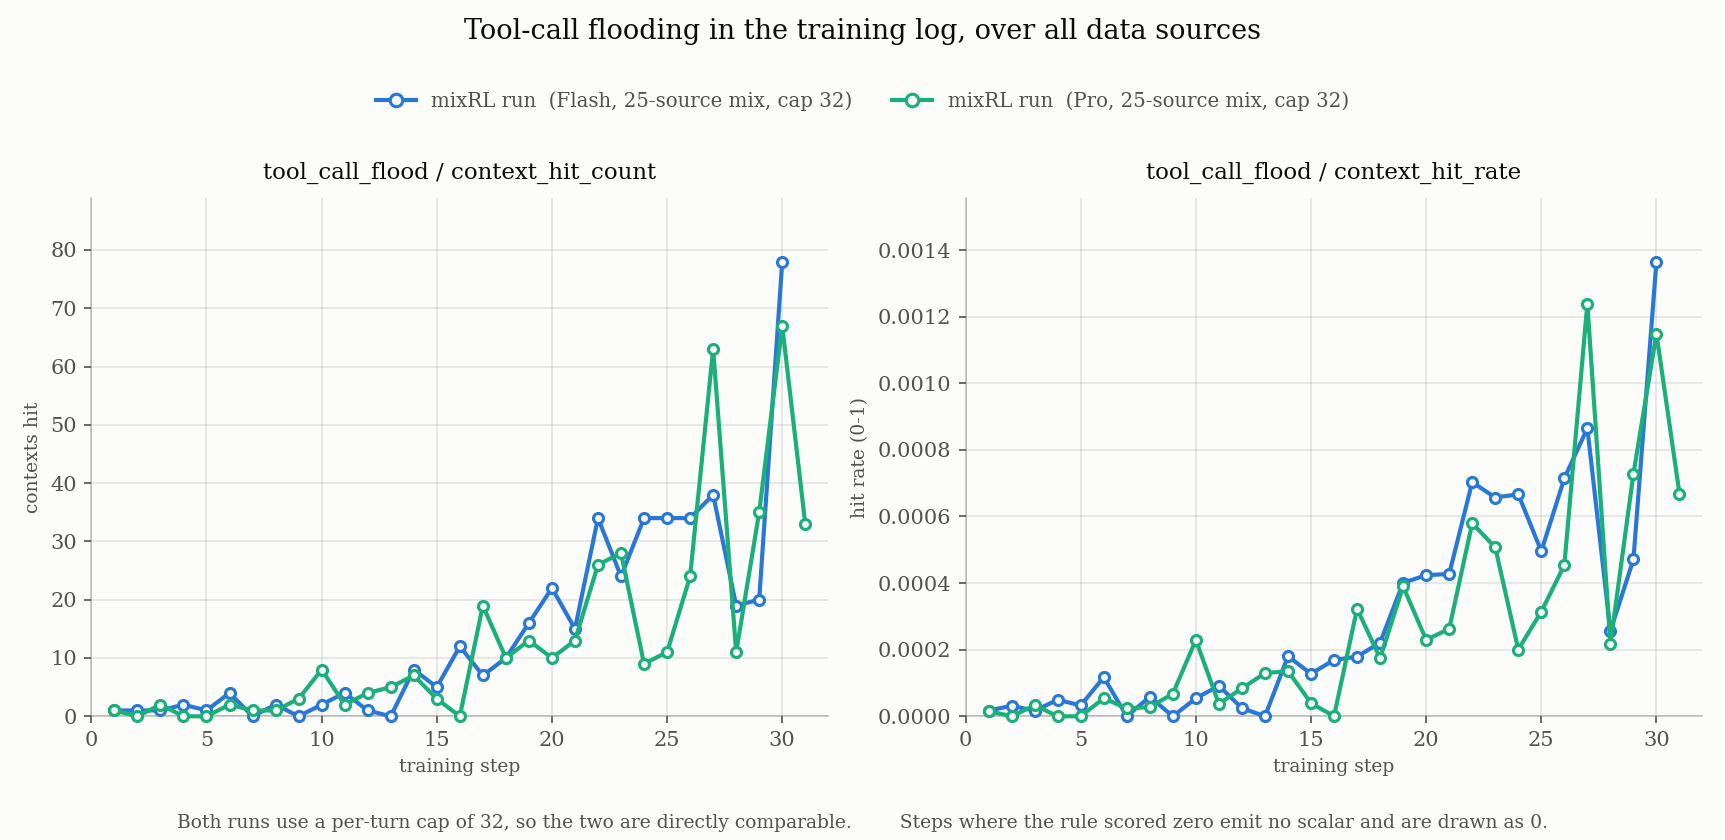
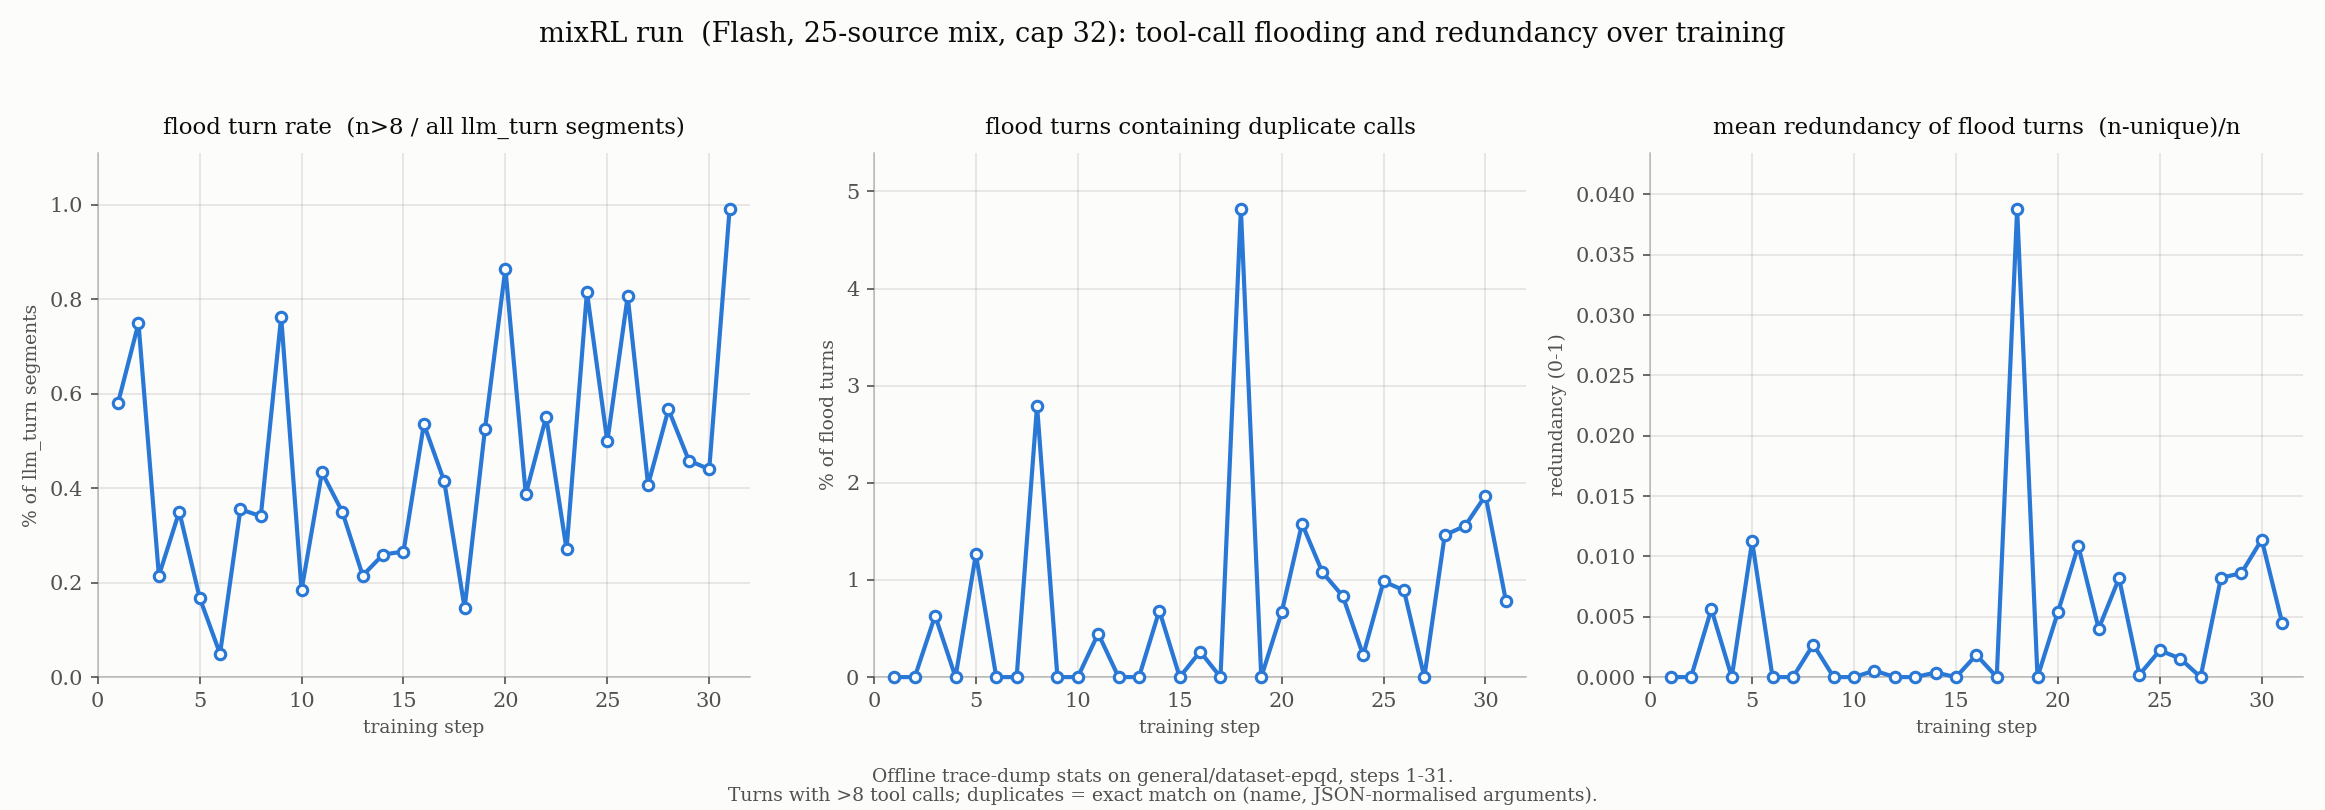
Phân tích sâu hơn cho thấy ngưỡng này quá dễ dãi. Sử dụng các dấu vết huấn luyện (training traces) của MiMo-V2.6-Flash từ nguồn dữ liệu general/dataset-epqd, chúng tôi đã đo lường tỷ lệ các ví dụ chứa hơn tám lệnh gọi công cụ trong một lượt. Một phần nhỏ đã cho thấy việc gọi công cụ khối lượng lớn ở bước RL 0. Vì hành vi dưới ngưỡng 32 không bị phạt, nó dần dần được khuếch đại trong quá trình huấn luyện và cuối cùng phát triển thành tình trạng tràn lệnh nghiêm trọng vượt ngưỡng. Một số dấu vết tràn lệnh cũng chứa các lệnh gọi lặp lại hoặc rất tương đồng, nhưng phân tích của chúng tôi ở đây tập trung vào khối lượng lệnh gọi bất thường và không đánh đồng việc tràn lệnh với sự lặp lại.
Một giải pháp tốn kém với khả năng tổng quát hóa hạn chế
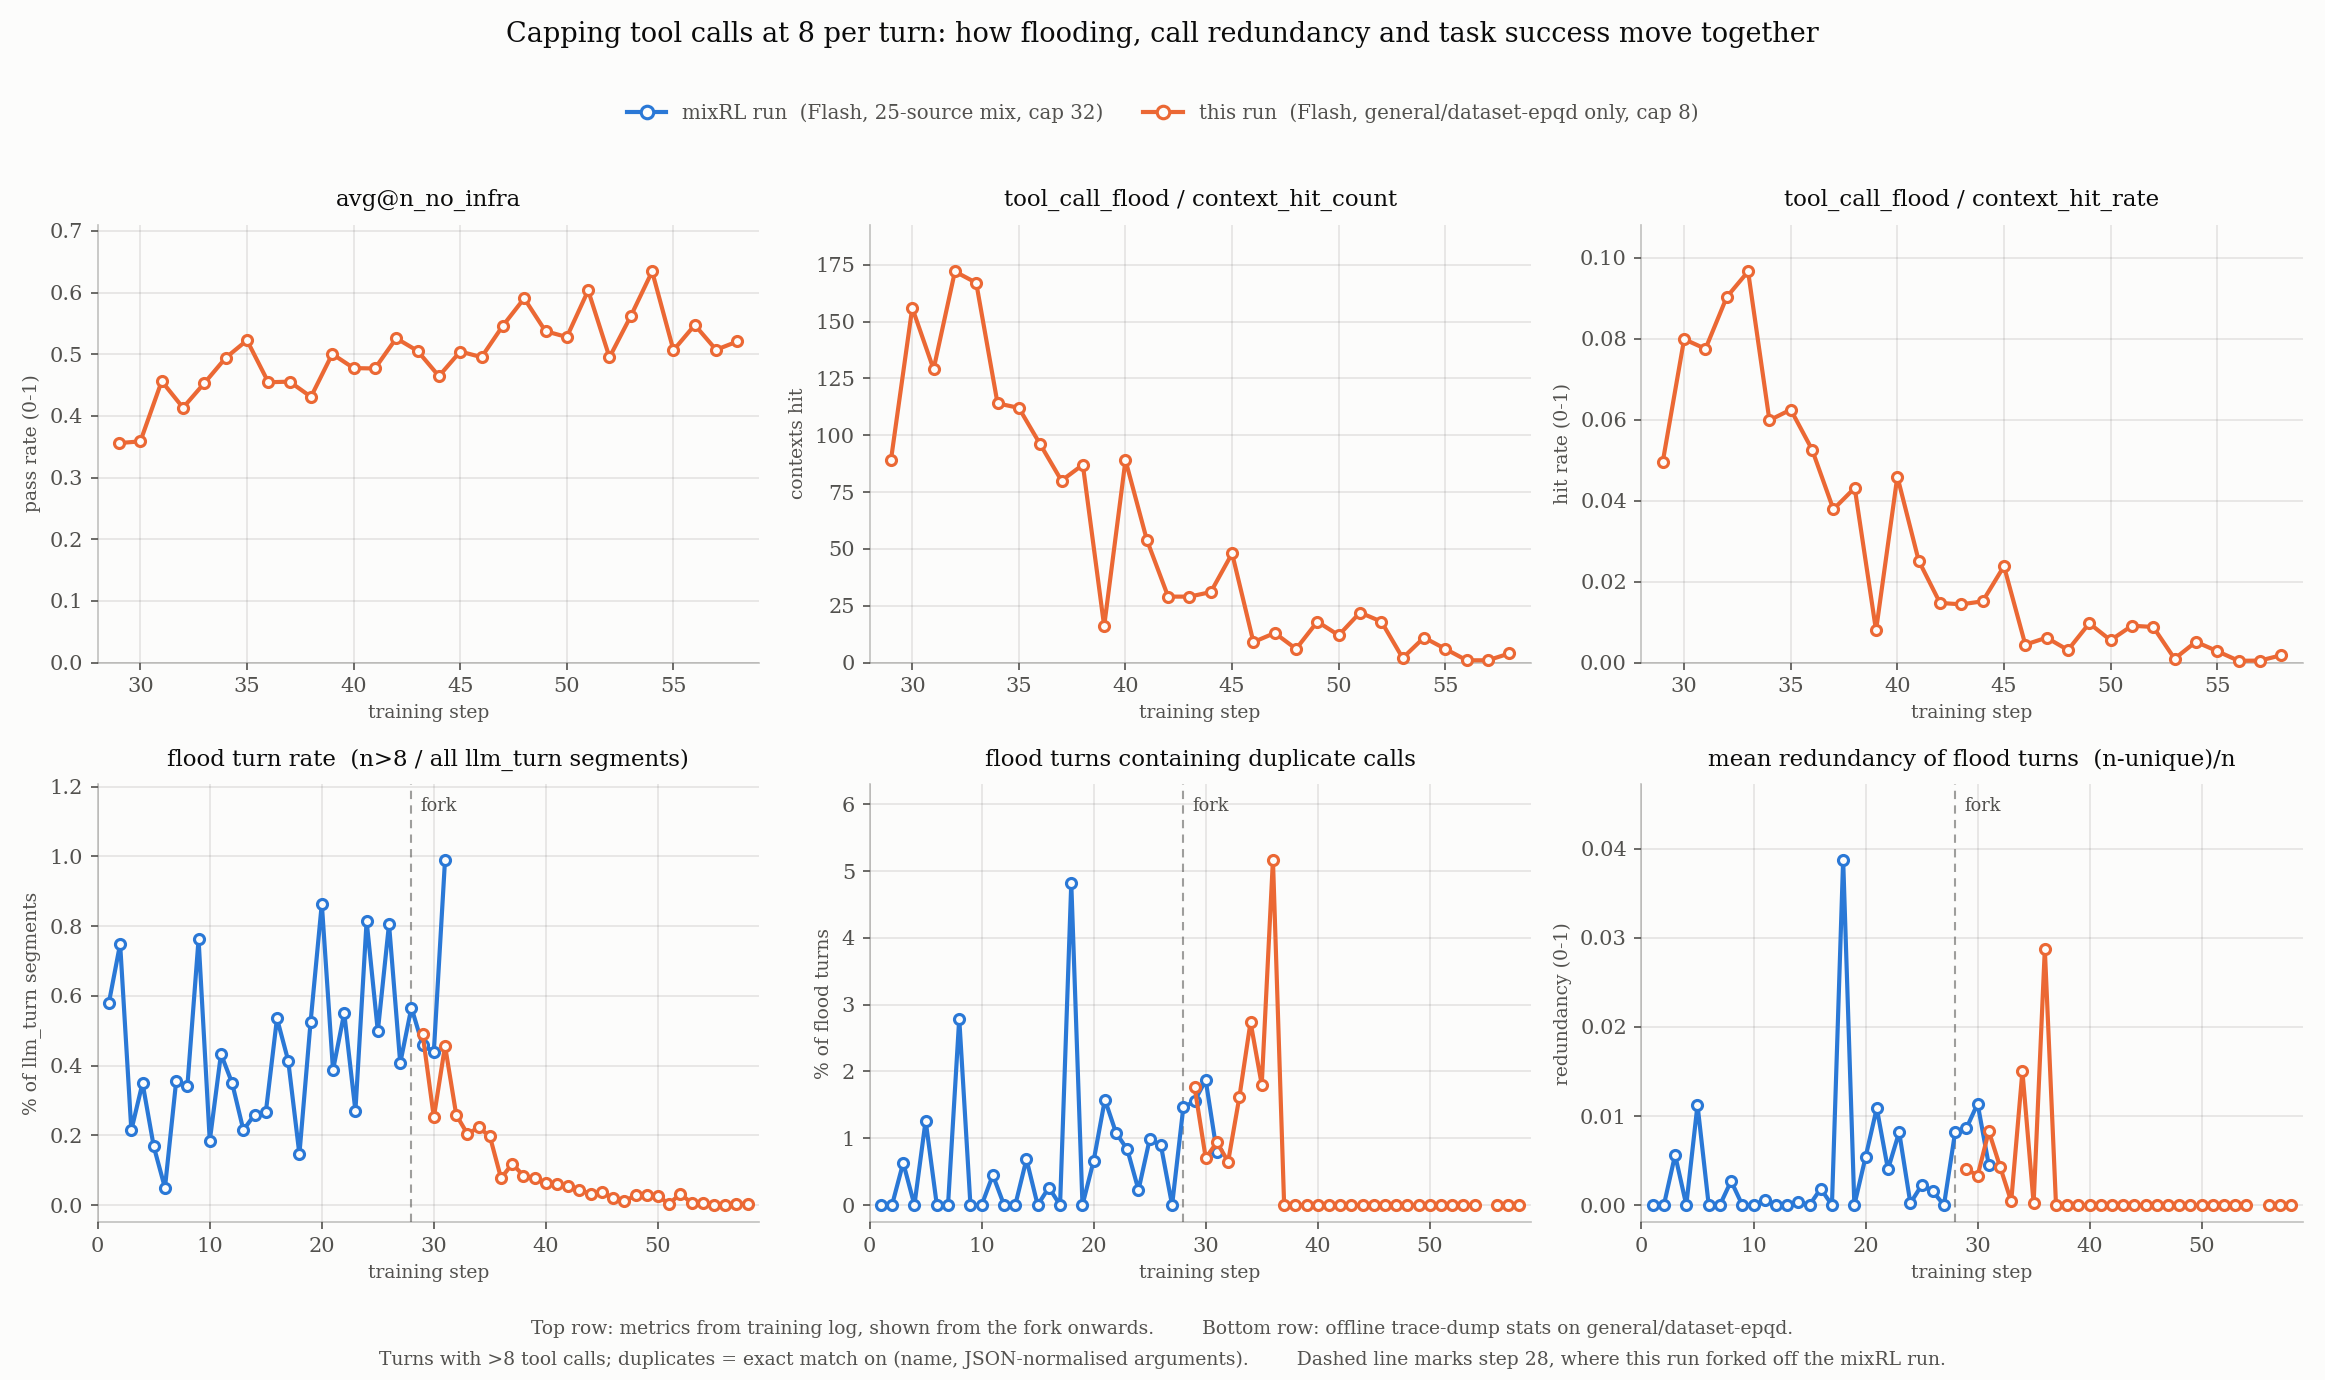
Giải pháp trực tiếp nhất là hạ thấp ngưỡng hình phạt tràn lệnh. Trong một thử nghiệm riêng biệt trên nguồn dữ liệu general/dataset-epqd nhỏ và biệt lập, chúng tôi đã hạ ngưỡng từ 32 lệnh gọi xuống tám và tiếp tục huấn luyện từ điểm kiểm tra bước 28 của MiMo-V2.6-Flash. Số lượng các lượt chứa hơn tám lệnh gọi đã giảm đáng kể, cho thấy hình phạt nghiêm ngặt hơn đã ngăn chặn hiệu quả tình trạng tràn lệnh mà không làm giảm đáng kể phần thưởng tổng thể.
Nhược điểm là hiệu quả chỉ xuất hiện sau khoảng 20 bước huấn luyện. Do đó, việc áp dụng giải pháp này trên quy mô đầy đủ sẽ yêu cầu khởi động lại 20 bước của MixRL, với chi phí ước tính là 2,31 triệu đô la.
Hình phạt ở cấp độ môi trường cũng tổng quát hóa kém đối với toàn bộ tập đánh giá nội bộ. Việc phát lại các trường hợp lặp lại với điểm kiểm tra thu được đã giảm tỷ lệ lặp lại từ 13,45% xuống 3,83%, nhưng không loại bỏ hoàn toàn vấn đề.
Tỷ lệ lặp lại khi phát lại (replay) của các checkpoint có hình phạt nghiêm ngặt hơn. History N nghĩa là lịch sử hiển thị của yêu cầu được phát lại đã chứa N lượt với ≥10 lần gọi công cụ.
| Checkpoint | Tập kiểm thử nội bộ 1 · lịch sử 0 | Tập kiểm thử nội bộ 1 · lịch sử 1 | Tập kiểm thử nội bộ 2 · lịch sử 0 | Tập kiểm thử nội bộ 2 · lịch sử 1 |
|---|---|---|---|---|
| flash-ga-grpo-s30 | 2.27% (1/44) | 28.57% (4/14) | 13.45% (30/223) | 25.00% (13/52) |
| flash-ga-grpo-s35 | 9.30% (4/43) | 33.33% (5/15) | 7.86% (18/229) | 17.65% (9/51) |
| flash-ga-grpo-s40 | 11.11% (5/45) | 33.33% (5/15) | 4.58% (11/240) | 17.86% (10/56) |
| flash-ga-grpo-s45 | 0% (0/45) | 28.57% (4/14) | 4.40% (11/250) | 11.67% (7/60) |
| flash-ga-grpo-s50 | 0% (0/43) | 28.57% (4/14) | 3.83% (9/235) | 16.98% (9/53) |
Một giải pháp hiệu quả và có khả năng tổng quát hóa tốt hơn
Do đó, chúng tôi cần một giải pháp vừa hiệu quả trong huấn luyện, vừa mạnh mẽ trong các kịch bản thực tế nằm ngoài phân phối huấn luyện. Cuối cùng, chúng tôi đã áp dụng phương pháp dựa trên MOPD (Chưng cất chính sách trực tuyến đa giáo viên - Multi-teacher On-Policy Distillation).
Đầu tiên, chúng tôi sử dụng các ví dụ lặp lại được thu thập nội bộ để huấn luyện một giáo viên RL chuyên biệt cho một lượt. Một quá trình rollout nhận phần thưởng bằng 0 khi xảy ra lặp lại và chỉ nhận phần thưởng bằng 1 khi không có sự lặp lại cũng như không có lỗi gọi công cụ. Chúng tôi cũng áp dụng hàm mất mát KL để giữ cho giáo viên bám sát chính sách RL gốc. Chỉ sau 12 bước huấn luyện, bao gồm khoảng 7.000 ví dụ, giáo viên đã giảm tỷ lệ lặp lại khi phát lại xuống bằng không trên cả tập huấn luyện và tập kiểm thử độc lập.
Để hiểu cơ chế ở mức độ chi tiết hơn, chúng tôi đã kiểm tra một quỹ đạo được lấy mẫu từ các dấu vết RL. Trước khi sửa lỗi, mô hình đã thực hiện 59 lần gọi công cụ. Tại mỗi vị trí token <tool_call>, chúng tôi so sánh xác suất được gán cho <|im_end|>, token kết thúc lượt, bởi các mô hình trước và sau khi sửa lỗi.
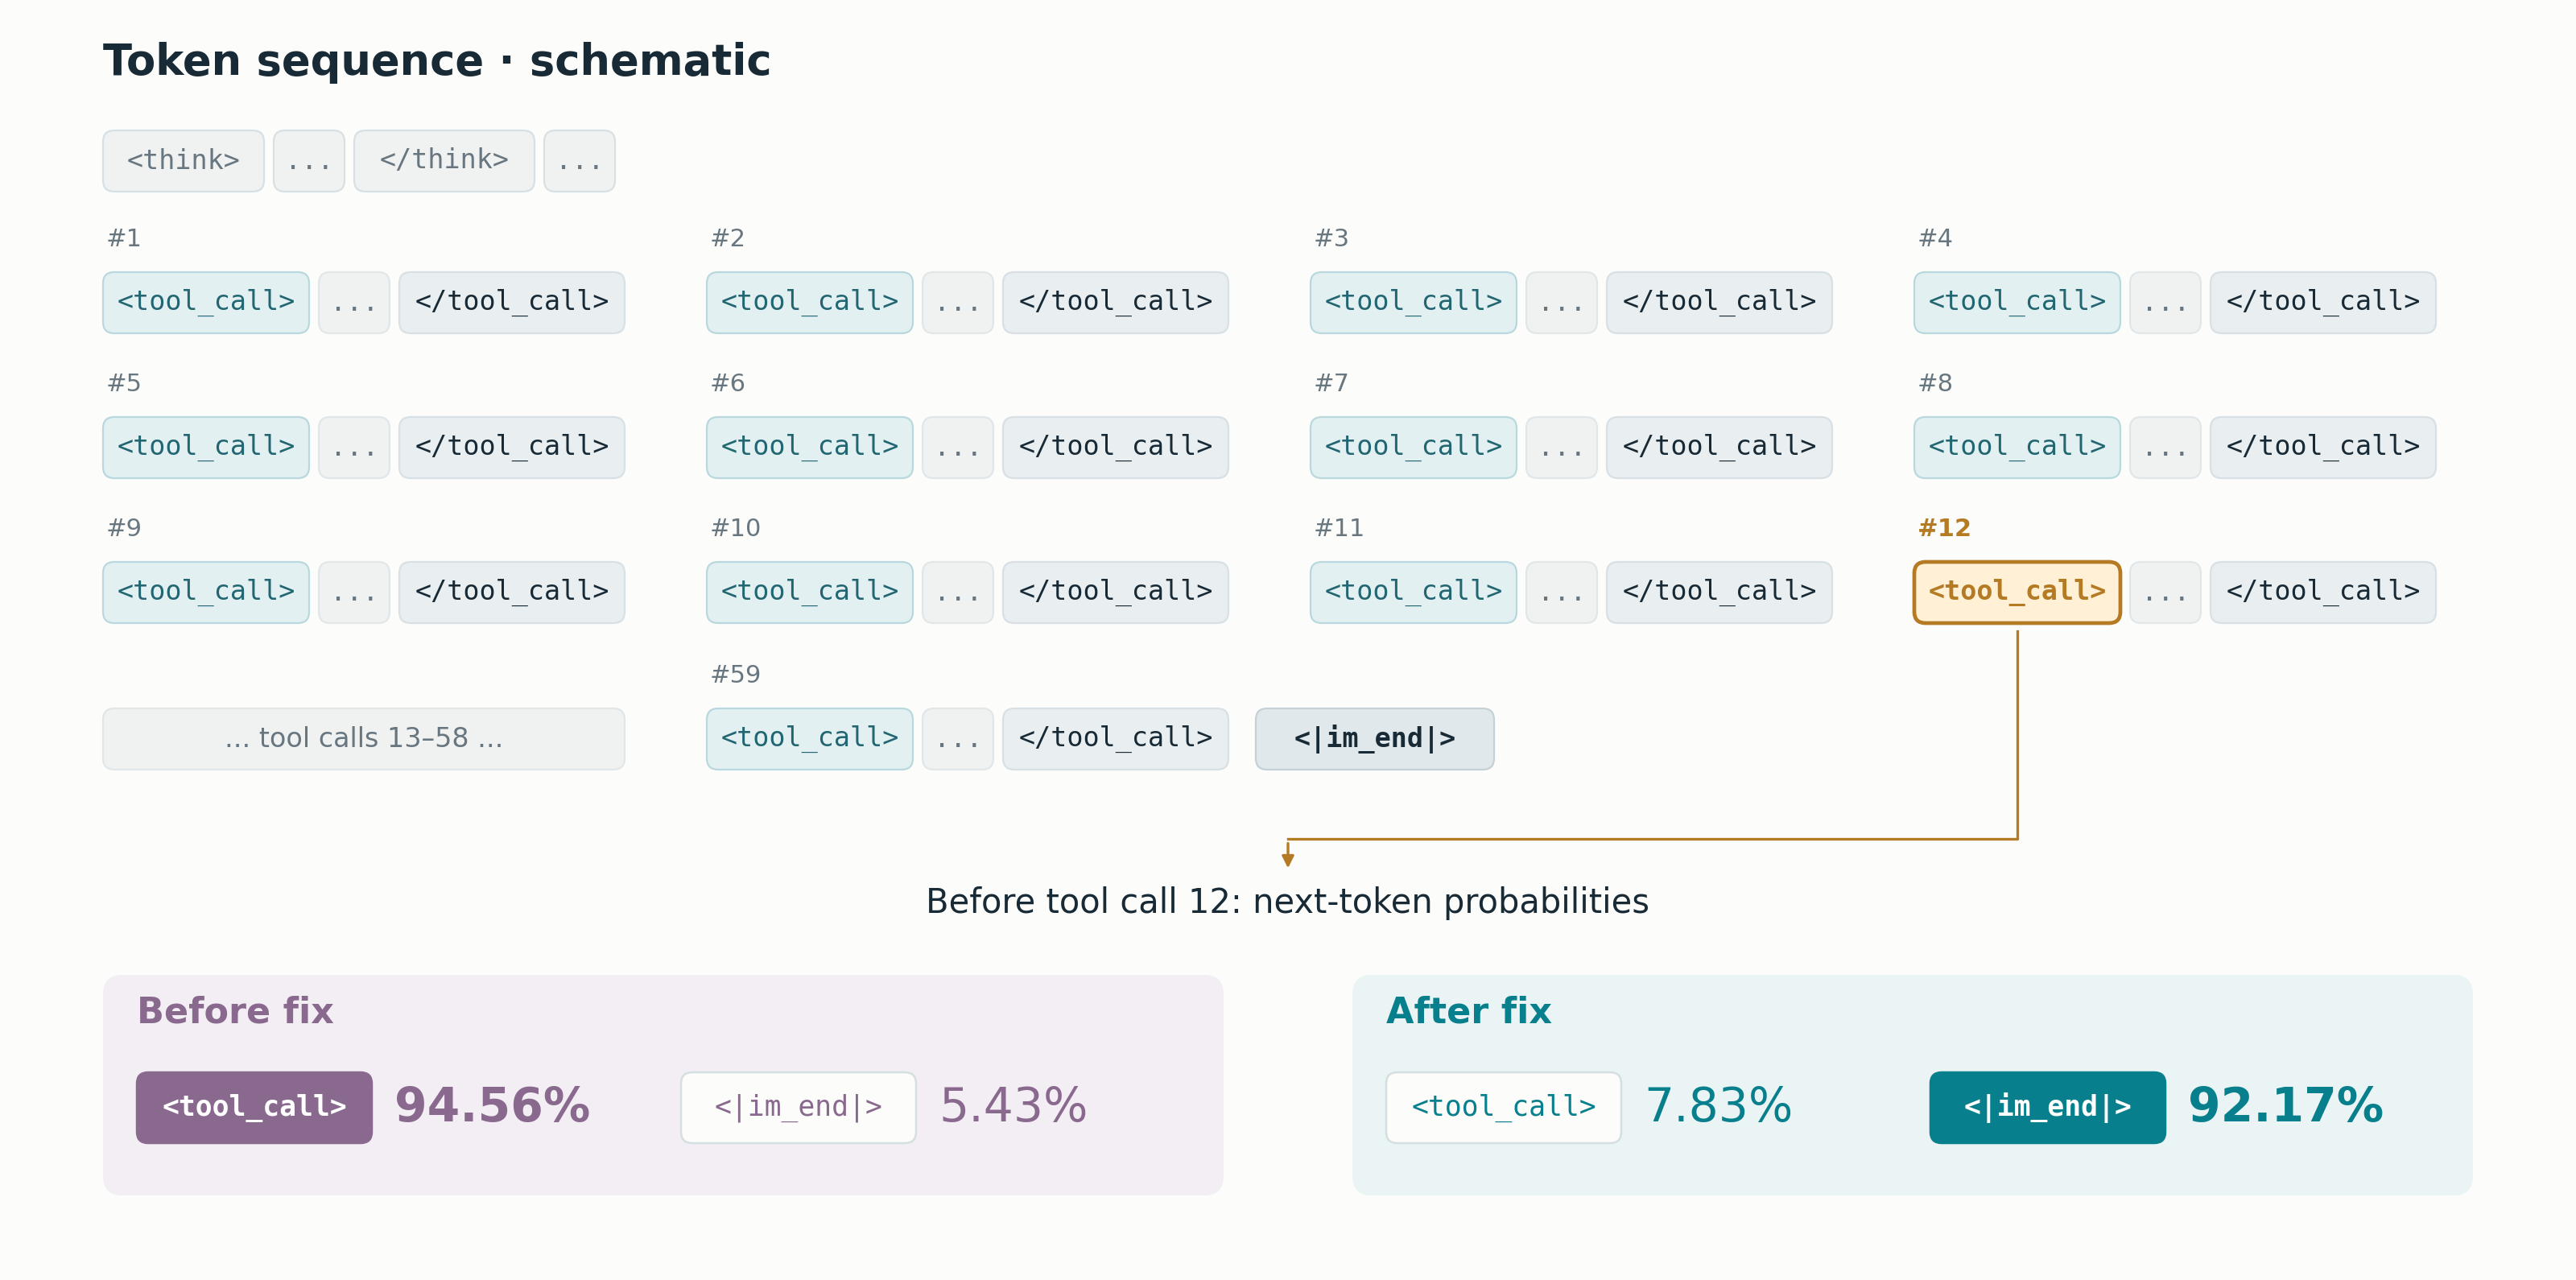
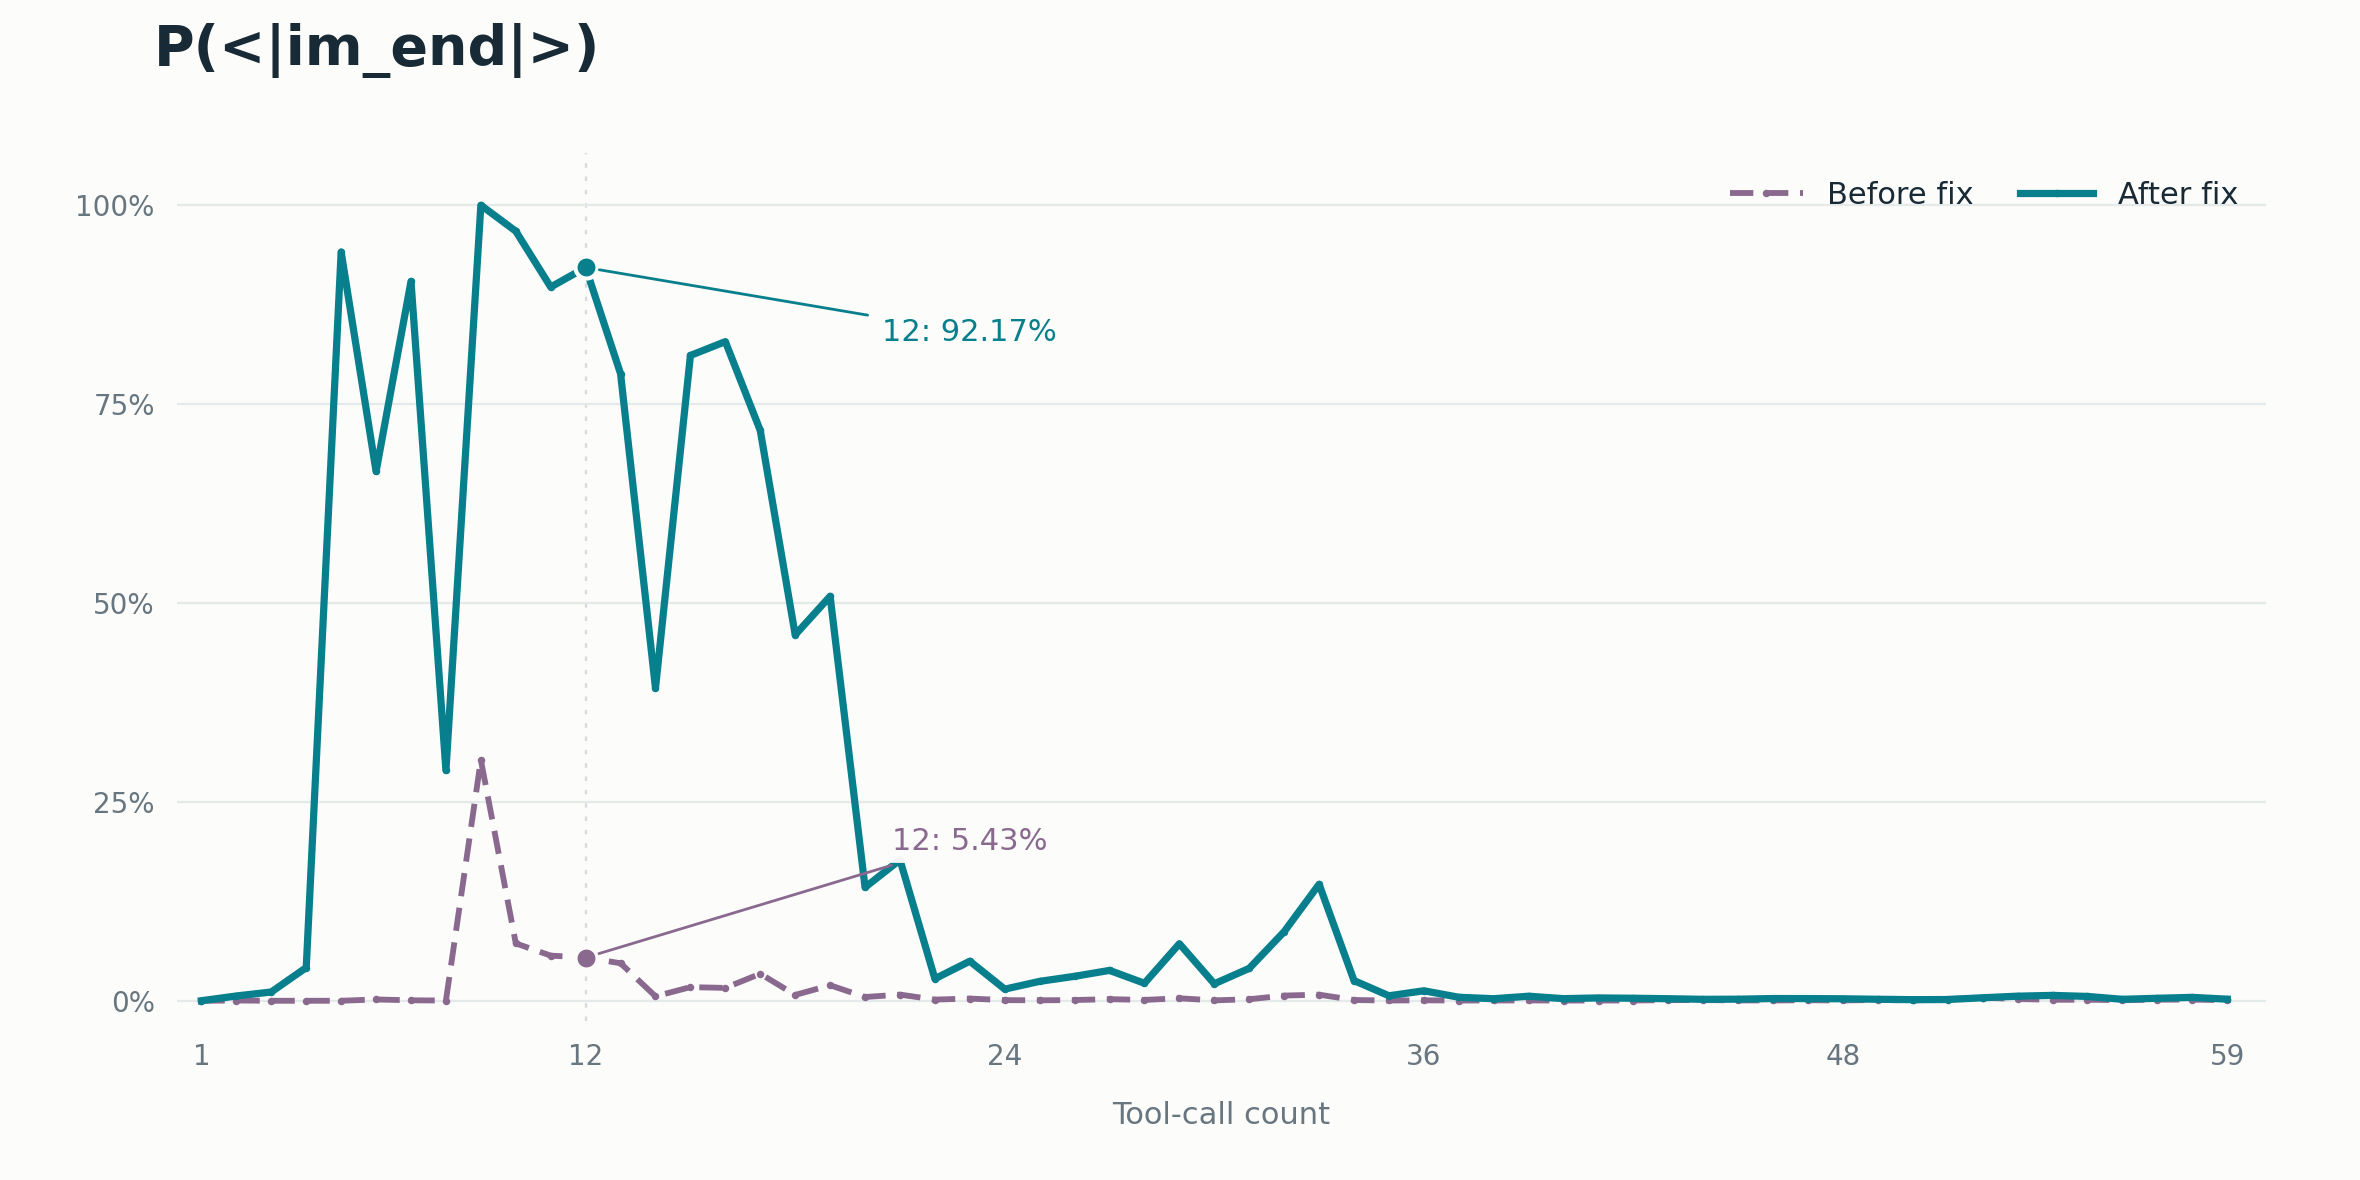
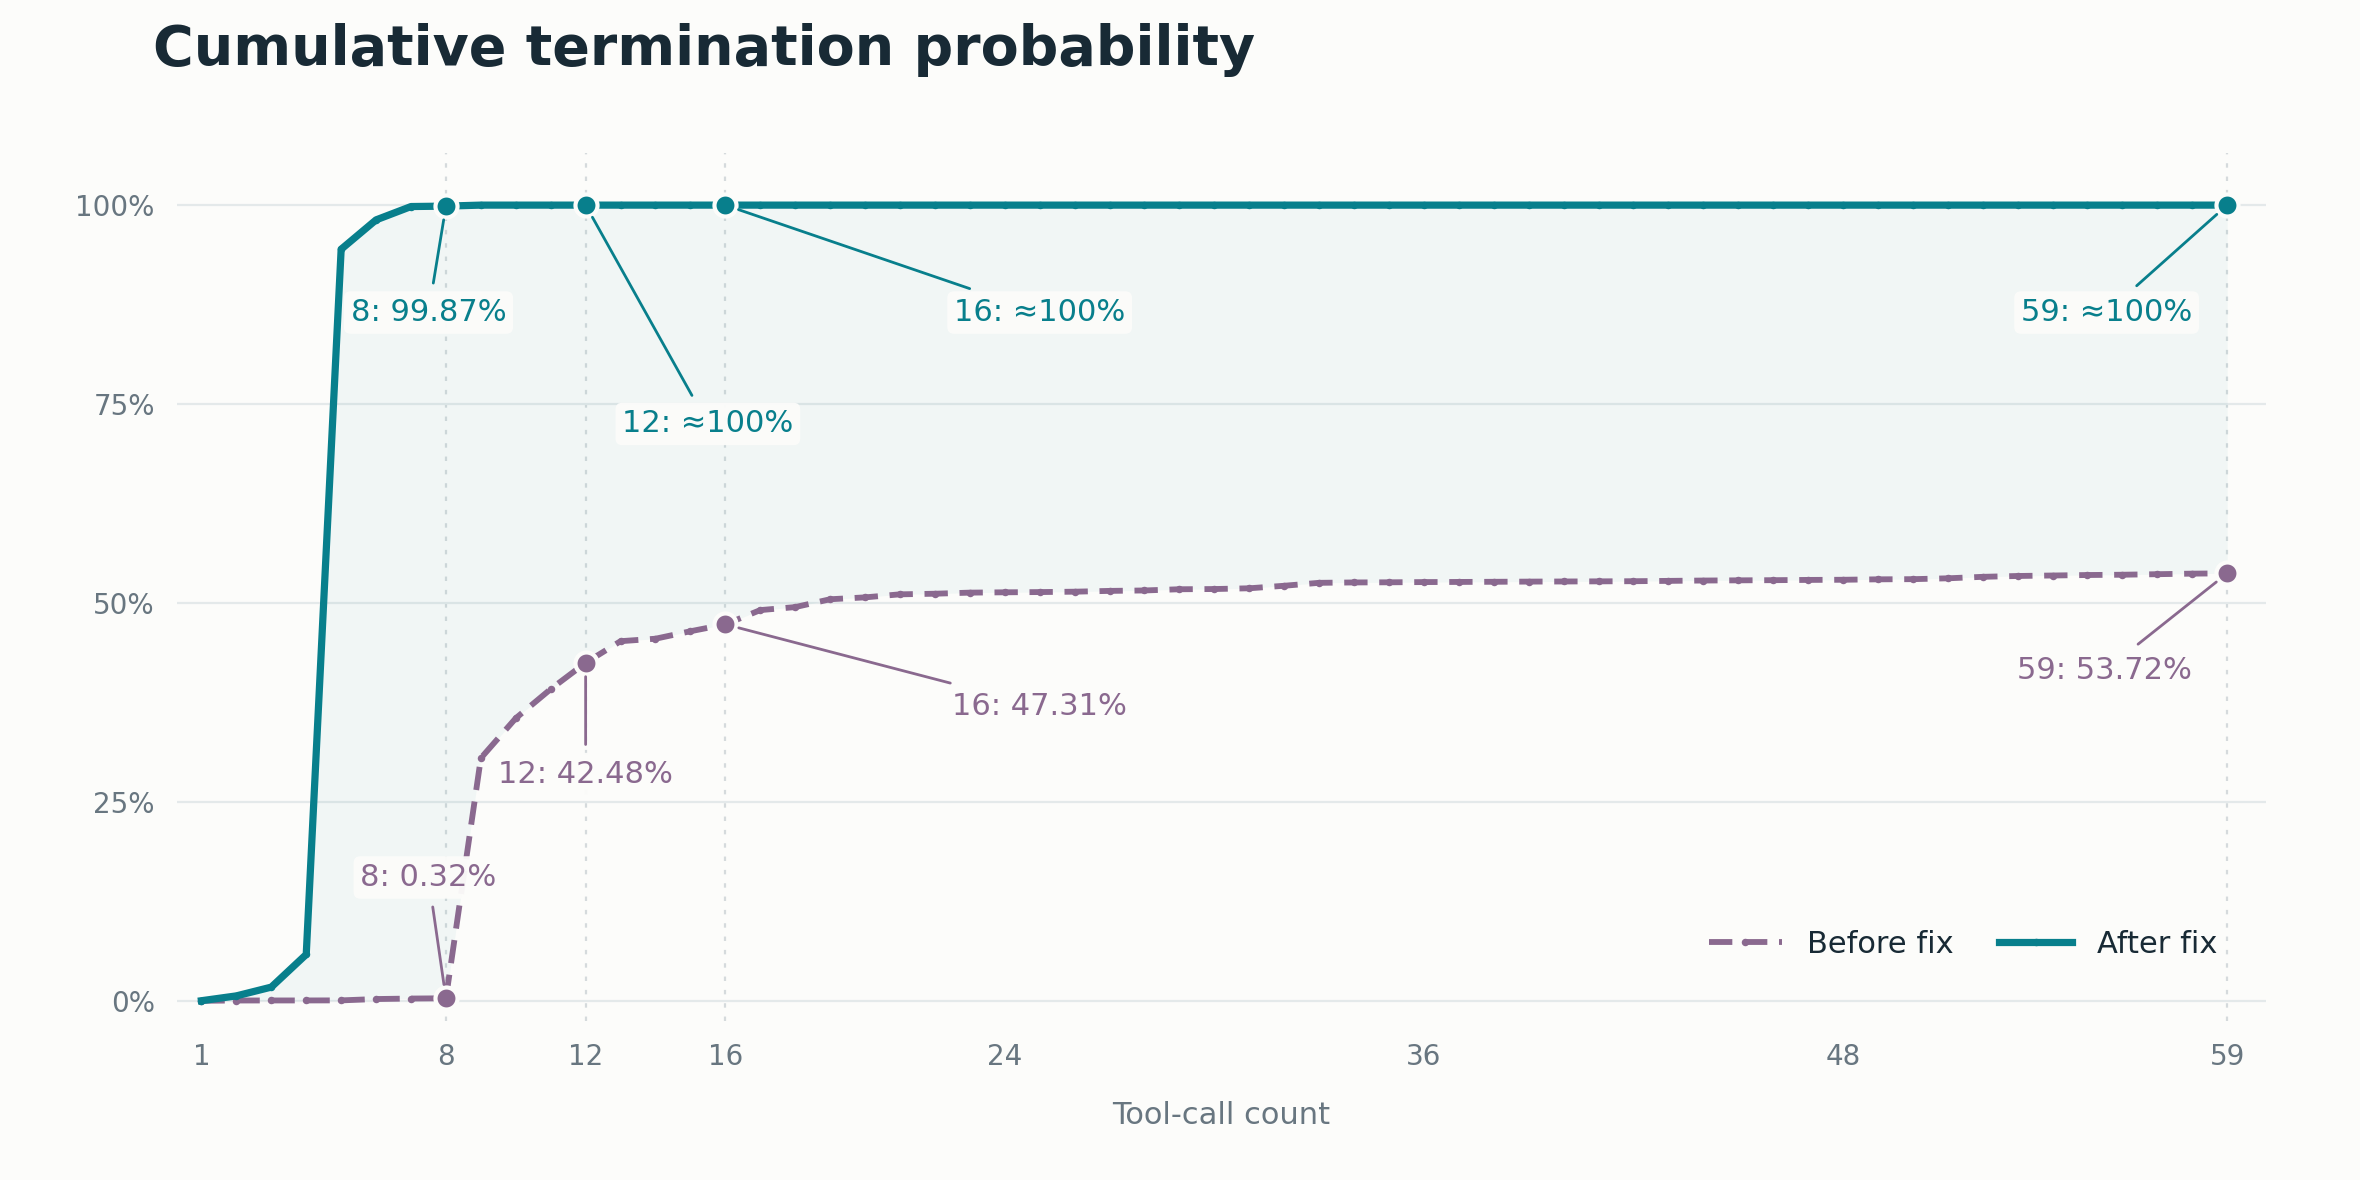
Chúng tôi cũng tính toán xác suất dừng tích lũy tại vị trí k:
Fk = 1 − ∏i=1k (1 − pi)
trong đó Fk là xác suất mô hình dừng lại tại lần gọi công cụ thứ k.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Xiaomi MiMo: Phát hành và blog chính thức. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.