Hướng dẫn
Cursor chia sẻ chiến lược tối ưu hóa Token cho AI Agent, giúp giảm 7% chi phí
(giờ Việt Nam)
Tóm tắt AI
Cursor công bố các kỹ thuật tối ưu hóa cho AI Agent như tinh gọn system prompt, tận dụng bộ nhớ đệm của GPT-5.6 và quản lý ngữ cảnh linh hoạt, giúp giảm 7% chi phí Token mà vẫn duy trì chất lượng phản hồi.
Chính văn · Bản dịch AI
Khi các tác nhân (agent) ngày càng trở nên hoàn thiện và có khả năng đảm nhận những nhiệm vụ thách thức hơn, bối cảnh chi tiêu token cũng thay đổi theo. Ngày nay, các tác nhân hoạt động trong thời gian dài hơn và duy trì nhiều ngữ cảnh hơn từ bước này sang bước khác, điều này khiến cách chúng ta tổ chức và quản lý ngữ cảnh trở nên quan trọng hơn bao giờ hết.
Giải thích: Định nghĩa hệ thống và công cụ bao gồm tóm tắt compaction. Văn bản người dùng bao gồm các kỹ năng được đính kèm thủ công. Kỹ năng và plugin bao gồm mô tả kỹ năng, mô tả công cụ MCP, cũng như các quy tắc đưa vào ngữ cảnh tĩnh.
Trong vài tháng qua, chúng tôi đã tập trung cải thiện hiệu suất của harness cho tác nhân Cursor để thích ứng với sự thay đổi này. Harness cho phép chúng tôi kiểm soát trực tiếp cách mỗi yêu cầu được lắp ráp, cách ngữ cảnh được tái sử dụng và thời điểm chia nhỏ công việc cho nhiều tác nhân. Những thay đổi ở các cấp độ này đã giúp giảm 7% chi phí token cho người dùng mà không làm giảm chất lượng của tác nhân.
Tinh giản lời nhắc hệ thống (system prompt)
Trước khi mô hình bắt đầu làm việc, Cursor cung cấp ngữ cảnh cho mỗi lượt (turn) của tác nhân, bao gồm lời nhắc hệ thống và định nghĩa các công cụ mà tác nhân có thể sử dụng. Vì phần ngữ cảnh này xuyên suốt toàn bộ cuộc hội thoại, nó đã trở thành một trong những nguồn chi tiêu lớn nhất mà chúng tôi có thể kiểm soát hoàn toàn.
Khi khả năng của mô hình còn hạn chế, chúng tôi buộc phải viết các hướng dẫn chi tiết về việc sử dụng công cụ, quản lý tác vụ và quy trình sửa đổi mã nguồn, đồng thời phải ngăn chặn các hành vi kỳ lạ như xuất ra các hash dump siêu dài, nội dung nhị phân và biểu tượng cảm xúc.
Khi khả năng của mô hình được nâng cao, hầu hết các hướng dẫn này không còn cần thiết nữa. Chúng tôi không cần liệt kê một danh sách dài các chỉ dẫn như "không được làm điều này", "bạn phải" hoặc "quan trọng", chỉ cần định nghĩa cách thức hoạt động của công cụ là mô hình thường sẽ tuân theo. Điều này đúng với mọi dòng mô hình, cho phép chúng tôi tinh giản khoảng 66% lời nhắc hệ thống.
Theo thời gian, các mô hình mới cần những hướng dẫn mới, chúng tôi cũng sẽ liên tục thêm hoặc bớt các chỉ dẫn, và những hướng dẫn này sẽ được tích hợp vào quá trình huấn luyện các mô hình tương lai. Để tối ưu hóa harness hiệu quả cho lưu lượng truy cập thực tế, việc tiến hành A/B testing trên quy mô người dùng lớn là vô cùng quan trọng. Mặc dù evals là một phương thức thay thế nhanh chóng và thiết thực, nhưng chúng thường đại diện cho các vấn đề "khó" và không phản ánh trung thực phân bổ yêu cầu thực tế của người dùng.
Chỉ tải công cụ khi cần thiết
Lời nhắc hệ thống chỉ là một phần ngữ cảnh mà Cursor cung cấp trong mỗi lượt hội thoại, phần còn lại là định nghĩa công cụ. Trong năm qua, khi chúng tôi thêm ngày càng nhiều tính năng mạnh mẽ cho tác nhân Cursor—bao gồm giám sát shell nền, tác nhân phụ trên đám mây và truy cập nội dung web đáng tin cậy hơn—quy mô của các định nghĩa công cụ đã tăng vọt. Hầu hết các công cụ này đều quan trọng, nhưng chưa đến 20% cuộc hội thoại thực sự cần dùng đến mỗi công cụ.
Điều này mang lại cơ hội nâng cao hiệu suất: giữ cho công cụ khả dụng nhưng không cần đính kèm định nghĩa đầy đủ của chúng trong mỗi yêu cầu. Đầu năm nay, chúng tôi đã giải quyết vấn đề tương tự—chuyển các công cụ MCP vào ngữ cảnh động, chỉ tải khi cần thiết. Điều này giúp giảm 46,9% tổng số token cho các phiên đã gọi công cụ MCP.
Hiện nay, chúng tôi áp dụng tư duy tương tự cho các công cụ tích hợp sẵn của mình.
Để xác định công cụ nào nên giữ lại trong ngữ cảnh tĩnh, chúng tôi đã thực hiện A/B testing trên nhiều cấu hình dựa trên tần suất sử dụng của mỗi công cụ và việc liệu mô hình có cần nhìn thấy nó ngay từ đầu hay không. Chúng tôi theo dõi mức sử dụng token, chi phí, độ trễ, thông báo lỗi gọi công cụ và mức sử dụng tác nhân tổng thể để đảm bảo việc tiết kiệm chi phí không làm ảnh hưởng đến chất lượng.
Cuối cùng, chúng tôi giữ lại các công cụ tần suất cao như đọc, tìm kiếm, chỉnh sửa và sử dụng shell trong ngữ cảnh tĩnh; đồng thời giữ lại ask_question (một số mô hình dễ bị ảo giác khi gọi công cụ này), cũng như các công cụ quan trọng đối với quy trình sản phẩm cụ thể, chẳng hạn như create_plan trong chế độ lập kế hoạch. Các công cụ còn lại hiện chỉ được tải khi tác nhân cần.
Nâng cao tỷ lệ tái sử dụng bộ nhớ đệm (cache)
Sau khi giảm số lượng ngữ cảnh tĩnh trong mỗi yêu cầu, chúng tôi tiếp tục nâng cao hiệu quả của việc lưu trữ bộ nhớ đệm cho ngữ cảnh lặp lại giữa các lượt.
Mỗi lượt của tác nhân đều gửi lại một yêu cầu dài, bao gồm công cụ, chỉ dẫn hệ thống, cài đặt và nội dung hội thoại trước đó. Phần lớn nội dung ở đầu yêu cầu không thay đổi giữa các lượt, trong khi phần hội thoại ở cuối lại liên tục dài ra.
Bộ nhớ đệm lời nhắc (prompt caching) cho phép các nhà cung cấp mô hình tái sử dụng phần tiền tố không thay đổi này. Tuy nhiên, khả năng cấu hình bộ nhớ đệm khác nhau tùy theo nhà cung cấp. Trước GPT-5.6, ranh giới bộ nhớ đệm được hệ thống tự động xác định dựa trên yêu cầu mới nhất; mặc dù công cụ và chỉ dẫn hệ thống ít khi thay đổi, nhưng bản thân chúng không được đánh dấu rõ ràng là có thể tái sử dụng.
Kể từ GPT-5.6, OpenAI API cho phép khách hàng đánh dấu rõ ràng các điểm ngắt bộ nhớ đệm (cache breakpoint) ngoài bộ nhớ đệm ẩn mặc định. Hiện tại, chúng tôi đặt điểm ngắt sau phần ổn định của yêu cầu và trước phần hội thoại đang tăng dần, cho phép các lượt tiếp theo tái sử dụng nhiều hơn phần tiền tố không thay đổi.
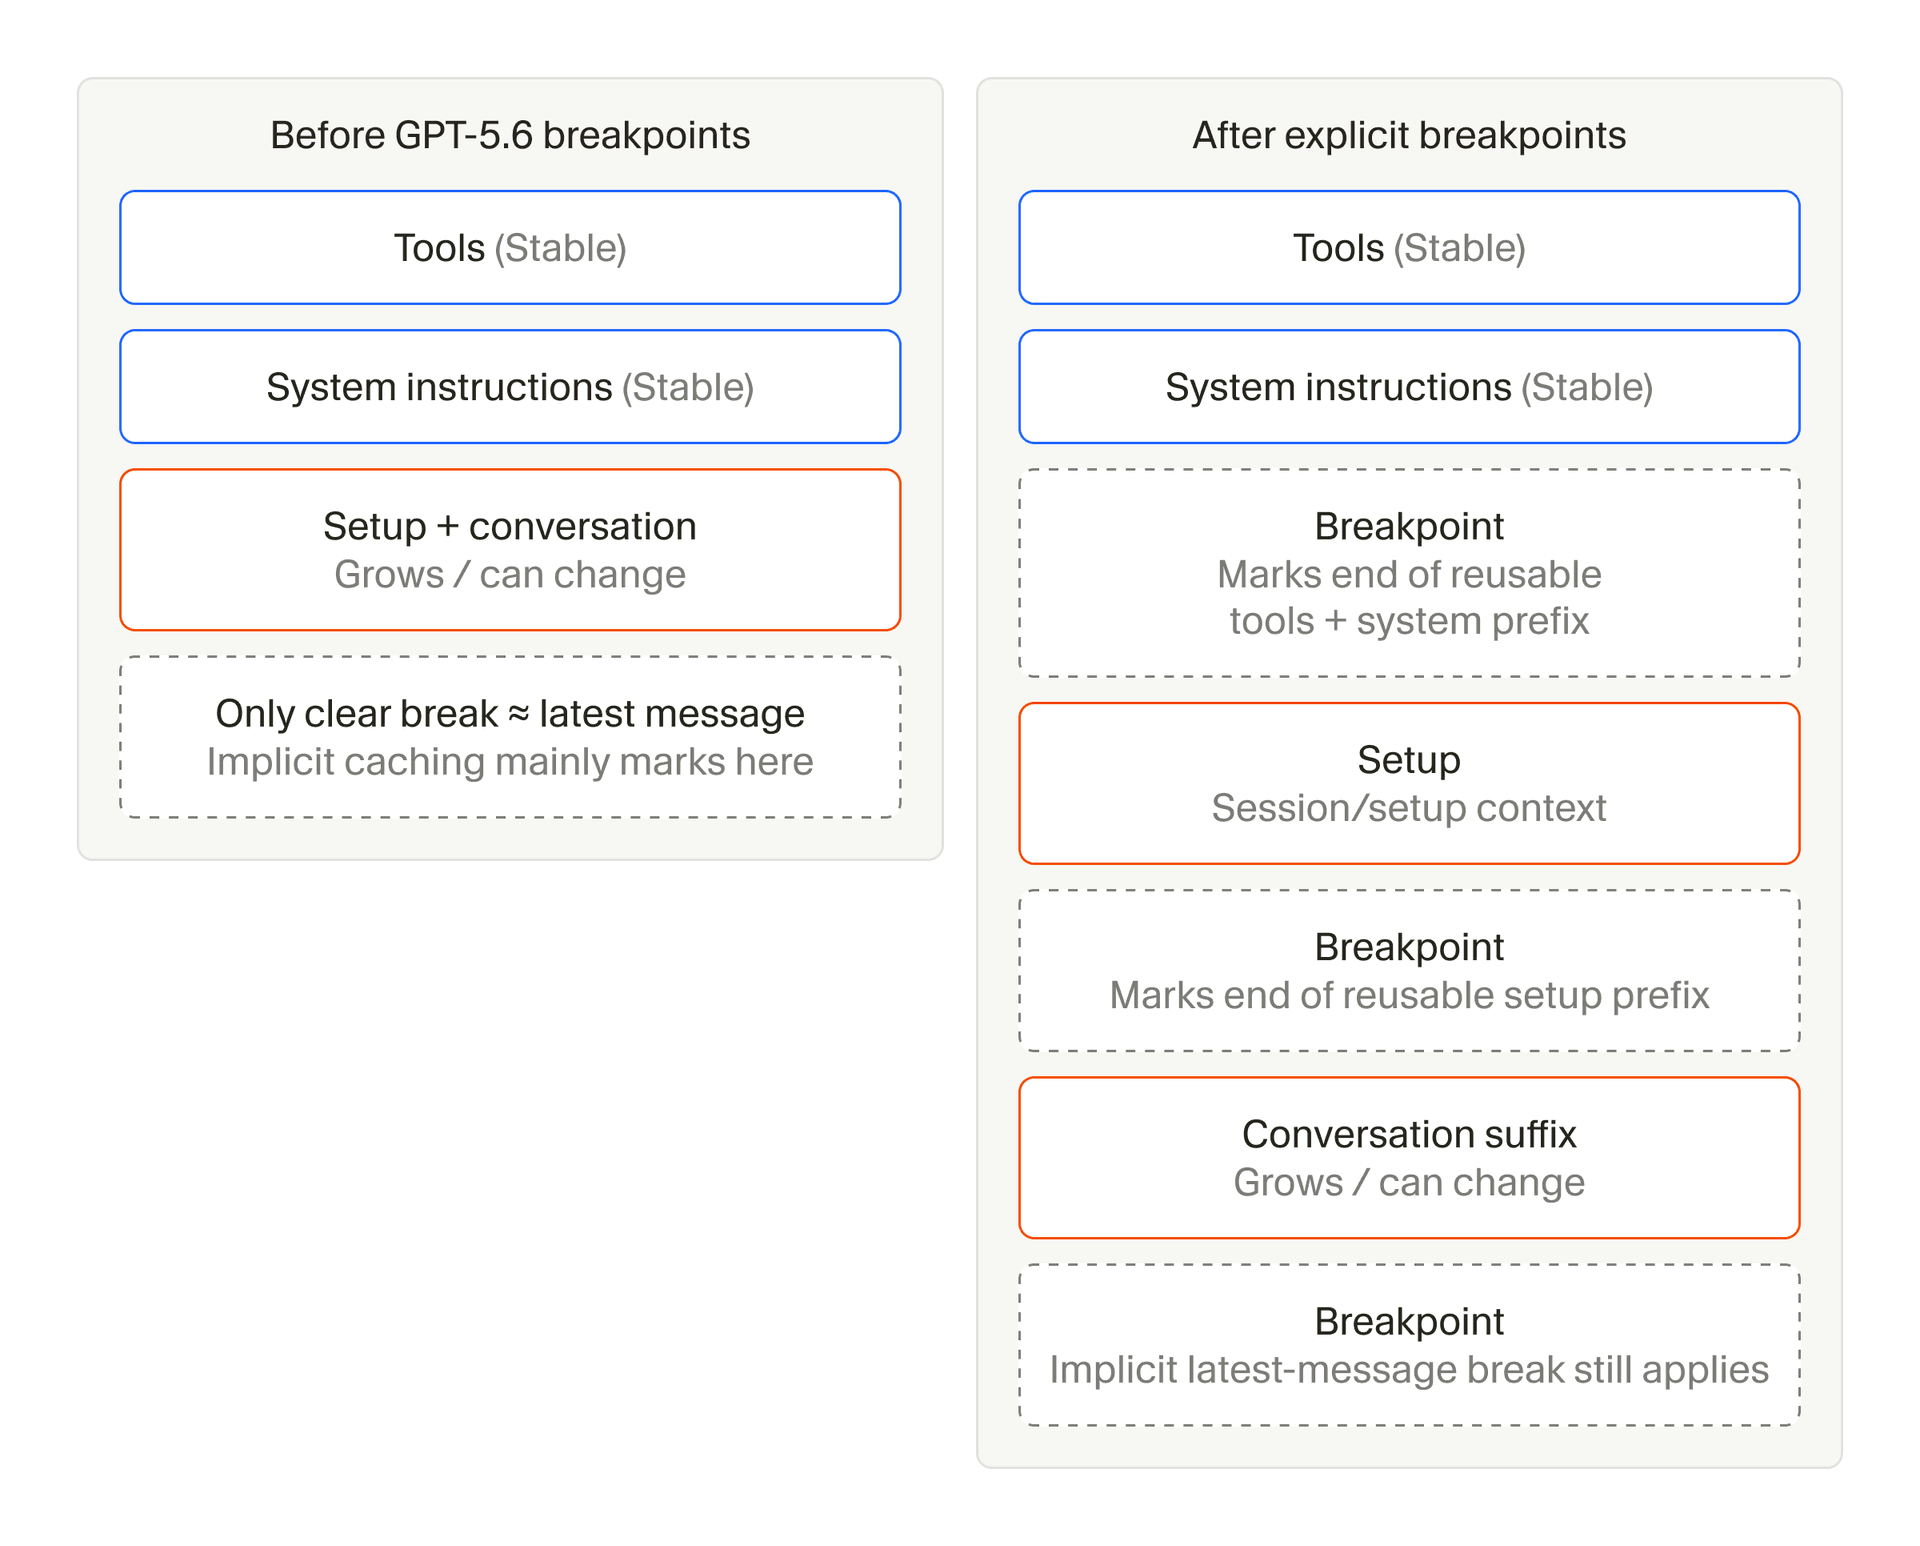
Chỉ khi bản thân tiền tố ổn định thì điểm ngắt mới phát huy tác dụng, vì vậy chúng tôi cũng đã tinh giản nội dung ở đầu mỗi yêu cầu. Cách làm cụ thể là: công cụ và chỉ dẫn hệ thống chỉ giữ lại những nội dung ít thay đổi nhất, đồng thời chuyển các cài đặt dễ thay đổi hơn vào "tin nhắn người dùng ảo" (phantom user message) sau ranh giới bộ nhớ đệm, dùng nó để chứa ngữ cảnh cấp người dùng và cấp yêu cầu, như kỹ năng, tác nhân phụ và thông tin môi trường.
Những thay đổi này giúp giảm 20% tỷ lệ trượt bộ nhớ đệm lạnh (cold cache miss).
Nén tệp đọc
Một nguồn chi tiêu token lớn khác là ngữ cảnh mà tác nhân liên tục thêm vào trong quá trình làm việc, phần lớn trong số đó đến từ việc đọc tệp.
Tác nhân của Cursor đọc tệp thông qua công cụ Read, công cụ này trước đây sẽ đánh số dòng cho mỗi dòng, vì bản thân mô hình không giỏi đếm dòng mà lại cần trích dẫn các đoạn mã cụ thể cho người dùng.
Một số dòng chỉ chiếm khoảng ba đến năm token, nhưng khi tác nhân đọc hàng chục nghìn dòng mã trong một phiên, việc đánh số từng dòng tích lũy lại tạo ra một lượng ngữ cảnh đáng kể.
Vì vậy, chúng tôi chuyển sang đánh số dòng mỗi mười dòng một lần để giảm chi phí này. Tần suất này vẫn đủ để mô hình trích dẫn mã chính xác, và thay đổi này giúp giảm 1,6% token đọc bộ nhớ đệm mà chất lượng không hề suy giảm.
Sử dụng tác nhân phụ một cách chiến lược
Tác nhân hoạt động càng lâu, cơ hội ủy quyền công việc cho các tác nhân phụ càng nhiều. Điều này giúp giảm chi tiêu token vì mỗi tác nhân phụ thường bắt đầu từ một cửa sổ ngữ cảnh hoàn toàn mới mà không mang theo toàn bộ cuộc hội thoại của tác nhân cha. Sau khi tác nhân phụ báo cáo kết quả, tác nhân cha có thể tiếp tục công việc mà không cần phải gánh toàn bộ ngữ cảnh công việc của tác nhân phụ.
Tuy nhiên, sự cô lập ngữ cảnh giữa tác nhân và tác nhân phụ thực sự tồn tại chi phí phối hợp: các tác nhân không chia sẻ ngữ cảnh có thể làm việc trùng lặp hoặc thực hiện các tác vụ không còn cần thiết.
Để đạt được lợi ích về hiệu suất mà không làm tăng chi phí phối hợp dư thừa, chúng tôi đã thực hiện hai thay đổi. Đầu tiên, chúng tôi loại bỏ các chỉ dẫn khuyến khích mạnh mẽ tác nhân gọi tác nhân phụ để khám phá cơ sở mã. Khi tác nhân phụ ngày càng phổ biến trong dữ liệu huấn luyện, các nhà nghiên cứu cũng đưa chúng vào quá trình hậu huấn luyện (post-training), mô hình đã nắm vững mô hình này một cách tự nhiên. Sau khi loại bỏ lời nhắc bổ sung, việc sử dụng tác nhân phụ trở nên cân bằng hơn.
Chúng tôi cũng thắt chặt cách chọn mô hình cho tác nhân phụ. Cursor có thể sử dụng bất kỳ mô hình khả dụng nào của chúng tôi để tạo tác nhân phụ, điều này vừa có thể bù đắp các điểm mù giữa các mô hình khác nhau, vừa cho phép kết hợp mô hình lập kế hoạch đắt tiền với mô hình thực thi rẻ hơn. Chúng tôi đã cập nhật các tham số công cụ để tác nhân chỉ chuyển sang mô hình khác khi người dùng hoặc harness chỉ định rõ ràng.
Tiếp tục nâng cao hiệu suất harness
Chúng tôi sẽ tiếp tục đo lường sự tích lũy ngữ cảnh trong quá trình hoạt động lâu dài và kiểm tra xem harness có thể giảm xử lý lặp lại ở những khâu nào mà không ảnh hưởng đến chất lượng của tác nhân. Theo thời gian, chúng tôi dự đoán điều này sẽ giúp tốc độ tăng trưởng mức sử dụng token chậm hơn nhiều so với khối lượng công việc mà tác nhân hoàn thành. Chúng tôi cũng đã áp dụng những kinh nghiệm này vào Grok Bot và đang tối ưu hóa harness độc quyền của nó để người dùng hoàn thành nhiều công việc nhất với chi phí thấp nhất.
Bài viết được AI dịch và tổng hợp tự động từ Cursor Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.