Hướng dẫn
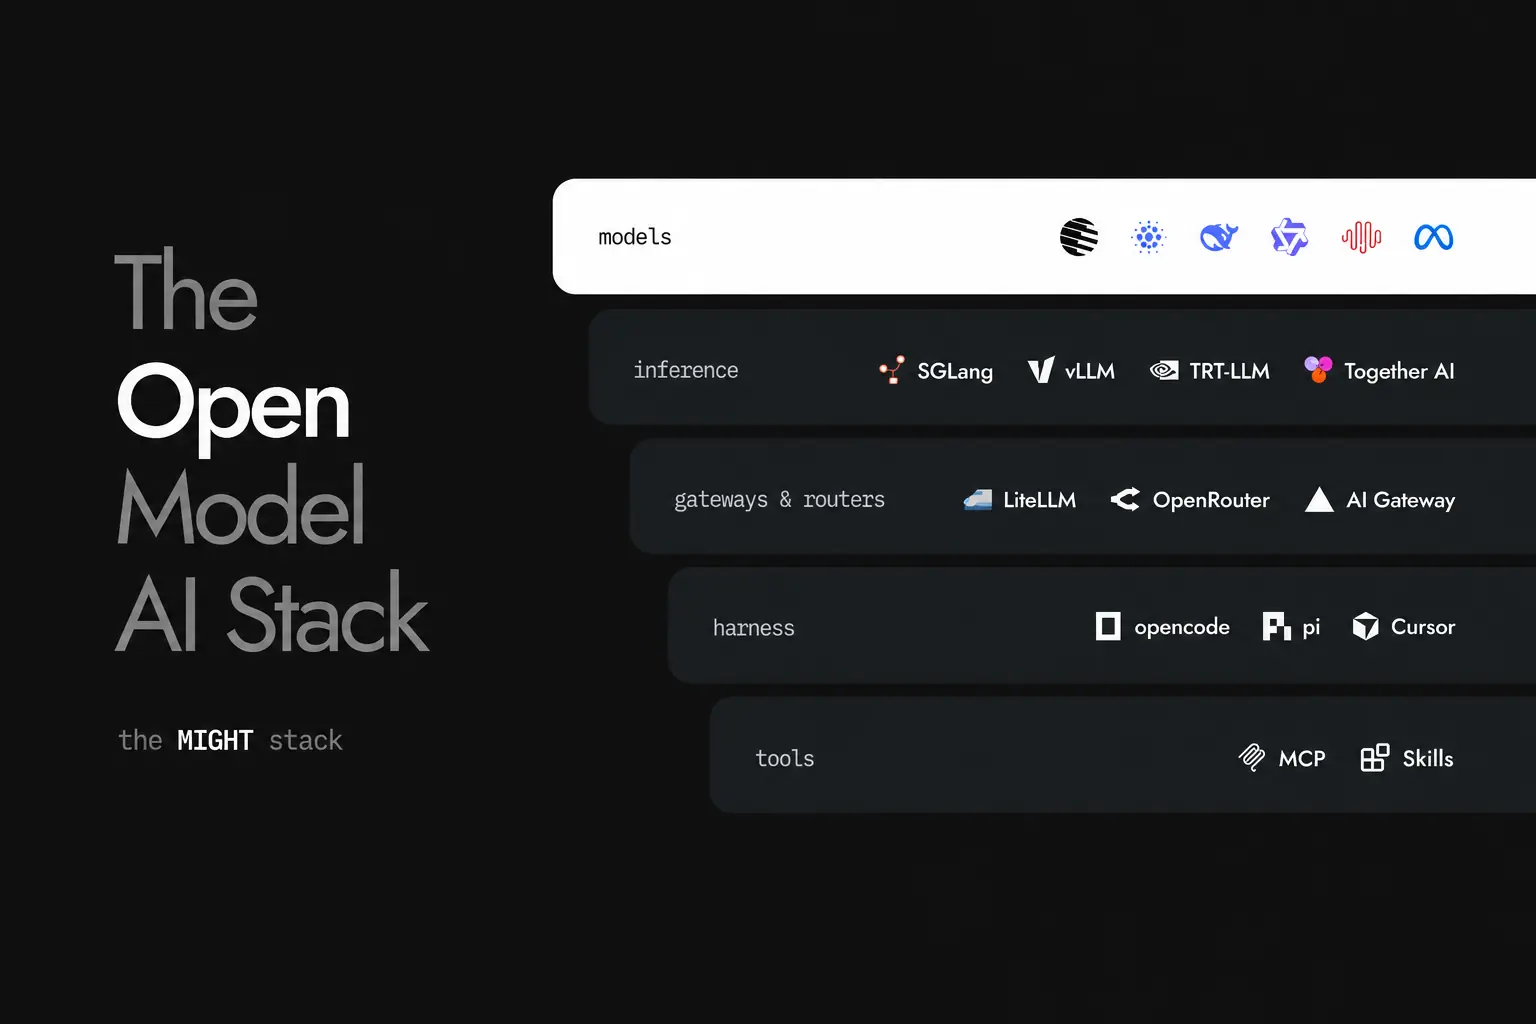
Together AI giải mã 'MIGHT': Bộ khung chuẩn để xây dựng ứng dụng AI từ mã nguồn mở
(giờ Việt Nam)
Tóm tắt AI
Together AI giới thiệu khung MIGHT—một bộ công cụ toàn diện bao gồm Model, Inference, Gateways, Harness và Tools, giúp các nhà phát triển chuyển đổi từ mô hình đóng sang hệ sinh thái mã nguồn mở một cách hiệu quả.
Chính văn · Bản dịch AI

Khi chất lượng của các mô hình mã nguồn mở (open source) đã dần thu hẹp khoảng cách với các mô hình đóng (closed source), rất nhiều nhà phát triển và tổ chức đang tìm cách chuyển sang sử dụng mô hình mã nguồn mở để có quyền sở hữu, kiểm soát và hiệu quả kinh tế tốt hơn. Bài viết này sẽ đi sâu vào hệ sinh thái AI mã nguồn mở mà các nhà phát triển cần cân nhắc khi chuyển đổi từ mô hình đóng sang mở.
Việc sử dụng các mô hình mở cho phát triển phần mềm dạng tác nhân (agentic) không đòi hỏi bạn phải học cách huấn luyện mô hình, mua cả dàn GPU hay trở thành chuyên gia về học máy. Dưới góc độ của một nhà phát triển ứng dụng, hệ sinh thái này quen thuộc đến bất ngờ so với việc sử dụng các mô hình đóng. Bạn có một mô hình để trả lời các câu lệnh (prompt) và một bộ khung (harness) để quản lý sự tương tác giữa bạn và mô hình đó.
Nếu bạn đã biết cách sử dụng Claude Code, bạn đã tiến gần hơn đến việc sử dụng các mô hình mở nhiều hơn bạn nghĩ.
Hệ sinh thái MIGHT
Hệ sinh thái này có thể được chia thành các phần riêng biệt sau:
Các lớp này hoàn toàn độc lập với nhau, mở ra cơ hội cho các quyết định kỹ thuật ở từng lớp sao cho phù hợp nhất với quy trình phát triển của bạn. Nhờ đó, bạn có thể thử nghiệm các mô hình mới ngay khi chúng vừa được ra mắt.
Các mô hình mới xuất hiện liên tục. Một số nhanh hơn. Một số rẻ hơn. Một số lại đặc biệt giỏi trong một loại công việc cụ thể. Nếu việc chuyển đổi mô hình chỉ mất vài phút thay vì phải xây dựng lại quy trình làm việc, bạn hoàn toàn có thể thử nghiệm chúng.
Trong bài viết này, chúng ta sẽ khám phá từng lớp của hệ sinh thái, giải thích chức năng của chúng và xem xét cách tùy chỉnh chúng. Hãy bắt đầu với lớp mô hình.
Các mô hình (Models)
Một mô hình sẽ tiếp nhận câu lệnh của bạn và tạo ra phản hồi bằng cách dự đoán các token tiếp theo có khả năng xảy ra cao nhất dựa trên dữ liệu huấn luyện của nó. Trong hệ sinh thái của chúng ta, nó đóng vai trò là lớp trí tuệ, chịu trách nhiệm lập luận, ra quyết định và xác định những thay đổi cần thực hiện trong cơ sở mã (codebase) của bạn.
Các mô hình có nhiều kích thước khác nhau, và nhìn chung, các mô hình lớn hơn thường có năng lực cao hơn, khả năng lập luận tốt hơn và hiệu suất đáng tin cậy hơn trong các tác vụ phức tạp. Hầu hết các mô hình mở hàng đầu hiện nay đều là mô hình Mixture-of-Expert (MoE), chứa nhiều "chuyên gia" chuyên biệt, nhưng chỉ kích hoạt một tập hợp con nhỏ trong số đó cho mỗi lần tạo token. Điều này cho phép chúng có số lượng tham số lớn nhưng chỉ kích hoạt một phần nhỏ, từ đó cần ít tài nguyên tính toán hơn để vận hành.
Các mô hình lớn (Large models)
Các mô hình lớn thường được định nghĩa bởi số lượng tham số mà chúng chứa và lượng tài nguyên tính toán được sử dụng để huấn luyện. Những mô hình này có khả năng phi thường trong việc nhận diện các mẫu, mối quan hệ và sự trừu tượng từ dữ liệu huấn luyện. Trong thực tế, "lớn" thường cũng ngụ ý rằng mô hình đã được huấn luyện trên nhiều dữ liệu hơn, trong thời gian dài hơn và với tài nguyên tính toán lớn hơn đáng kể.
Năng lực bổ sung này mang lại một vài lợi ích quan trọng. Các mô hình lớn thường giỏi hơn trong việc lập luận đa bước, nơi chúng cần theo dõi nhiều ràng buộc cùng lúc và đưa ra các quyết định phụ thuộc vào các phần trước đó của vấn đề. Điều này khiến chúng trở thành lựa chọn tuyệt vời cho các tác vụ mơ hồ hoặc chưa được xác định rõ ràng, vì chúng có thể tận dụng phạm vi mẫu đã học rộng hơn để lấp đầy các chi tiết còn thiếu.
Một ví dụ điển hình về mô hình mở lớn là Kimi K3, với tổng cộng 1.8T tham số và 104B tham số hoạt động. Hãy chọn các mô hình lớn như Kimi K3 khi bạn cần thực hiện các tác vụ phức tạp, chẳng hạn như:
Một ưu điểm của các mô hình lớn là tính linh hoạt trên nhiều loại công việc khác nhau. Chúng có thể chuyển đổi giữa việc viết mã, giải thích hệ thống, gỡ lỗi và lập kế hoạch thay đổi mà không cần các hướng dẫn quá chi tiết. Điều này đặc biệt hữu ích trong các quy trình làm việc dạng tác nhân (agent-style), nơi mô hình phải tự quyết định việc cần làm tiếp theo thay vì chỉ đơn thuần tuân theo một chỉ dẫn duy nhất.
Các mô hình lớn cũng tận dụng tốt hơn các cuộc hội thoại dài. Khi được cung cấp nhiều tệp, nhật ký hoặc thông tin cùng một lúc, chúng có khả năng duy trì sự mạch lạc và kết nối các chi tiết liên quan xuyên suốt toàn bộ dữ liệu đầu vào.
Điều này có thể khiến bạn tin rằng các mô hình lớn hơn luôn tốt hơn, nhưng trong thực tế, luôn có sự đánh đổi giữa mô hình lớn và nhỏ. Tiếp theo, chúng ta sẽ xem xét một số lý do để chọn mô hình nhỏ thay vì mô hình lớn.
Các mô hình nhỏ (Small models)
Sự khác biệt giữa mô hình nhỏ và lớn không nằm nhiều ở chất lượng mà ở mức độ mơ hồ mà chúng có thể xử lý một cách thoải mái.
Khi một tác vụ được xác định rõ ràng và phạm vi hẹp, các mô hình nhỏ có thể hoạt động ngang ngửa với các mô hình lớn hơn nhiều. Nếu bạn loại bỏ sự mơ hồ bằng cách nêu rõ những gì bạn muốn, chúng sẽ trở nên cực kỳ hiệu quả.
Các mô hình nhỏ vượt trội trong các công việc được chỉ định rõ ràng vì chúng không cần phải đoán kiến trúc của bạn, suy luận các yêu cầu ẩn hoặc khám phá nhiều cách hiểu khác nhau. Chúng chỉ đơn giản thực thi chỉ dẫn như đã được đưa ra.
Một ví dụ về mô hình mở nhỏ là GLM 5.3 Flash với 320B tổng tham số và 18B tham số hoạt động. Để so sánh với Kimi K3, nó nhỏ hơn khoảng 6 lần và rẻ hơn khoảng 20 lần.
Những mô hình này tỏ ra hiệu quả đến bất ngờ khi tác vụ hẹp và được xác định rõ, ví dụ như:
Không có nhiều sự mơ hồ trong các tác vụ này. Mô hình không cần phải xây dựng sự hiểu biết chi tiết về toàn bộ cơ sở mã của bạn hoặc quyết định giữa nhiều phương pháp kiến trúc khác nhau.
Ưu điểm quan trọng nhất của các mô hình nhỏ là chúng nhanh hơn và rẻ hơn đáng kể khi vận hành.
Chúng cần ít tài nguyên tính toán hơn để tạo ra mỗi token. Trong thực tế, điều này có nghĩa là phản hồi có độ trễ thấp hơn và chi phí cho mỗi yêu cầu thấp hơn nhiều. Đối với nhiều tác vụ lập trình hàng ngày, sự khác biệt về tốc độ này có thể nhận thấy ngay lập tức vì mô hình phản hồi nhanh, các vòng lặp diễn ra nhanh hơn và bạn có thể đủ khả năng chạy nó nhiều lần mà không cần lo lắng về chi phí.
Thay vì nghĩ rằng các mô hình lớn hơn luôn tốt hơn các mô hình nhỏ hơn, tốt hơn hết hãy coi chúng là hai loại công cụ khác nhau trong một hộp công cụ.
Mô hình như những công cụ
Một mô hình lớn hơn có thể giải quyết vấn đề một cách đáng tin cậy hơn, nhưng nó cũng có thể chậm hơn hoặc đắt hơn gấp nhiều lần. Nếu một mô hình nhỏ hơn có thể thực hiện thay đổi trên một tệp một cách chính xác, thì không có lý do gì để chọn mô hình lớn hơn.
Theo thời gian, hãy bắt đầu coi việc lựa chọn mô hình giống như chọn một công cụ hơn là chọn một "người chiến thắng".
Hãy bắt đầu với một vài mô hình cả lớn và nhỏ, sau đó tìm hiểu khả năng và hạn chế của chúng thông qua việc sử dụng thường xuyên. Bạn sẽ nhanh chóng hình thành quan điểm về việc những tác vụ nào trong cơ sở mã của mình có thể được ủy quyền cho các mô hình có kích thước khác nhau.
Tiếp theo, chúng ta sẽ xem xét những nơi tốt nhất để tìm kiếm các mô hình.
Lựa chọn mô hình
Các mô hình mới được phát hành hàng tuần và có quá nhiều mô hình để bạn có thể tự mình đánh giá tất cả.
Các bảng xếp hạng (leaderboards) như The Open Frontier và Artificial Analysis rất hữu ích để khám phá những gì đang có sẵn và có cái nhìn sơ bộ về cách các mô hình so sánh với nhau về trí tuệ, khả năng lập trình, tốc độ và giá cả.
Đừng dành quá nhiều thời gian để cố gắng xác định mô hình tốt nhất duy nhất trên bảng xếp hạng. Các bài kiểm tra chuẩn (benchmarks) nén rất nhiều hành vi vào một điểm số, trong khi khối lượng công việc thực tế của bạn lại cụ thể hơn nhiều. Một mô hình xếp hạng thấp hơn một chút về tổng thể có thể lại xuất sắc trong loại công việc lập trình mà bạn thực hiện hàng ngày.
Để tham khảo, các mô hình mở phổ biến nhất hiện nay là GLM 5.3 Flash, DeepSeek V4 Flash, Kimi K3 và MiniMax M3. Tuy nhiên, danh sách này thay đổi rất nhanh chóng.
Sau khi bạn đã chọn được một vài mô hình để thử nghiệm, bước tiếp theo là tìm một nhà cung cấp lưu trữ chúng.
Bài viết được AI dịch và tổng hợp tự động từ Together AI Blog nghiên cứu và sản phẩm. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.