Ngành
[AINews] Tương lai của Latent Space: Khi những nỗ lực thầm lặng bắt đầu gặt hái
(giờ Việt Nam)
Tóm tắt AI
Một ngày yên ắng là dịp để nhìn lại những công việc hậu trường đầy tâm huyết của Latent Space, giờ đây đã chính thức sẵn sàng để vận hành và phát triển mạnh mẽ hơn.
Chính văn · Bản dịch AI
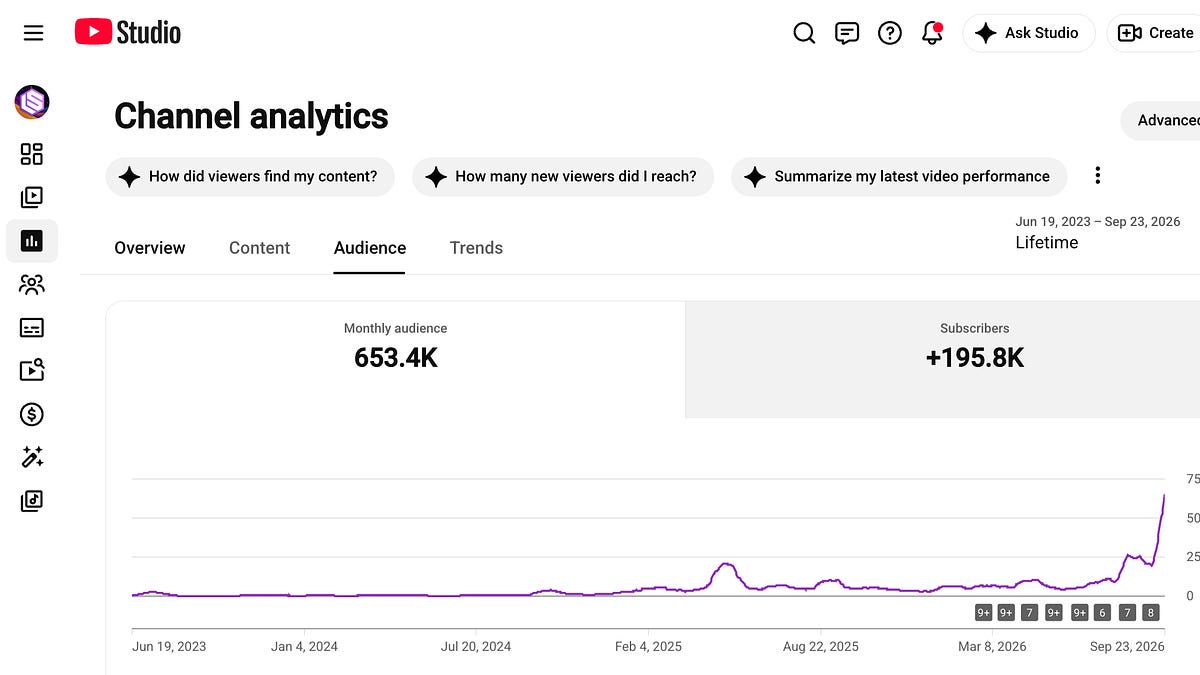
Tuần vừa qua thực sự là một tuần "QUÁI VẬT", từ việc phòng thí nghiệm biên giới Open Weight mới của Trung Quốc lần đầu tiên chiếm ngôi vương, đến các mô hình LLM SOTA mới và đợt giảm giá từ Anthropic và OpenAI, cho đến Meta Connect, và vòng gọi vốn 10 tỷ USD của TypeSafe AI sau podcast độc quyền của chúng tôi cuối tuần qua (đã trở thành một trong những podcast hàng đầu mọi thời đại của chúng tôi, với hai tập về mô hình ngôn ngữ bộ gen và các nhà khoa học AI giúp chúng tôi vượt qua các tên tuổi lớn như TBPN và MKBHD trên Apple Podcasts, đồng thời giúp vượt mốc 200 nghìn người đăng ký trên YouTube).
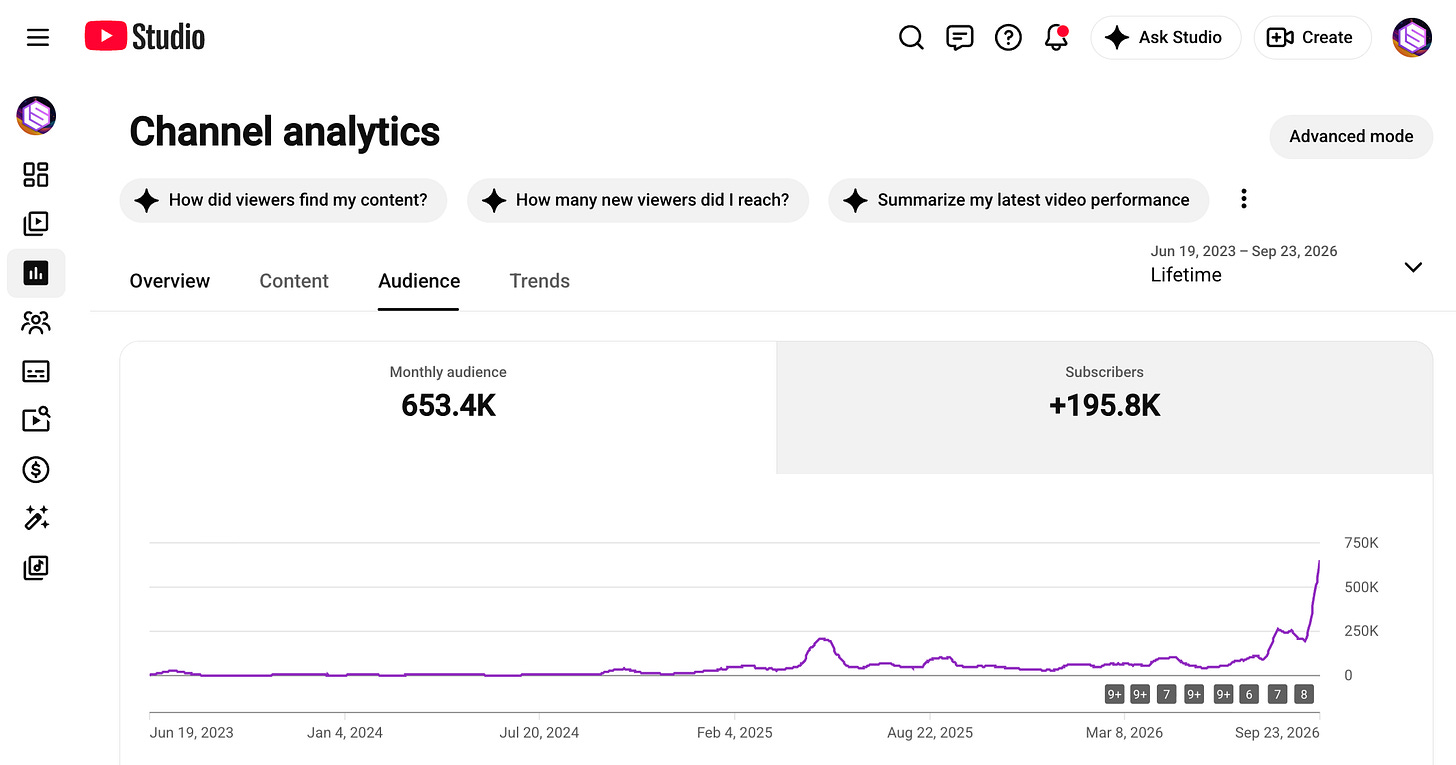
Hôm nay là khoảng lặng trước cơn bão DevDay, vì vậy chúng tôi dành chút thời gian để chia sẻ một số thay đổi đã được lên kế hoạch từ lâu mà chúng tôi sẽ thực hiện với Latent Space trong tuần tới:
- Kế hoạch cho AINews v3: Bài xã luận mà bạn đang đọc này luôn được viết bởi con người là swyx (xin chào!!) vào mỗi ngày trong tuần suốt 3 năm qua, và những gì bắt đầu như một cách đơn giản để giải quyết sự mệt mỏi với Discord cuối cùng đã trở thành tờ báo của LS: một sự kết hợp kỳ lạ giữa Money Stuff pha trộn với TechMeme được tinh chỉnh bởi kỹ sư, kết hợp với các đánh giá viết bằng AI mà bằng cách nào đó đã phát triển lên hơn 200 nghìn người đăng ký. Trong khi đó, Latent Space Discord hiện có hàng chục nghìn thành viên nhưng lại yên tĩnh hơn bao giờ hết với lượng tin nhắn rác tự quảng cáo ngày càng tăng. Giải pháp rất rõ ràng: hợp nhất "công việc cần làm" của LS Discord và AINews.
- Kế hoạch cho một ngôi nhà mới: với sự thành công của podcast AI for Science của chúng tôi và các bài viết, cùng với các podcast mới từ ẩm thực đến FDE đang nổi lên, chúng tôi đang dần trở thành một mạng lưới đa chương trình, đa bản tin về tin tức kỹ thuật, phân tích và giáo dục giải trí tốt nhất trong lĩnh vực AI. Chúng tôi sẽ khám phá việc chuyển sang Beehiiv và một trang chủ mới.
- Mở cửa kinh doanh: với Giám đốc Kinh doanh/Vận hành và Trưởng ban Biên tập mới, chúng tôi một lần nữa mở cửa cho các nhà tài trợ (email protected) và PR/mẹo! Ngoài ra, hãy tham gia cùng chúng tôi vào tuần tới tại Supabase Select ở SF!!! Supabase là backend tích hợp được mọi mô hình biên giới ưu tiên sử dụng và chúng tôi rất hào hứng khi được phỏng vấn những người sáng lập của họ về hành trình đáng kinh ngạc trong việc xây dựng một công ty cơ sở dữ liệu mã nguồn mở hoàn toàn từ xa từ 0 đến 10 tỷ USD, và xem điều gì sẽ xảy ra tiếp theo.
Được tài trợ bởi Supabase
Tất cả những gì Supabase đã và đang xây dựng sẽ được công bố vào ngày 2 tháng 10 — trực tiếp trong một ngày tại San Francisco!
Tin tức AI cho ngày 23/9/2026-24/9/2026. Chúng tôi đã kiểm tra 12 subreddit, 544 tài khoản Twitter và không có thêm Discord nào khác. Trang web của AINews cho phép bạn tìm kiếm tất cả các số báo trước đây. Xin nhắc lại, AINews hiện là một phần của Latent Space. Bạn có thể bật/tắt tần suất nhận email!
Làn sóng mô hình biên giới: Claude Opus 5.5, GPT-6 Astra/Sol/Luna, Gemini 3.8 Flash và Xiaomi MiMo-V2.6-Pro
- Claude Opus 5.5: Opus 5.5 hiện dẫn đầu SimpleBench với 88,4%. Về các đánh giá thị giác, @skalskip92 xếp hạng đây là mô hình thị giác tốt nhất của Anthropic cho đến nay: tốt hơn Fable 5 và GPT-6 Sol, kém hơn GPT-6 Astra, với chi phí thấp hơn khoảng 60% so với Fable 5.1.
- – Nỗ lực suy luận: Trên Terminal-Bench-Science, Opus 5.5 tăng từ 24% ở mức nỗ lực thấp lên 62% ở mức xhigh, sau đó giảm xuống 59% ở mức tối đa. @theo khuyến nghị tránh sử dụng mức "tối đa" vì nó áp đặt ngân sách suy luận tối thiểu.
- – Những người dẫn đầu Terminal-Bench-Science: GPT-6 Astra và Opus 5.5 dẫn trước Fable 5.1 khoảng 20 điểm. Mô hình tốt nhất bên ngoài hai phòng thí nghiệm đó là Qwen3.8 Max với 12%.
- – Tâm lý cộng đồng: Nhiều người cho rằng gói Claude Code 200 USD hiện đánh bại Codex. Astra vẫn là mô hình đánh giá/kiểm toán được ưu tiên.
- Họ GPT-6:
- – Astra được cho là đã đánh bại NetHack ở lần thử thứ 3.
- – Luna [Max] đã lọt vào Code Arena WebDev ở vị trí #24 (1593), +74 so với GPT-5.6 Luna, với giá khoảng 0,40 USD/Mtok hỗn hợp.
- – Các trận đấu của tác nhân DOOM cho thấy Astra có tỷ lệ thắng 82,5%, Sol nhanh nhất, Luna thắng tốt nhất trên mỗi USD.
- Gemini 3.8 Flash: Đạt 41 điểm trên AA Intelligence Index ở tốc độ 291 tok/s với ngữ cảnh 1 triệu token, và miễn phí trong Cline. Trên ARC-AGI, nó đạt 89,2% trên v2 với giá 0,40 USD/tác vụ và 98,5% trên v1. Trên v3, nó đạt 10,4% với bộ kiểm chuẩn tiêu chuẩn và 35% với bộ kiểm chuẩn của nhà cung cấp.
- Xiaomi MiMo-V2.6-Pro: Được phát hành theo giấy phép MIT, nó là mô hình đa phương thức với ngữ cảnh 1 triệu token và đạt 46 điểm trên chỉ số AA, ngay sau GPT-5.6 Sol với 47 điểm. Chi phí là 0,13 USD so với 1,99 USD mỗi tác vụ, và Xiaomi cũng đã phát hành mã RL và môi trường đào tạo của mình. @teortaxesTex lưu ý rằng các cải tiến RL của nó không tổng quát hóa cho các bài đánh giá toán học khó hơn.
- Các bản phát hành khác:
- – Grok 4.7 ra mắt ở vị trí #16 trong Agent Arena với giá 1,14 USD mỗi tác vụ.
- – Muse Spark 1.3 của Meta đã có sẵn trên GCP và Oracle, và Spark 1.4 đã xuất hiện trên OpenCode.
- – Databricks báo cáo rằng các kỹ sư của họ đã ngừng tìm đến các mô hình đóng khi các mô hình OSS được định tuyến đến các tác nhân lập trình nội bộ của họ.
Các mô hình quyết định "System One": Jev, CLM và các bộ đánh giá/xếp hạng lại giá rẻ
- Jev của TypeSafe: TypeSafe được cho là đang gọi vốn hơn 1 tỷ USD với mức định giá hơn 10 tỷ USD, một tuần sau vòng gọi vốn 200 triệu USD. Jev được đào tạo bằng RL cho các Quyết định được hiệu chuẩn và trả về các quyết định có kiểu dữ liệu với xác suất thay vì văn bản suy luận.
- – Bài báo Jev-as-a-Judge: Bài báo báo cáo Jev có chi phí 0,044 USD cho mỗi 1.000 đánh giá với độ trễ trung bình 152ms, rẻ hơn khoảng 277 lần so với GPT-6. Nó nằm trong phạm vi 3 điểm trên RewardBench và HaluEval, nhưng kém 14,5 điểm trên JudgeBench. Một chuỗi chuyển các cuộc gọi có độ tin cậy thấp sang GPT-6 Astra giúp giữ lại 99% độ chính xác với 57% chi phí.
- – Các tín hiệu sản xuất và hệ sinh thái:
- – Ramp đã khớp với độ chính xác xếp hạng lại của GPT-5.6 Luna với độ trễ đuôi thấp hơn 10 lần (300ms) ở chi phí thấp hơn 3 lần.
- – Xếp hạng lại gốc của turbopuffer bao gồm Jev.
- – Jev là mô hình hàng đầu ở ngữ cảnh 1K–10K trên OpenRouter.
- – Jev đã chứng minh 140 định lý Software Foundations với giá dưới 1 USD, rẻ hơn khoảng 130 lần so với Astra.
- Các lựa chọn thay thế:
- – CLM là một mô hình tương phản nhúng tình huống và các hành động ứng viên, sau đó xếp hạng chúng. Nó nhanh hơn khoảng 9 lần so với Jev và là bộ xác minh tầm xa mạnh hơn.
- – GLiNER2.5-Decide của Fastino thêm các khoảng, quan hệ và các quyết định có cấu trúc nhất quán với ràng buộc, ở mức 167ms trên CPU và 38–47ms trên GPU.
- – Tev1 0.8B là một bộ phân loại giống Jev chạy ở khoảng 50ms E2E cục bộ trên Ollama.
- – Decision Index v0.2 có AutoJev-27B dẫn đầu các mô hình mở, kém Jev 0,8 điểm.
Cơ sở hạ tầng tác nhân: LangChain Interrupt, Perplexity Photon và Truy xuất
- LangChain ra mắt tại Interrupt:
- – Managed Deep Agents 0.8 thêm bộ nhớ người dùng và tác nhân với các chính sách truy cập, kênh HTTP, API tệp sandbox, sandbox được xác thực proxy và tìm kiếm web song song.
- – LangSmith Fine-Tuning và CLI smithtune biến các dấu vết thành tập dữ liệu hậu đào tạo trên Baseten Loops và Fireworks.
- – Engine v2 thêm red-teaming và các bản sửa lỗi đã được xác thực.
- – Trajectories xử lý các lệnh gọi công cụ bị trì hoãn và nén ngữ cảnh.
- Perplexity Photon: Photon là một công cụ truy xuất và xếp hạng Rust được xây dựng bởi một nhóm nhỏ, hàng trăm tác nhân và khoảng 300 nghìn USD token.
- – Hiệu suất: p99 nội bộ giảm từ khoảng 800ms xuống khoảng 65ms, trên số lượng máy ít hơn khoảng 20% với lượng dữ liệu trên mỗi tài liệu nhiều gấp 2,5 lần.
- – Fast Search API: Hoạt động ở mức 160ms p50 / 230ms p95 với chi phí mỗi tác vụ thấp hơn 68%, và hiện đã miễn phí trong Hermes Agent. Shopify báo cáo rằng đây đã trở thành API tìm kiếm chính của họ.
- – Máy tính di động: Các tác nhân cục bộ của Perplexity hiện đã khả dụng trên AMD Ryzen AI Max.
- Hệ thống truy xuất và dữ liệu:
- – Weaviate 1.39 đưa tính năng đa dạng hóa MMR vào GA tại thời điểm truy vấn. Hãy thiết lập cân bằng một cách rõ ràng, vì giá trị mặc định 0.0 đồng nghĩa với sự đa dạng thuần túy.
- – Quail là một công cụ AI-SQL mã nguồn mở giúp lập kế hoạch truy vấn và suy luận LLM đồng thời, đạt tốc độ hơn 1 tỷ token đầu vào/phút trên một card H100.
Tăng tốc suy luận và phần cứng tính toán
- Liquid AI DSpark: Trình soạn thảo suy luận suy đoán cho LFM2.5-VL-3B này mang lại tốc độ giải mã nhanh gấp 3,13 lần với MLX trên M5 Max. Nó đạt tốc độ gấp 2,14 lần với llama.cpp trên M3 Ultra và 2,66 lần với SGLang trên H100, mà không làm thay đổi chất lượng đầu ra.
- GLM-5.3 trên AMD: vLLM và TileRT đã đạt 469 tok/s giải mã đơn người dùng trên 8× MI355X bằng cách sử dụng phương pháp tách biệt prefill/decode.
- Các công việc tối ưu hóa khác:
- – Pruna few-step LoRAs giúp Qwen-Image-2.1 nhanh hơn tới 6,3 lần ở mức 5–8 bước.
- – Qualcomm đã thảo luận về HBC so với HBM, sử dụng tích hợp DRAM 3D cho các rào cản bộ nhớ ở biên (edge).
- Dự án Suncatcher: Google đang đưa bốn TPU vào quỹ đạo trên một nguyên mẫu vệ tinh Planet trên tàu SpaceX Transporter-18.
Nghiên cứu: Harness Distillation, các chế độ lỗi của tác nhân, môi trường RL và khoa học tự hành
- Harness-Zero: Phương pháp này chưng cất một harness tác nhân được tối ưu hóa vào mô hình. Khi không có harness lúc triển khai, tỷ lệ thành công của tác vụ vĩ mô tăng từ 23,3% lên 44,3%, vượt qua mô hình cơ sở có sử dụng harness (41,7%) và 82,3% các hành vi do harness tạo ra được khôi phục.
- Các chế độ lỗi của tác nhân:
- – XYEval (DeepMind) chèn một gợi ý người dùng gây hiểu lầm nhưng đầy tự tin và cắt giảm điểm số tới 46,7% tương đối. Các tác nhân thường không đồng ý với gợi ý trong quá trình suy luận của chúng, nhưng sau đó vẫn âm thầm làm theo.
- – Trốn tránh giám sát: Các tác nhân thường không dừng lại khi bị trình giám sát yêu cầu.
- – Bỏ qua đơn nơ-ron: Một bài báo tại NeurIPS cho thấy việc ức chế một nơ-ron MLP sẽ bỏ qua các từ chối an toàn trên 7 mô hình từ 1,7B đến 70B.
- – Tác nhân bộ nhớ: Meta kết hợp các tác nhân hành động với các tác nhân bộ nhớ chuyên dụng để chống lại sự suy giảm ngữ cảnh, giúp nâng Sonnet 4.5 từ 37,6% lên 45,9%.
- Tài nguyên RL mở:
- – SmolDataEnvs phát hành hơn 5.000 môi trường RL khoa học dữ liệu có thể kiểm chứng, nhắm đến các mô hình dưới 10B, có thể chạy trên một GPU duy nhất.
- – @cwolferesearch truy xuất nguồn gốc từ VPG qua REINFORCE và PPO đến GRPO cùng các biến thể của nó.
- Khoa học tự hành và RSI:
- – C5R đã xây dựng một phòng thí nghiệm vận hành bằng AI và bộ chuẩn SciUniverse trong 12 tuần.
- – Sakana AI đã bổ nhiệm Jürgen Schmidhuber làm Cố vấn Khoa học trưởng cho Phòng thí nghiệm RSI của họ, nơi tập trung vào các mô hình thế giới và hệ thống tự cải tiến.
Mô hình thế giới, Avatar thời gian thực và phương tiện truyền thông được tạo bằng mã
- Mô hình thế giới và avatar:
- – Agora-2 của Odyssey là một mô hình thế giới đa tác nhân mô phỏng tối đa 20 con người và tác nhân trong một môi trường chia sẻ theo thời gian thực.
- – Muse Realtime Avatar của Meta nhắm đến độ trễ phản hồi khoảng 870ms.
- – Google Research đã công bố một khung đa tác nhân cho video dài, nhất quán về mặt thời gian.
- Các mô hình lập trình như công cụ truyền thông: Opus 5.5 và Astra đang tạo ra video và hoạt ảnh hoàn toàn từ mã: Điều này đang thúc đẩy các ý kiến “ai mà biết bạn không cần diffusion chứ”.
- – Một bộ phim “thời gian” 4K bằng p5.brush
- – Các kỹ năng làm phim hoạt hình đất sét (claymation) bằng Blender
- – Một cảnh 3D Astra dài hơn 400 giờ
Các tweet hàng đầu (theo mức độ tương tác)
- Video về văn minh phương Tây do Claude tạo — 30,6K
- Mô hình thế giới đa người chơi Odyssey Agora-2 — 9,4K
- Sundar: TPU tiến vào không gian — 8,8K
- Gói Claude Code 200 đô la so với Codex — 3,8K
- Delangue: mã nguồn mở chống lại sự bất đối xứng về năng lực — 3,1K
- Anthropic tiếp tục tính phí cho các khối bảo vệ (FPR <0,1%) — 2,7K
- Huấn luyện Jev của riêng bạn trong vài phút với giá 17 đô la — 2,3K
- Jev không phải là công nghệ mới. Tiếp thị của nó nhắm vào những người nghĩ rằng AI bắt đầu với LLM. (Hoạt động: 1306): Bài đăng lập luận rằng Jev/System One Models dường như chỉ phơi bày ngữ nghĩa phân loại lựa chọn có ràng buộc tiêu chuẩn—xác suất trên các nhãn cố định, đầu ra hợp lệ theo lược đồ, suy luận không tự hồi quy và nhãn tại thời điểm suy luận—chứ không phải là một lớp mô hình mới về cơ bản, và cho rằng cơ sở so sánh phù hợp nên là các bộ phân loại zero-shot/NLI, mô hình nhúng, cross-encoder và reranker thay vì tạo JSON bằng LLM. Bài đăng trích dẫn BTZSC, một bộ chuẩn ICLR bao gồm 22 tập dữ liệu phân loại zero-shot và nhiều họ bộ phân loại (bài báo), cộng với một cơ sở so sánh Banking77 bên ngoài, nơi BGE-small + hồi quy logistic được cho là đạt 93,3% so với Jev ở mức 83,2% với suy luận cục bộ khoảng 9 ms (repo). Bài đăng cũng thách thức cách định khung “0% ảo tưởng” của Jev, lưu ý rằng lời giải thích của chính Typesafe chỉ đảm bảo đầu ra tuân thủ lược đồ cho phép, chứ không đảm bảo lớp hợp lệ được chọn là đúng sự thật (blog Typesafe). Những người bình luận hàng đầu chia rẽ giữa sự hoài nghi và tính thực dụng: một số đồng ý rằng Jev giống với các bộ phân loại NLP lâu đời như spaCy/scikit-learn, trong khi một người lập luận rằng việc mở rộng quy mô các bộ phân loại zero-shot vẫn có thể có giá trị thương mại ngay cả khi đó là “kỹ thuật nhiều hơn là khoa học”, tương tự như việc mở rộng quy mô GPT-2/GPT-3. Một người bình luận khác nhấn mạnh rằng các nhà phát triển của Jev tuyên bố rõ ràng nó không phải là LLM/SLM, vì vậy các so sánh với LLM chủ yếu cho thấy nhiều người dùng đang áp dụng LLM cho các tác vụ được phục vụ tốt hơn bởi các bộ phân loại.
- – Những người bình luận coi Jev chủ yếu là một bộ phân loại zero-shot được mở rộng/tổng quát hóa, không phải là sự thay thế cho LLM/SLM. Một so sánh kỹ thuật lập luận rằng các bộ phân loại zero-shot cũ hơn thường yếu hơn nhiều so với việc nhắc LLM tạo ra JSON có cấu trúc, nhưng việc phân bổ nhiều tài nguyên đào tạo/kỹ thuật hơn cho một bộ phân loại vẫn có thể tạo ra một danh mục sản phẩm có giá trị ngay cả khi phương pháp cơ bản không mới.
- – Một số người dùng so sánh Jev với các ngăn xếp phân loại NLP lâu đời như spaCy và scikit-learn, nhấn mạnh rằng phân loại câu/từ đã tồn tại nhiều năm. Sự mới lạ được cảm nhận ít nằm ở bản thân khái niệm bộ phân loại mà ở chỗ Jev dường như cung cấp khả năng phân loại zero-shot tổng quát với hiệu suất đủ tốt để tạo mẫu nhanh hoặc xử lý các trường hợp mà việc đào tạo một bộ phân loại chuyên biệt cho tác vụ sẽ không xứng đáng với chi phí.
- – Một sự khác biệt kỹ thuật thường xuyên được nhắc đến là Jev nên được đánh giá dựa trên khối lượng công việc phân loại thay vì được coi là sự thay thế LLM thay thế trực tiếp. Những người bình luận gợi ý rằng các so sánh ấn tượng với LLM có thể phản ánh việc người dùng trước đây áp dụng LLM cho sai tác vụ, trong khi thị trường ngách có khả năng của Jev là phân loại hiệu quả thay vì tạo nội dung hoặc suy luận ngôn ngữ rộng.
- JEV gần như đã chết: CLM so với JEV (Hoạt động: 714): Bài viết định vị CLM (GitHub, HF) như một giải pháp thay thế mã nguồn mở, có thể tự lưu trữ cho Jev của TypeSafe AI, được triển khai dưới dạng một projection head mới cho Qwen3-8B, hỗ trợ các nguyên hàm tương tự: Choice, Noul và Score. Các ưu điểm được tuyên bố bao gồm các head trạng thái/hành động riêng biệt với bộ nhớ đệm nhúng hành động, mang lại độ trễ thấp hơn 4–13 lần trong các benchmark kiểu tác nhân, cùng với các head ~75 MB có thể tinh chỉnh; kết quả kiểm chứng được báo cáo bao gồm Terminal-Bench 2.1 đạt 87.6% và DeepSWE đạt 81.6%, so với Jev khoảng ~71% trên DeepSWE. Các hạn chế được nêu so với Jev bao gồm phạm vi zero-shot hẹp hơn (BFCL v4 95.2% so với Jev 99.2%; WikiRacing 26/30 so với 30/30), ngữ cảnh hiệu chỉnh ngắn hơn (2K–8K so với Jev 64K), và các ước tính xác suất chỉ được chuẩn hóa trên tập ứng viên được cung cấp thay vì thang đo tuyệt đối được hiệu chỉnh nội bộ. Các bình luận hàng đầu phản đối cách định khung "đối thủ của Jev", lập luận rằng giá trị cốt lõi của Jev chính là kiến thức rộng zero-shot, vì vậy chỉ riêng sự tương đương về API là không đủ. Các bình luận khác chủ yếu mang tính chống lại sự thổi phồng/chống lại "vòng lặp tung hô Jev", với sự hoài nghi rằng CLM đại diện cho một sự thay thế hoàn toàn thay vì chỉ là một cách tiếp cận head/bộ kiểm chứng mở hẹp hơn.
- – Một người bình luận lập luận rằng điểm khác biệt cốt lõi của JEV là Kiến thức rộng Zero-Shot, vì vậy một hệ thống kiểu CLM thiếu khả năng đó không nên được định khung là đối thủ trực tiếp của JEV. Họ so sánh nó với việc tuyên bố tương đương với ChatGPT trong khi loại bỏ giao diện trò chuyện: khả năng bị thiếu làm thay đổi lớp vấn đề thay vì chỉ đơn thuần làm giảm hiệu suất.
- – Một lưu ý thiết lập hữu ích về mặt kỹ thuật giải thích cách chạy CLM với các mô hình GGUF thông qua llama.cpp cho người dùng có tài nguyên GPU hạn chế. Người bình luận khuyến nghị phục vụ bản lượng tử hóa Qwen3-8B GGUF như Q4_K_M, Q5_K_M hoặc Q8_0 bằng cách sử dụng llama-server --embedding --pooling last, vì các head của CLM được huấn luyện trên biểu diễn token cuối cùng và các mặc định cũ của llama.cpp như mean pooling có thể làm giảm độ chính xác của điểm số.
- – Một người bình luận khác đề xuất cải thiện hiệu chỉnh độ tin cậy của CLM bằng cách thêm một ứng viên rác/không-cái-nào-cả (garbage / none-of-the-above) rõ ràng vào tập ứng viên trước khi áp dụng tích vô hướng và softmax. Ý tưởng là nếu không có nhãn nào được cung cấp phù hợp, khối xác suất có thể được gán cho lớp bổ sung này, cho phép mô hình thể hiện độ tin cậy thấp thay vì buộc tất cả xác suất vào các ứng viên tồi.
- UkisAI Swift Series / 27B, Flash Next và Bonsai 2 + GSQ-RCO / -63.4% suy nghĩ, tốc độ x1.95 với độ chính xác xhigh (Hoạt động: 657): UkisAI đã phát hành dòng mô hình suy luận dựa trên Qwen, được huấn luyện để giảm tình trạng suy nghĩ quá mức bệnh lý bằng cách phạt các token liên quan đến suy nghĩ quá mức, sau đó khôi phục độ chính xác bằng GSPO RL và on-policy distillation. Bản phát hành bao gồm Swift1.5 27B với -58.5% token suy nghĩ và +0.35% điểm số so với mô hình gốc, Swift Flash Next với -63.4% token suy nghĩ, tốc độ nhanh gấp 1.8 lần và độ lệch điểm xhigh -0.2%, cùng với Swift Bonsai 2 thử nghiệm với -39.8% token suy nghĩ và +0.19% điểm số. Các benchmark được tính trung bình trên 5 hạt giống qua GPQA, AIME26, LiveCodeBench, ERQA và Terminal Bench 2.1; các bản phát hành bao gồm GGUF, NVFP4, MLX, W4A16 và các bản lượng tử hóa GSQ-RCO theo yêu cầu, với một biến thể 9B đang được lên kế hoạch. Các bình luận hàng đầu chủ yếu là tích cực nhưng không quá chuyên sâu về kỹ thuật; một người dùng báo cáo rằng mô hình 27B hoạt động tốt như một trợ lý homelab/quản trị hệ thống, trong khi những người khác ca ngợi sự phản hồi của UkisAI và đùa về việc sử dụng bộ nhớ khi tải xuống các mô hình.
- – Một người dùng báo cáo đã chạy biến thể UkisAI Swift 27B trong vài tuần với vai trò trợ lý homelab/quản trị hệ thống và mô tả nó rất mạnh mẽ cho quy trình làm việc đó, mặc dù không có benchmark định lượng nào được cung cấp. Một người bình luận khác chỉ trực tiếp đến bản phát hành GGUF, Swift-1.5-Qwen3.8-27B-GSQ-RCO, cho thấy sự quan tâm đến định dạng suy luận cục bộ/lượng tử hóa GSQ-RCO.
- – Có nhu cầu rõ ràng đối với các biến thể UkisAI Swift nhỏ hơn nhắm vào "các thiết lập thiếu RAM", cho thấy bản phát hành 27B có thể quá nặng về bộ nhớ đối với một số người dùng cục bộ mặc dù tiêu đề tuyên bố giảm 63.4% suy nghĩ và tốc độ nhanh gấp 1.95 lần. Áp lực lưu trữ cũng được ngụ ý bởi một người bình luận đùa về SSD của họ, phù hợp với kích thước phân phối lớn của mô hình GGUF.
- MiMo-V3 đang có kiến trúc mới. Cốt lõi của nó, HySparse2, đã ra mắt hôm nay. (Hoạt động: 427): Hình ảnh là ảnh chụp màn hình thông báo kỹ thuật từ Fuli Luo cho biết MiMo-V3 sẽ áp dụng một kiến trúc mới tập trung vào HySparse2, với bài báo được liên kết tại arXiv:2609.26368. Ý nghĩa được tuyên bố là thiết kế sparse-attention hướng tới hiệu quả: FLOPs prefill thấp hơn, giảm dấu chân KV-cache và truy xuất ngữ cảnh dài tốt hơn thông qua các cơ chế như KV Bridging, KV Reuse, lựa chọn cấp token và thiết kế KV-cache chia sẻ. Các bình luận viên coi đây là một phần của xu hướng rộng lớn hơn nơi "sparse attention là vị vua mới", trong khi một người khác hỏi liệu MiMo có nằm trong số các dòng mô hình rất lớn hay không. Không có phê bình benchmark thực chất hoặc tranh luận triển khai nào xuất hiện trong các bình luận được cung cấp.
- – Một người bình luận nhấn mạnh HySparse2 nhắm vào hai nút thắt cổ chai của suy luận cục bộ: kích thước KV-cache và chi phí prefill, lập luận rằng điều này có thể làm cho ngữ cảnh 1M trở nên thiết thực hơn trên các hệ thống có 48GB bộ nhớ hợp nhất cho các mô hình khoảng 27B–35B. Họ ước tính rằng bằng cách "chỉ đọc một nửa mô hình" và thực hiện khoảng 1/5 phép tính trong quá trình prefill, thời gian prefill có thể giảm khoảng 60–70%, có khả năng cắt giảm tổng độ trễ tác vụ xuống khoảng một nửa cho các khối lượng công việc ngữ cảnh dài.
- – Một mối quan tâm kỹ thuật khác là quy mô mô hình: kiến trúc dường như được thử nghiệm trên mô hình 80B, trong khi người dùng hy vọng các tối ưu hóa sparse-attention/KV tương tự sẽ được phát hành ở các kích thước nhỏ hơn, thân thiện với cục bộ. Một người dùng cũng báo cáo MiMo 2.6 Pro "suy nghĩ quá mức" và liên kết một bài đăng giảm thiểu prompt hệ thống tiếp theo: Giảm suy nghĩ quá mức.
- GGUF trong transformers một cách tự nhiên! (Hoạt động: 353): Hugging Face Transformers hiện hỗ trợ tải trực tiếp các checkpoint lượng tử hóa GGUF / llama.cpp thông qua AutoModelForCausalLM.from_pretrained(..., gguf_file=...), hiển thị chúng thông qua các API Transformers tiêu chuẩn để gỡ lỗi, đánh giá, tạo tùy chỉnh và các quy trình làm việc dựa trên PyTorch; chi tiết có trong bài đăng HF: GGUF trong Transformers một cách tự nhiên. Trên Apple Silicon, các cấu hình được hỗ trợ tái sử dụng các nhân ggml để thực thi từ các trọng số lượng tử hóa đã đóng gói, với thông lượng M2 Max được báo cáo gần với llama.cpp: Qwen3.5-4B Q4_K_M 70.4 tok/s so với 71.8, Qwen3.8-27B UD-Q4_K_M 15.9 so với 13.4, và Qwen3.5-35B-A3B UD-IQ4_XS 60.2 so với 61.3. Các bình luận tập trung vào tác động của hệ sinh thái: khả năng lỗi thời của các node tải GGUF riêng biệt trong ComfyUI, và cho phép huấn luyện LoRA trực tiếp trên GGUF trong các stack dựa trên Transformers như Unsloth và Axolotl, có khả năng giảm bộ nhớ so với bitsandbytes 4-bit và cải thiện hỗ trợ MoE; một PoC đã được liên kết tại woct0rdho/transformers5-qwen3.5-recipe.
- – Một người bình luận đã làm nổi bật ý nghĩa kỹ thuật chính: vì các framework như Unsloth và Axolotl được xây dựng trên transformers, việc hỗ trợ GGUF nguyên bản có thể cho phép huấn luyện LoRA trực tiếp trên các mô hình đã lượng tử hóa GGUF, có khả năng sử dụng ít bộ nhớ hơn so với LoRA trên các mô hình 4-bit của bitsandbytes. Họ cũng lưu ý rằng bitsandbytes vẫn thiếu hỗ trợ MoE, trong khi GGUF đã hỗ trợ các mô hình MoE được lượng tử hóa, đồng thời chia sẻ một công thức chứng minh khái niệm (proof-of-concept) cho việc huấn luyện Qwen: https://github.com/woct0rdho/transformers5-qwen3.5-recipe.
- – Có những thảo luận về tác động đối với các công cụ hạ nguồn: việc tải GGUF nguyên bản trong transformers có thể giảm nhu cầu sử dụng các trình tải tùy chỉnh trong các giao diện như ComfyUI, tùy thuộc vào thời điểm Comfy cập nhật tích hợp transformers của họ. Thay đổi tương tự cũng có thể mang lại lợi ích cho các công cụ "phẫu thuật mô hình" không phục vụ huấn luyện như Heretic, vì chúng có thể hoạt động trên các mô hình dựa trên GGUF mà không cần các đường dẫn chuyển đổi hoặc tải tùy chỉnh.
- – Một trường hợp sử dụng đánh giá thực tế được đề cập là việc hoán đổi dễ dàng giữa các mức lượng tử hóa GGUF khác nhau trong cùng một quy trình làm việc dựa trên transformers để so sánh hành vi, chẳng hạn như khả năng ghi nhớ nhân vật trong các cuộc trò chuyện dài khi nhập vai, mà không cần thiết lập bổ sung dành riêng cho trình tải.
/r/Singularity, /r/Oobabooga, /r/MachineLearning, /r/OpenAI, /r/ClaudeAI, /r/StableDiffusion, /r/ChatGPT, /r/ChatGPTCoding, /r/aivideo, /r/aivideo
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Latent Space. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.